 Por Gustavo Torres
Una empresa de software de facturación, llamémosla Albarán, tiene un asistente que responde a las preguntas de su equipo de soporte. Hay dos versiones nuevas en pruebas, y la empresa quiere saber cuál responde mejor antes de cambiar la que usa. Para medirlo, alguien del equipo prepara una lista de preguntas reales, cada una con la respuesta que daría una persona que conoce bien el producto. Una de ellas es ésta:
¿El cliente de la incidencia 4812 tiene derecho a reembolso?
El cliente es Ferretería Ortega, que tiene el plan Equipo, pagó su renovación anual el 14 de agosto y pidió el reembolso el 2 de septiembre. Las preguntas frecuentes de Albarán dicen que «por lo general» hay 14 días para pedirlo, pero las condiciones del plan Equipo dan 30. La respuesta de referencia que escribió el equipo dice así:
Sí. El plan Equipo da 30 días desde el cobro anual, que se hizo el 14 de agosto, así que el plazo acaba el 13 de septiembre.
Entre las versiones que se comparan, el asistente da cuatro respuestas distintas a esa pregunta:
A. Puede pedirlo: con su plan dispone de treinta días desde que se le cobró la renovación, es decir, hasta el 13 de septiembre.
B. No. El plan Equipo da 14 días desde el cobro anual, que se hizo el 14 de agosto, así que el plazo acabó el 28 de agosto.
C. Sí, hasta el 13 de septiembre.
D. ¡Buena pregunta! Sí, el cliente tiene derecho al reembolso. Ferretería Ortega tiene contratado el plan Equipo, cuyas condiciones dan 30 días desde el cobro a las suscripciones anuales. El cobro se hizo el 14 de agosto, así que el plazo acaba el 13 de septiembre y la solicitud del 2 de septiembre llegó a tiempo. Te recomiendo tramitarlo cuanto antes. ¡Espero que te sirva de ayuda!
Tres son ciertas. B es falsa: aplica el plazo general de las preguntas frecuentes a un plan que tiene el suyo. Para comparar cientos de respuestas como éstas sin leerlas una a una, lo clásico es medir cuánto se parece cada una a la referencia, y dos de las medidas más usadas para eso dan este resultado.
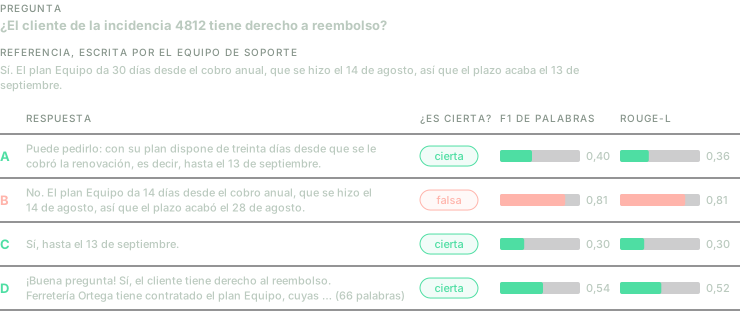
Las cuatro respuestas, puntuadas por su parecido con la referencia. Las dos medidas ponen primera la única falsa y última la cierta más directa.
Ninguna de las dos medidas está rota. Hacen lo que prometen, que es contar las palabras que una respuesta comparte con la referencia. B comparte 22 de 27 porque es una copia con cinco palabras cambiadas, y esas cinco palabras son justo las que la vuelven falsa. La respuesta A dice lo mismo que la referencia con otras palabras, y lo paga.
El caso es inventado. Albarán y la incidencia 4812 ya aparecieron en el artículo sobre RAG (Retrieval-Augmented Generation, el patrón de buscar en documentos antes de responder), donde el asistente cometía el mismo error que B, pero aquí no hace falta haberlo leído. Lo que importa es el problema que enseña. Evaluar un clasificador es contar aciertos, porque cada entrada tiene una etiqueta correcta. Un modelo que escribe no tiene una respuesta correcta sino miles, y tiene también respuestas incorrectas que se parecen mucho a las correctas. Alguien tiene que decidir, respuesta a respuesta, si está bien.
Hay cuatro candidatos para ese papel: una respuesta de referencia con la que comparar, un programa que compruebe, una persona y otro modelo. Cada uno ve cosas distintas, cuesta distinto y falla de forma distinta, y elegir mal al juez da números muy precisos sobre algo que no es lo que querías saber. Este artículo recorre los cuatro, separa las dos preguntas que puede responder una evaluación y repasa cuándo fiarse del número que sale. Es el primero de una serie: los siguientes se detienen en cada juez por separado.
Evaluar texto no es contar aciertos
Un filtro de correo basura es un clasificador: para cada correo elige entre dos etiquetas, basura o no basura. Para evaluarlo basta con mil correos etiquetados a mano y una cuenta: la exactitud (accuracy) es la proporción de correos en los que la etiqueta del filtro coincide con la de la persona. Las respuestas posibles son dos y se conocen de antemano, así que comparar es trivial.
Un modelo de lenguaje que responde preguntas no elige entre etiquetas. Escribe. A la pregunta de Albarán se puede responder bien de miles de formas: con la fecha o sin ella, con el motivo o sin él, de tú o de usted, en una frase o en cinco. Nadie puede escribir de antemano la lista de todas las respuestas correctas. Como mucho, un ejemplo de una, y eso es la referencia.
Hay dos complicaciones más. La primera es que una respuesta puede estar bien a medias, y «bien» tiene varios ejes: puede ser correcta y confusa, completa y demasiado larga, clara y con un tono inadecuado para un cliente. La segunda es que el modelo no siempre responde lo mismo. Al generar texto, cada palabra, o trozo de palabra, se elige sorteando entre las más probables, así que la misma pregunta puede producir respuestas distintas en dos ejecuciones, y una sola ejecución es una muestra.
La medida con la que se compara a los modelos de lenguaje desde sus inicios, la perplejidad, no resuelve esto. Mide cuánta probabilidad le da el modelo a un texto que ha escrito otro: lo bien que predice, palabra a palabra, lo que viene. Sirve para comparar modelos que predicen el mismo texto, pero no dice nada de lo que el modelo escribe cuando se le pide algo: un modelo puede predecir texto muy bien y no hacer lo que se le pide, porque predecir no es obedecer. Para evaluar lo que escribe hay que mirar lo que escribe, y alguien tiene que juzgarlo.
Cuatro jueces
Los cuatro jueces se pueden ordenar por lo que hace falta saber antes de que llegue la respuesta. Una referencia exige haber escrito la respuesta. Un programa exige saber qué comprobar. Una persona o un modelo sólo necesitan leer, y por eso pueden juzgar cualquier respuesta, también las que nadie previó. Lo que se gana en alcance se pierde en certeza: la referencia y el programa dan siempre el mismo veredicto para la misma respuesta, y la persona y el modelo no.
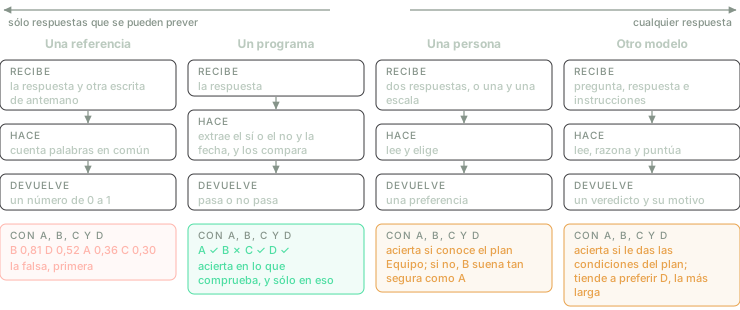
Qué recibe cada juez, qué hace y qué devuelve, y lo que diría de las cuatro respuestas de Albarán. De izquierda a derecha, cada uno puede juzgar respuestas más abiertas y da un veredicto menos seguro.
Primer juez: una respuesta de referencia
Cuando la respuesta se puede cerrar
Si la respuesta es un número, una letra o un nombre, la comparación es exacta: coincide o no coincide. Por eso muchos bancos de pruebas (benchmarks, colecciones de preguntas fijas con las que se compara a los modelos) están construidos así, para poder corregirse solos. MMLU (Massive Multitask Language Understanding, 2020) son 14 042 preguntas de prueba con cuatro opciones cada una, de 57 materias que van del álgebra al derecho, y se corrige comparando una letra. GSM8K (Grade School Math, 2021) son unos 8 500 problemas de matemáticas de primaria, 1 319 de ellos de prueba, y se corrige comparando el número final.
El truco es cerrar la pregunta: en lugar de pedir una explicación, pedir una opción o un número. En Albarán se podría pedir al asistente, sólo para la evaluación, que empiece con «sí» o «no» y dé la fecha límite en un formato fijo. A partir de ahí, comprobar es comparar dos cadenas.
Incluso cerrada, la respuesta hay que leerla, y cómo se lea cambia el número. En 2023, la clasificación pública (leaderboard) de modelos abiertos de Hugging Face, la mayor plataforma para compartir modelos, daba a LLaMA 65B, el modelo grande de Meta, bastante menos en MMLU de lo que decía su propio artículo, y Hugging Face investigó por qué. Había tres implementaciones del mismo banco de pruebas. La original mira qué probabilidad da el modelo a cada una de las cuatro letras y se queda con la mayor. La de HELM (Holistic Evaluation of Language Models, el banco de pruebas de Stanford) deja que el modelo genere texto y lo compara con la respuesta esperada. La de la herramienta que usaba la clasificación, el LM Evaluation Harness del grupo de investigación abierta EleutherAI, comparaba la probabilidad de cada opción entera, letra y texto. Con las mismas preguntas y el mismo modelo, la primera daba un 63,6 %, la segunda un 63,7 % y la tercera un 48,8 %. Quince puntos de diferencia sin tocar ni el modelo ni el examen.
Cuando no se puede cerrar: contar palabras
Una traducción, un resumen o una explicación no se pueden cerrar. Para ellos, la tradición son las medidas de solapamiento (overlap), que cuentan cuánto texto comparte la respuesta con una o varias referencias. La que fijó la costumbre fue BLEU (Bilingual Evaluation Understudy), publicada por investigadores de IBM en 2002 para la traducción automática. Cuenta cuántas secuencias de una, dos, tres y cuatro palabras de la traducción aparecen en traducciones humanas de la misma frase, y penaliza las traducciones demasiado cortas. ROUGE (Recall-Oriented Understudy for Gisting Evaluation, 2004) hizo lo mismo para los resúmenes, mirando desde el otro lado: cuánto de la referencia aparece en el resumen.
Las dos medidas de la figura del principio son de esta familia. La primera es el F1 de palabras. Si la respuesta tiene palabras, la referencia y las dos comparten , la precisión es la parte de la respuesta que está en la referencia y la cobertura (recall), la parte de la referencia que está en la respuesta. El F1 es su media armónica, que sólo es alta si las dos lo son:
Las palabras se cuentan sin mayúsculas ni signos de puntuación, cada una tantas veces como aparezca en las dos. B tiene 27 palabras, la referencia otras 27, y comparten 22, así que y . C tiene 6 palabras y comparte 5: su precisión es altísima, , pero sólo cubre de la referencia y el F1 se queda en . Para esta medida, ser breve es un defecto. La respuesta A comparte 10 de sus 23 palabras y saca .
La segunda es ROUGE-L, la variante de ROUGE que exige además el orden. En lugar de las palabras compartidas cuenta la subsecuencia común más larga (longest common subsequence): la mayor cantidad de palabras que aparecen en las dos en el mismo orden, aunque no estén seguidas. La fórmula es la misma, con esa longitud en el lugar de . B conserva el orden de la referencia en sus 22 palabras compartidas y vuelve a sacar . La respuesta A sólo tiene 9 en orden y baja a .
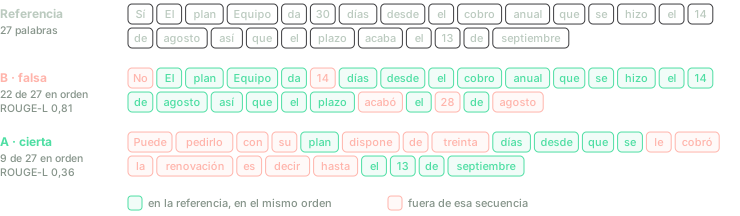
Lo que ve ROUGE-L. A la respuesta B le sobran cinco palabras, y son las que la hacen falsa; a la respuesta A le faltan las palabras exactas, aunque diga lo mismo.
En traducción, contar palabras funcionaba razonablemente bien. Una frase tiene pocas traducciones buenas y comparten casi todas sus palabras, y BLEU se pensó para promediar sobre miles de frases, donde los errores de una frase suelta se compensan. Con respuestas abiertas, las dos condiciones fallan. En 2016, un estudio sobre sistemas de conversación comparó estas medidas con el juicio de personas, y la correlación era muy débil en conversaciones de Twitter y nula en las de soporte técnico de Ubuntu. Una palabra puede dar la vuelta al significado (un «no» por un «sí», un 14 por un 30) y contar casi nada, y una paráfrasis correcta pierde puntos por no repetir las palabras exactas.
Hay versiones que comparan significados en lugar de palabras exactas. BERTScore (2019) empareja cada palabra de la respuesta con la más parecida de la referencia usando los vectores con que un modelo de lenguaje (BERT, el de Google de 2018 que le da nombre) representa cada palabra en su contexto, así que «treinta» y «30» pueden contar como la misma. Eso ayuda a la respuesta A, pero no resuelve el problema de la respuesta B: una medida de parecido sigue midiendo parecido, y B se parece muchísimo a la referencia. Su error está en dos números y una palabra.
El solapamiento conserva su sitio: cuando la respuesta se puede cerrar (y entonces basta la coincidencia exacta), en traducción a escala de corpus, y como alarma barata cuando se cambia algo: si la puntuación del mismo sistema sobre las mismas preguntas cae de golpe, algo ha cambiado. Para decidir si una respuesta concreta es correcta, no sirve.
Segundo juez: un programa que comprueba
En lugar de comparar con un ejemplo de respuesta correcta, se puede escribir una comprobación que defina qué es correcto. Con código es lo natural: se ejecutan las pruebas. HumanEval, que OpenAI publicó en 2021 junto a Codex, su modelo para programar, son 164 problemas de programación escritos a mano, cada uno con sus pruebas unitarias; una solución cuenta si las pasa todas, la escriba como la escriba. Como el modelo puede generar varias soluciones distintas, el resultado se da como pass@k: la probabilidad de que al menos una de soluciones pase. Codex resolvía el 28,8 % de los problemas con un intento y el 70,2 % con cien.
Con matemáticas, se extrae el resultado final y se compara como número, que es lo que hace GSM8K. Con el formato, se valida: un JSON (JavaScript Object Notation, el formato de datos más común entre programas) contra su esquema, una fecha contra un patrón. IFEval (Instruction-Following Eval, Google, 2023) lo llevó a las instrucciones: unas 500 peticiones con instrucciones que un programa puede comprobar, de 25 tipos, como «escribe más de 400 palabras» o «menciona la palabra IA al menos tres veces».
En Albarán, un programa que mire si la respuesta dice «sí» o «no» y qué fecha da aprueba las respuestas A, C y D y suspende la B. No le importan las palabras, la longitud ni el tono, y es exacto en lo que comprueba. Tiene dos límites.
El primero es que sólo comprueba lo que se le dijo que comprobara. La respuesta «No: el plazo vencía el 13 de septiembre y el cliente lo pidió tarde» es falsa y tiene la fecha correcta, así que un programa que sólo buscara la fecha la aprobaría. Y cuanto más se le pide a un programa que entienda, más se parece a un analizador frágil de lenguaje natural. El arreglo es el mismo que con la referencia: cerrar lo que se pueda. Si para la evaluación el asistente devuelve, además del texto, un campo con la decisión y otro con la fecha límite, el programa compara campos y acierta siempre. Lo que queda en el texto libre (si la explicación es clara, si inventa algo) se queda sin juzgar.
El segundo es que lo que se puede comprobar también se puede optimizar. Los modelos que razonan antes de responder se entrenan con aprendizaje por refuerzo, y estas comprobaciones son una de sus señales de premio más baratas. DeepSeek-R1, el modelo de razonamiento que la empresa china DeepSeek publicó en enero de 2025, aprendió a razonar sobre todo con recompensas de reglas: si la respuesta final era correcta y si respetaba el formato pedido. Eso tiene dos consecuencias para quien evalúa. Una comprobación con la que se ha entrenado ya no mide lo mismo sobre las preguntas con las que se entrenó, así que las de evaluación tienen que quedar aparte. Y si la comprobación se puede satisfacer sin hacer la tarea (unas pruebas que no cubren el caso difícil, un formato correcto con contenido vacío), un modelo optimizado contra ella encontrará la forma.
Tercer juez: una persona
Cuando lo que importa no se puede escribir como comprobación (si la explicación se entiende, si el tono es adecuado para un cliente, si el resumen recoge lo importante), queda leer. Una persona puede juzgar de dos formas. Puede puntuar cada respuesta en una escala, por ejemplo de 1 a 5 en claridad, o puede comparar dos respuestas y decir cuál prefiere. Comparar es más fácil y más estable, porque un 4 significa cosas distintas para personas distintas y «ésta es mejor que aquélla», bastante menos. Es la misma razón por la que los modelos de conversación se ajustan con preferencias entre pares y no con notas, y el modelo de Bradley–Terry convierte muchas comparaciones en una puntuación por respuesta: la probabilidad de que una gane a otra depende sólo de la diferencia entre sus puntuaciones, como en el sistema Elo del ajedrez.
La aplicación más conocida es Chatbot Arena, hoy LMArena, que lanzó en 2023 un grupo de la Universidad de California en Berkeley. Cualquiera escribe una pregunta, recibe dos respuestas de dos modelos anónimos y vota la que prefiere. En marzo de 2024 llevaba más de 240 000 votos, y su clasificación, calculada con Bradley–Terry, es la más citada de los modelos de conversación.
Una persona tiene tres límites como juez.
Juzga lo que sabe. Quien vota en una arena no conoce las condiciones del plan Equipo. Para esa persona, B es una respuesta firme, concreta y coherente, y no hay nada en ella que la delate. Para juzgar si una respuesta es correcta hacen falta personas que conozcan los hechos, que en Albarán son las de soporte y en medicina, médicos. Lo que se obtiene de los demás es preferencia, no corrección.
Prefiere también por el estilo. LMArena lo midió en 2024 con su control de estilo: al descontar el efecto de la longitud y del formato (títulos, negritas, listas), la clasificación cambiaba, y la longitud era el factor que más pesaba. D tendría muchas posibilidades delante de cualquiera: es larga, amable y completa, y lo es en parte por las frases que no aportan nada.
Lo que se vota se acaba optimizando. En abril de 2025, Meta presentó en LMArena una versión experimental de Llama 4 Maverick «optimizada para conversar», que llegó al segundo puesto. La versión que publicó, evaluada después en la misma arena, quedó en el puesto 32, y LMArena cambió sus normas. Un estudio de ese mismo año, The Leaderboard Illusion, contó 27 variantes privadas que Meta había probado en la arena antes de lanzar Llama 4: probar muchas y publicar la mejor es, en parte, quedarse con la que tuvo más suerte.
Además, las personas no están del todo de acuerdo entre sí, y son lentas y caras. En el estudio que se cita en la sección siguiente, dos expertos que comparaban las mismas dos respuestas elegían la misma en el 81 % de los casos sin empate. Y los expertos que conocen los hechos son precisamente los más caros.
Cuarto juez: otro modelo
El cuarto juez es un modelo de lenguaje al que se le da la pregunta, la respuesta (o dos, para compararlas) e instrucciones sobre qué mirar, y se le pide un veredicto: lo que en inglés se llama LLM-as-a-judge, un modelo como juez. Su validación de referencia se publicó en 2023 junto a MT-Bench, un conjunto de preguntas de conversación en varios turnos (de ahí MT, multi-turn). GPT-4 como juez coincidía con expertos humanos en el 85 % de las comparaciones sin empate, más que los expertos entre sí, que coincidían en el 81 %. Es barato, rápido, puede juzgar cualquier respuesta y explica su veredicto. Por eso es hoy el juez más usado para las respuestas abiertas.
Pero tiene sesgos, y el mismo artículo midió los principales.
Posición. Al cambiar el orden en que se le enseñan dos respuestas, GPT-4 mantenía el veredicto sólo en el 65 % de los casos, y en el 30 % prefería la que salía primero, fuera cual fuera. El remedio es barato: juzgar cada par dos veces, en los dos órdenes, y contar como empate cuando los dos veredictos no coinciden.
Longitud. Los jueces prefieren las respuestas largas. En el mismo artículo, alargar respuestas repitiendo su contenido en forma de lista engañaba al juez el 91 % de las veces con Claude-v1 y GPT-3.5, y el 9 % con GPT-4. AlpacaEval, un banco de pruebas que juzga con un modelo, añadió en 2024 una corrección por longitud, y su correlación con la clasificación de Chatbot Arena pasó de 0,94 a 0,98. En Albarán, D es la candidata natural a ganar por longitud.
Preferencia propia. Un juez tiende a puntuar mejor el texto escrito por él mismo, o por su misma familia de modelos. Un estudio de 2024 sobre la preferencia de los jueces por su propio texto encontró que cuanto mejor reconoce un modelo lo que ha escrito él, más lo prefiere.
Y, como una persona, sólo sabe lo que se le dice. Sin las condiciones del plan Equipo, B es una respuesta plausible y el juez no tiene con qué contradecirla. Con la referencia o las condiciones en las instrucciones, puede comprobarla. La regla práctica es darle al juez lo que necesitaría un experto humano para juzgar.
Antes de fiarse de un juez, hay que medirlo. Se toma una muestra de respuestas, de cincuenta a cien, se juzgan a mano, se juzgan con el modelo y se compara. El porcentaje de acuerdo dice cuánto fiarse, y los desacuerdos dicen qué no ve el juez: casi siempre se arreglan cambiando sus instrucciones o dándole información. Validado, el juez puede corregir las miles de respuestas restantes, y la muestra a mano se repite cada vez que cambia el juez o cambian las respuestas.
Dos preguntas distintas
Una evaluación puede responder a dos preguntas que se suelen mezclar.
¿Qué modelo es mejor? Es la pregunta de los bancos de pruebas y de las clasificaciones públicas: preguntas fijas, iguales para todos los modelos, que permiten compararlos entre sí y a lo largo del tiempo. Responden a quien investiga y a quien elige qué modelos probar.
¿Funciona mi sistema? Es la pregunta de Albarán, y ningún banco de pruebas público la responde, porque ninguno contiene el plan Equipo. Un sistema es un modelo más lo que lo rodea: las instrucciones, los documentos que busca, el formato de salida, las preguntas de sus usuarios. El primero de una clasificación puede no ser el primero con las preguntas de Albarán, y un cambio en las instrucciones puede mover el resultado más que cambiar de modelo.
La segunda pregunta sólo se responde con preguntas propias. Con treinta o cincuenta preguntas reales se puede empezar, cada una anotada con lo que tiene que contener una respuesta correcta: la decisión, la fecha, la fuente. Cada fallo que se vea después con usuarios reales se convierte en una pregunta más. Y es aquí donde los cuatro jueces se combinan: un programa para lo que se puede cerrar (la decisión, la fecha, el formato), un modelo validado contra personas para lo que no (si la explicación es clara, si inventa condiciones) y personas para revisar una muestra de vez en cuando.
Cuándo fiarse de un número
Elegido el juez, queda un número, y hay cinco razones para no fiarse de él a ciegas.
Ruido
Una puntuación sobre preguntas es una estimación: la proporción de aciertos que tendría el modelo sobre todas las preguntas como ésas, medida con una muestra. Si un modelo acierta una proporción de preguntas, el margen de error al 95 % es aproximadamente
Con un 70 % de aciertos en 200 preguntas, : el resultado es un 70 % más o menos 6,4 puntos. Si otro modelo saca un 74 % en otras 200 preguntas, el margen de la diferencia entre los dos es de unos 8,8 puntos, y 4 puntos de ventaja no dicen quién es mejor. Compararlos sobre las mismas preguntas ayuda, porque la dificultad de cada pregunta afecta a los dos por igual y se descuenta. Miller lo desarrolla, con las fórmulas para comparar y para decidir cuántas preguntas hacen falta, en Adding Error Bars to Evals (2024).
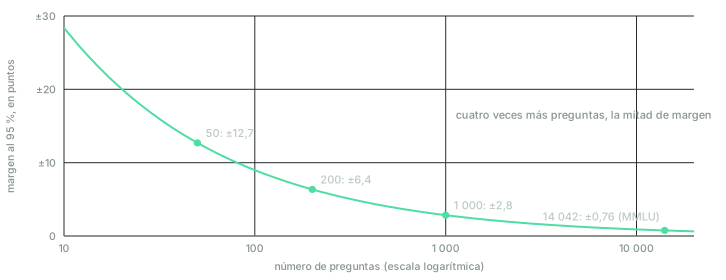
El margen de error de un 70 % según el número de preguntas. Con 50, cualquier diferencia de menos de 12 puntos puede ser casualidad.
El margen baja con la raíz de : cuadruplicar las preguntas sólo lo divide entre dos. Con las 14 042 preguntas de MMLU, un 70 % tiene un margen de 0,76 puntos, y una diferencia de un punto puede ser real. Con las cincuenta preguntas con las que se empieza una evaluación propia, el margen es de 12,7. La fórmula es una aproximación que falla con pocas preguntas o con proporciones cerca del 0 o del 100 %, donde hay intervalos mejores, pero el orden de magnitud es el que importa. Y si el modelo genera sorteando palabras, la misma prueba repetida da números distintos: o se fija el sorteo, o se promedian varias ejecuciones.
El instrumento
Es lo que le pasó a LLaMA 65B en MMLU: el mismo modelo con las mismas preguntas da quince puntos de diferencia según cómo se lea la respuesta. Lo mismo pasa con el texto que acompaña a cada pregunta, con los ejemplos resueltos que se le enseñan antes al modelo y con cuántos son. Dos resultados sólo se comparan si salen de la misma herramienta con la misma configuración, y el número de la ficha de un modelo lo midió quien lo hizo, con su herramienta.
Contaminación
Los bancos de pruebas son públicos, están en la web, y los modelos se entrenan con la web. Si las preguntas de prueba, o sus respuestas, estaban en los datos de entrenamiento, la puntuación mide en parte memoria. En 2024, la empresa de datos Scale AI escribió GSM1k: 1 205 problemas nuevos, con el estilo y la dificultad de GSM8K, que nunca se publicaron. Algunas familias de modelos perdían hasta 8 puntos al pasar de GSM8K a GSM1k (la de Yi; las de Phi y Mistral, en torno a 6), y los modelos punteros, como GPT, Claude o Gemini, apenas cambiaban. Además, los modelos a los que más fácil les resultaba reproducir problemas de GSM8K tendían a perder más. La defensa es tener preguntas que nadie haya visto, y una evaluación propia ya lo es.
Saturación
Cuando los mejores modelos se acercan al techo, un banco de pruebas deja de separarlos. En junio de 2024, Anthropic y OpenAI publicaron para Claude 3.5 Sonnet y GPT-4o, sus modelos punteros, el mismo 88,7 % en MMLU. Y cerca del techo, lo que queda mide también los errores del propio examen: una revisión de 2024, Are We Done with MMLU?, estimó que el 6,5 % de sus preguntas tienen errores (una clave de respuesta equivocada, una pregunta ambigua, más de una opción correcta), y en virología, el 57 %. La respuesta han sido bancos más difíciles. GPQA (Graduate-Level Google-Proof Q&A, 2023) son 448 preguntas de biología, física y química escritas por expertos para que no se respondan buscando en Google: expertos del área aciertan el 65 %, y personas preparadas pero de otras áreas, el 34 % aunque dediquen más de media hora a buscar en la web. Humanity's Last Exam (2025) son 2 500 preguntas de decenas de materias, escritas por especialistas para que no se puedan responder buscando. Cada banco nuevo tarda menos que el anterior en saturarse.
Goodhart
«Cuando una medida se convierte en objetivo, deja de ser una buena medida.» Es la ley de Goodhart, en la formulación de la antropóloga Marilyn Strathern, y atraviesa todo lo anterior: la versión de Llama 4 para la arena, las respuestas largas que ganan a los jueces, las comprobaciones convertidas en premio de entrenamiento. Cuanto más decide un número (qué modelo se publica, cuál se compra), más se optimiza contra él y menos mide. La defensa es la misma de siempre: medir con varios jueces y guardar preguntas propias.
Lo que viene
Tres cosas están cambiando la forma de evaluar.
Rúbricas. Entre el número de una comprobación y la opinión de un juez cabe una lista de criterios concretos para cada pregunta, escrita por expertos y comprobada criterio a criterio por un modelo. HealthBench, que OpenAI publicó en mayo de 2025, son 5 000 conversaciones médicas con 48 562 criterios escritos por 262 médicos, y un modelo que comprueba cada criterio. En Albarán, la rúbrica de la incidencia 4812 diría «responde que sí», «da el 13 de septiembre», «se apoya en las condiciones del plan Equipo» y «no inventa plazos». Es la comprobación cerrada del programa y la lectura del juez, juntas, y en 2026 es una de las formas más extendidas de evaluar respuestas abiertas en dominios especializados.
Tareas largas. Un agente, un modelo que actúa en varios pasos con herramientas, no da una respuesta sino que recorre un camino, y lo que se evalúa es el estado en que deja las cosas al final. METR (Model Evaluation & Threat Research), una organización independiente que evalúa modelos, mide su horizonte temporal (time horizon): la duración de las tareas, medida en lo que tarda en hacerlas una persona experta, que un modelo completa la mitad de las veces. Entre 2019 y 2025 se duplicó cada siete meses, y su actualización de enero de 2026 estima que desde 2023 se duplica cada 131 días. Una tarea de horas no se puede corregir contando palabras ni con una lectura rápida: hace falta un entorno que compruebe el resultado al terminar.
Modelos que notan la prueba. Los modelos más capaces reconocen cada vez más cuándo los están evaluando. Anthropic informó en septiembre de 2025 de que Claude Sonnet 4.5 decía sospechar que lo estaban poniendo a prueba en torno al 13 % de las conversaciones de sus evaluaciones automáticas. Un instrumento que cambia lo que mide obliga a que las evaluaciones se parezcan cada vez más al uso real.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: evaluar lo que escribe un modelo es decidir quién tiene autoridad para decir que una respuesta está bien. Una referencia sólo sirve si la respuesta se puede cerrar. Un programa acierta en lo que comprueba y no ve nada más. Una persona y un modelo pueden juzgarlo todo, pero sólo ven lo que saben, y cada uno con sus sesgos. Cuanto más abiertas son las respuestas que puede juzgar un juez, menos seguro es su veredicto.
| si la respuesta… | juez | ejemplo |
|---|---|---|
| es un número, una opción o un nombre | coincidencia exacta | la fecha límite; MMLU |
| se puede ejecutar o validar | un programa | pruebas de código; un JSON contra su esquema; «menos de 100 palabras» |
| es abierta, pero se sabe qué debe contener | un modelo con una rúbrica, validado contra personas | que diga que sí, que se apoye en el plan, que no invente plazos |
| es cuestión de gusto | personas, comparando pares | qué respuesta prefieren tus usuarios |
| es una traducción, y hay miles | solapamiento, a escala de corpus | BLEU |
Y si te llevas algo más, que sea práctico.
Cierra lo que se pueda cerrar. Si una parte de la respuesta tiene un valor correcto, pídela en un campo y compruébala con un programa. Deja el juicio para el resto.
No uses el solapamiento de palabras para decidir si una respuesta es correcta. Mide el parecido con un ejemplo. La respuesta B de Albarán es la prueba.
Valida al juez antes de fiarte de él. Una muestra juzgada a mano, el porcentaje de acuerdo y una lectura de los desacuerdos. En las comparaciones, juzga en los dos órdenes, vigila la longitud y dale al juez los hechos que necesitaría un experto.
Pon margen a cada número y compara sobre las mismas preguntas. Con 200 preguntas, 4 puntos de diferencia no dicen nada.
Usa las clasificaciones públicas para elegir candidatos, y tus preguntas para decidir.