 Por Gustavo Torres
Si alguna vez has montado un buscador semántico, elegiste el coseno sin elegirlo. Un buscador así convierte cada texto en un embedding, un vector de números con el que un modelo lo representa, y compara la pregunta con cada documento mediante la similitud coseno: el coseno del ángulo entre los dos vectores. Vale cuando apuntan hacia el mismo sitio y baja cuanto más se separan, y el buscador devuelve los textos con el valor más alto. Es la opción por defecto de casi todas las bases de datos vectoriales (las que guardan vectores y devuelven los más parecidos a uno dado), la que recomienda OpenAI para sus embeddings y la que dan por hecha los tutoriales de RAG (retrieval-augmented generation: buscar los fragmentos más parecidos a una pregunta y dárselos al modelo para que responda con ellos).
Muchas librerías, sin embargo, no te dan la similitud sino su reverso, uno menos el coseno, para
que un valor más pequeño signifique «más cerca», como en cualquier distancia. SciPy, la biblioteca
científica de Python, la llama
«Cosine distance».
En pgvector, la extensión vectorial de PostgreSQL, es lo que
devuelve el operador <=>. En scikit-learn, la biblioteca de aprendizaje automático, se pide con
metric="cosine". Ordenar de menor a mayor es lo mismo que ordenar de mayor a menor
, así que la búsqueda devuelve los mismos resultados con una y con otra. Lo que cambia es
el nombre: la similitud, vuelta del revés, se presenta como una distancia, y en scikit-learn hasta
como una métrica.
Toma tres vectores de longitud uno que salen del mismo punto. A apunta en horizontal, C en vertical y B justo en medio, a 45°. La distancia coseno, , vale entre A y B, y otros entre B y C. Entre A y C vale . Ir de A a C pasando por B cuesta , e ir directo cuesta .
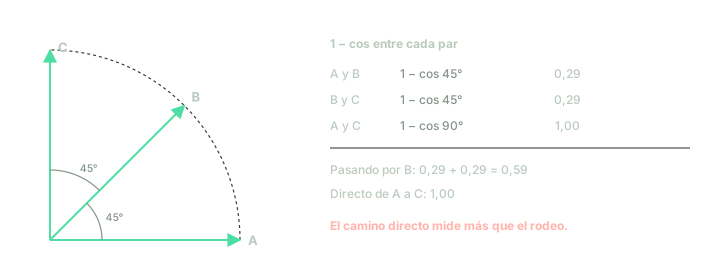
Tres vectores y la distancia coseno: el camino directo mide más que el rodeo.
Ninguna distancia que merezca el nombre permite eso. El camino directo no puede ser más largo que un rodeo: es la desigualdad triangular, y la distancia coseno no la cumple. Así que hay dos cosas que conviene no mezclar. La similitud coseno, la que ordena los resultados, no es una distancia: es una puntuación de parecido. Y la distancia coseno que se construye a partir de ella no es una métrica.
Y aun así el coseno es la elección correcta casi siempre. Las preguntas son dos. La primera, por qué ha ganado entre las docenas de formas que hay de comparar dos vectores. La segunda, qué cuesta que su distancia no sea una métrica, que en una búsqueda es nada y en otras operaciones es bastante. Por el camino salen las medidas con las que compite y los casos en los que deja de ser la herramienta adecuada.
Un embedding es un vector
Un embedding es un vector con el que un modelo representa un trozo de texto: una palabra, una frase, un documento entero. Un vector de dimensiones son números, y los modelos actuales usan cientos o miles (384, 768, 1 536 y 3 072 son tamaños habituales). El modelo está entrenado para que textos que significan algo parecido reciban vectores parecidos. Un vector de números es un punto en un espacio de dimensiones, y se suele dibujar como una flecha que sale del origen y termina en ese punto.
De un vector importan aquí dos de sus propiedades. La primera es su longitud, o norma:
La segunda es su dirección, hacia dónde apunta.
Para comparar dos vectores, la herramienta básica es el producto escalar: multiplicar coordenada a coordenada y sumar. Tiene una lectura geométrica que lo conecta con el ángulo entre los dos:
Despejando sale la similitud coseno:
Vale cuando los dos vectores apuntan hacia el mismo sitio, cuando son perpendiculares y cuando apuntan en sentidos opuestos. Y no cambia si alargas o acortas cualquiera de los dos: dividir por las longitudes es precisamente quitárselas. Los vectores y tienen coseno , aunque el segundo mida el doble y la distancia entre sus puntas sea .
Esa distancia entre las puntas es la otra comparación clásica, la distancia euclídea: , la longitud del vector que va de una punta a la otra. Ve la dirección y la longitud a la vez. El coseno sólo ve la dirección, y todo lo que estuviera guardado en la longitud lo descarta. Ese descarte es la historia entera: por qué casi siempre acierta, y qué cuesta.
Similitud, distancia y métrica
Tres palabras que se usan como sinónimos y nombran tres cosas distintas.
Una similitud es cualquier puntuación que crece cuanto más se parecen dos cosas. No promete nada más: ni un valor máximo, ni siquiera que una cosa sea lo más parecido a sí misma. El coseno es una similitud.
Una distancia, en el sentido amplio que usan las librerías, es lo contrario: una puntuación que crece cuanto más se diferencian. Cualquier similitud se convierte en una dándole la vuelta, y es la «distancia coseno» de SciPy y pgvector. Va de (misma dirección) a (sentidos opuestos).
Una métrica es una distancia que cumple cuatro reglas. Aquí la palabra tiene el sentido de la geometría, no el de las métricas de evaluación como la exactitud (accuracy) de un clasificador. Para cualesquiera , , :
- . Ninguna distancia es negativa.
- sólo si . Distancia cero quiere decir «son lo mismo».
- . Da igual desde dónde se mida.
- . La desigualdad triangular: el camino directo nunca es más largo que un rodeo.
La cuarta es la que más trabajo hace. Dice que conocer dos distancias acota la tercera: si está cerca de e está cerca de , no puede estar lejos de . Todo lo que razona con distancias sin calcularlas todas se apoya en ella.
Ahora, regla por regla. La primera la cumple, porque el coseno nunca pasa de . La tercera también, porque el ángulo de a es el mismo que de a . La segunda falla: y son vectores distintos y su distancia coseno es . Como mucho compara direcciones, no vectores. Esta tiene arreglo fácil: si antes de nada divides cada vector por su longitud (lo que se llama normalizar: dejarlos todos de longitud uno), dos vectores con la misma dirección son el mismo vector.
La cuarta falla incluso así, y es el ejemplo del principio. Los tres vectores tienen longitud uno, y . El rodeo suma y el camino directo mide .
Así que es una distancia en el sentido amplio y no es una métrica. El coseno a secas
ni siquiera es una distancia: es una similitud. Con este vocabulario, los nombres de las librerías
del principio se leen mejor. SciPy y pgvector aciertan al llamar distancia a , en el
sentido amplio. scikit-learn la pide con un parámetro que se llama metric, pero ahí la palabra sólo
quiere decir «función de comparación», no las cuatro reglas. Quien lo dice con todas las letras es
FAISS, la biblioteca de Meta para buscar entre millones de vectores: su
documentación aclara que
el coseno es una similitud y no una distancia, y ni siquiera lo ofrece como opción. Para buscar por
coseno, normalizas los vectores y buscas por producto escalar (METRIC_INNER_PRODUCT).
Dos métricas de verdad con el mismo orden
El coseno esconde dos métricas de verdad, y las dos aparecen al normalizar. Si y son y divididos por su longitud, sus puntas están sobre la esfera de radio uno y el coseno es directamente su producto escalar: .
La primera es el ángulo, . Sobre la esfera de radio uno, el ángulo es la longitud del arco más corto entre las dos puntas sin salirse de la superficie, la ruta de un avión entre dos ciudades. Esa distancia sí cumple la desigualdad triangular: con los tres vectores, . El rodeo por B empata con el camino directo, porque B está justo en medio del camino, y nunca le gana.
La segunda es la cuerda, la distancia euclídea entre los vectores normalizados. Su relación con el coseno sale en una línea, desarrollando el cuadrado y usando que :
Así que , que es una métrica porque la distancia euclídea lo es.
Leída al revés, la misma identidad explica el fallo del principio:
La «distancia coseno» es la mitad del cuadrado de la distancia euclídea entre los vectores normalizados. Y elevar al cuadrado rompe la desigualdad triangular. En una recta, los puntos , y están a distancias , y ; al cuadrado, , y , y . El cuadrado castiga más las distancias grandes que las pequeñas, así que un viaje largo cuesta más que dos medios viajes. Con ángulos pequeños se ve en números: , y dos pasos de cuestan cada uno, juntos, mientras que los de golpe cuestan , el doble.
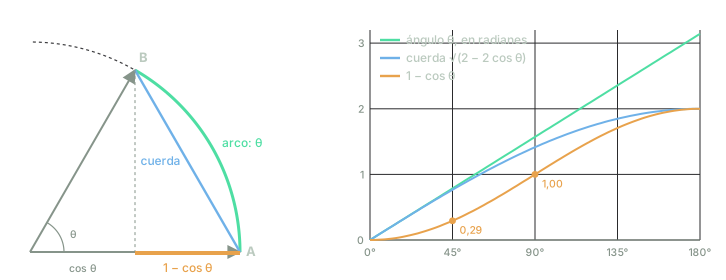
Tres formas de medir lo lejos que están dos direcciones. El arco y la cuerda son métricas; 1 − cos arranca plano, y por eso dos pasos cortos suman menos que uno largo.
La consecuencia importante está en la gráfica de la derecha: las tres medidas crecen siempre con el ángulo. Ángulo mayor, cuerda mayor, mayor y coseno menor van juntos, así que las tres ordenan cualquier lista de candidatos exactamente igual. Buscar los diez textos más cercanos por coseno, por ángulo o por distancia euclídea entre vectores normalizados da los mismos diez, en el mismo orden. Es lo que dice la guía de OpenAI: sus embeddings vienen normalizados, así que el coseno y la distancia euclídea dan el mismo ranking.
Para buscar, que es para lo que se usa el coseno casi siempre, no ser una métrica no importa nada. Importa cuando con los números se hace algo más que ordenarlos.
Cuándo sí importa
Hay tres situaciones: cuando un algoritmo usa la desigualdad triangular para ahorrarse cálculos, cuando se promedian vectores y cuando se encadenan parecidos.
Índices que descartan sin mirar
Algunos índices exactos de vecinos, como el árbol de bolas (ball tree), agrupan los puntos en bolas con un centro y un radio, y descartan una bola entera con un solo cálculo. Si la pregunta está a distancia del centro y la bola tiene radio , todo lo que hay dentro está al menos a de la pregunta, por la desigualdad triangular. Si ya supera al mejor candidato encontrado, la bola se salta sin mirar dentro. Con una distancia que no cumple la desigualdad, esa cota es falsa y el índice descartaría vecinos de verdad.
scikit-learn lo sabe. Ni su BallTree ni su KDTree aceptan el coseno, y cuando se pide
NearestNeighbors(metric="cosine") con el algoritmo automático,
pasa a fuerza bruta: comparar la pregunta
con todo. El arreglo es la sección anterior. Normaliza los vectores, pide la distancia euclídea, y el
árbol funciona con el mismo orden.
Los índices de grafo como HNSW (Hierarchical Navigable Small World, el que usan muchas bases de datos vectoriales) no descartan con la desigualdad triangular. Recorren un grafo de vecinos saltando siempre al más prometedor, y son aproximados de todas formas. Por eso hnswlib, la biblioteca de código abierto que mantiene el primer autor de HNSW, ofrece el producto escalar y el coseno junto a la distancia euclídea, con un aviso de que el producto escalar no es una métrica.
Promediar
k-means agrupa puntos en grupos repitiendo dos pasos: asignar cada punto al centro más cercano y mover cada centro a la media de sus puntos. Está hecho para la distancia euclídea, y con direcciones la media tiene trampa: la media de vectores de longitud uno no tiene longitud uno. Dos vectores perpendiculares, y , promedian , de longitud , y cuanto más disperso es un grupo, más corto queda su centro.
Si se corre k-means normal sobre vectores normalizados, el paso de asignación compara cada punto con centros de longitudes distintas. Como , el último término favorece a los grupos con el centro más corto, los más dispersos, por algo que no tiene nada que ver con el parecido. El k-means esférico (Dhillon y Modha, 2001) lo arregla volviendo a normalizar cada centro después de promediar. Vale para cualquier media de embeddings: el promedio de vectores normalizados hay que normalizarlo otra vez antes de compararlo con nada.
Encadenar
«A se parece a B y B se parece a C, así que A se parece a C.» Es el razonamiento de quien deduplica un corpus, agrupa por cadenas o recomienda amigos de amigos. Con una métrica, la conclusión tiene una cota. Con el coseno también, si se pasa por el ángulo, que sí es una métrica.
Supón que y , con . Cada uno de los dos ángulos mide como mucho . Por la desigualdad triangular de los ángulos,
El coseno decrece entre y , así que un ángulo mayor da un coseno menor, y la fórmula del ángulo doble, , cierra la cuenta:
Con quedan garantizados . Con , . Con , : nada. A y C pueden ser perpendiculares, sin ninguna relación, aunque cada paso parezca bastante parecido. La cota es exacta, porque se alcanza cuando B está justo en medio del arco entre A y C, que es lo que pasaba con los tres vectores: y .
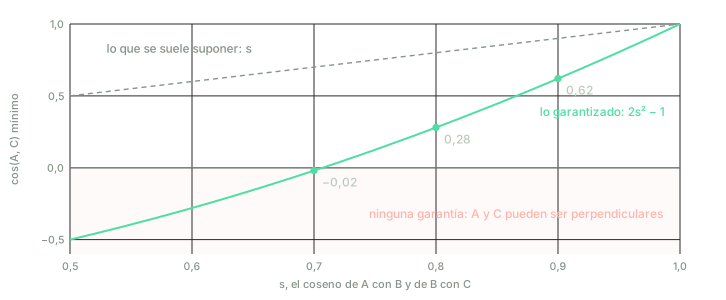
Lo que dos parecidos garantizan sobre el tercero. Por debajo de 0,71 por paso, nada.
Un umbral de para decir «parecidos» no se compone. Dos saltos de pueden unir textos que no tienen nada que ver, y un agrupamiento que une grupos por cadenas (el single linkage) con ese umbral acaba conectando cualquier cosa con cualquier otra si hay pasos intermedios suficientes.
Por qué ganó el coseno
Si el coseno, el ángulo y la distancia euclídea entre vectores normalizados ordenan igual, la pregunta no es por qué el coseno y no la distancia euclídea. Es por qué tirar la longitud. Hay cuatro razones, y una quinta que se repite mucho y no se sostiene.
La herencia de la recuperación de información
En 1975, Salton, Wong y Yang describieron el modelo vectorial para buscar documentos: cada documento es un vector con una coordenada por término, pesada según su importancia (lo que luego se llamaría TF-IDF, term frequency–inverse document frequency: cuántas veces sale la palabra en el documento por lo rara que es en la colección). En la primera página ya proponen comparar documentos por el ángulo entre sus vectores, y normalizarlos todos a longitud uno para dejarlos sobre la esfera.
El motivo era práctico. Un documento largo repite más palabras, así que su vector es más largo, y con el producto escalar los documentos largos ganarían cualquier búsqueda por ser largos. El coseno quita la longitud, que ahí era un accidente del texto y no de su tema. Cuando llegó word2vec en 2013, el primer modelo popular de vectores de palabras, la costumbre vino con él: sus autores ya resolvían las analogías buscando la palabra más cercana «por distancia coseno». El procesamiento del lenguaje heredó la medida de los buscadores.
La longitud mide otra cosa
En los vectores de palabras, la longitud no es significado. Schakel y Wilson la estudiaron en 2015 con word2vec, y resultó mezclar dos cosas: lo frecuente que es una palabra y lo constante que es el contexto en el que aparece. Una palabra que sale siempre en el mismo tipo de frase tiene un vector más largo cuanto más aparece. Una que sale en contextos muy distintos, como «el» o «de», acaba con un vector corto, porque cada contexto tira de él hacia un lado y los tirones se compensan. Ellos proponen usar la longitud para medir cuánto importa una palabra en un corpus. Es información útil, pero no es parecido: con el producto escalar, dos palabras saldrían más cercanas por ser importantes, no por significar lo mismo. El coseno sólo pregunta hacia dónde apunta cada vector.
Los modelos se entrenan con el coseno
Es la razón más fuerte hoy, y es circular en el buen sentido: los modelos de embeddings se entrenan con el coseno dentro de la función de pérdida. Sentence-BERT (2019), el modelo que popularizó los embeddings de frases, prometía en su resumen vectores que se pueden comparar con el coseno. El entrenamiento contrastivo, que hoy es el estándar, junta los pares que deberían parecerse y separa los demás midiendo con el coseno dividido por una temperatura, un número que regula lo duro que es el contraste: en SimCSE, un método contrastivo de 2021. Wang e Isola (2020) lo formalizaron: los vectores se colocan sobre la esfera de radio uno y el entrenamiento busca dos cosas, alineamiento (los pares parecidos, juntos) y uniformidad (todo lo demás, repartido por la esfera entera).
Un modelo entrenado así nunca recibió ninguna señal sobre la longitud, porque la pérdida no la veía. La longitud es ruido, y muchos modelos la quitan ellos mismos: los embeddings de OpenAI salen ya normalizados. Con ellos, el coseno, el producto escalar y la distancia euclídea son intercambiables, y el producto escalar es el más barato. La regla general es que la medida correcta es la que se usó al entrenar el modelo.
Es barato
Se normaliza una vez, al indexar, y a partir de ahí cada coseno es un producto escalar: multiplicaciones y sumas. Comparar una pregunta con un millón de documentos es un único producto de matriz por vector, la operación que mejor hacen las tarjetas gráficas y las librerías de álgebra lineal. Como el resultado vive entre y , los vectores se comprimen bien, por ejemplo a enteros de 8 bits.
Y el ángulo tiene su propio atajo. Charikar demostró en 2002 que si se corta el espacio con un plano al azar que pasa por el origen, la probabilidad de que dos vectores caigan a lados distintos es . Con 256 planos al azar, cada vector se convierte en 256 bits, y la proporción de bits en los que difieren dos vectores estima su ángulo dividido por . Se llama SimHash, y estima el ángulo, la métrica, no .
Lo que no lo explica: la maldición de la dimensión
Una explicación frecuente es que en muchas dimensiones la distancia euclídea pierde sentido y el coseno no. La primera mitad tiene base: Beyer y otros demostraron en 1999 que, en condiciones bastante generales, al crecer la dimensión el punto más cercano a una pregunta y el más lejano acaban casi a la misma distancia. La segunda mitad no puede ser cierta con vectores normalizados: si el coseno y la distancia euclídea ordenan igual, sufren lo mismo.
El coseno también se concentra. Entre dos direcciones al azar en dimensiones, el coseno tiene media y desviación típica . En 768 dimensiones son , así que casi todos los pares de vectores al azar son casi perpendiculares. Lo que salva a los embeddings no es la medida: es que sus puntos no están al azar, sino amontonados en una parte pequeña y con estructura del espacio.
Así que la elección de fondo es quedarse con la longitud o tirarla. En casi todos los embeddings de texto la longitud es ruido (el modelo nunca aprendió a usarla) o mide algo que no queremos comparar (lo frecuente o lo importante que es una palabra, el largo de un documento). Por eso el coseno.
Las demás medidas
La tabla resume las que aparecen en el procesamiento del lenguaje, qué son y si ven la longitud.
| medida | qué es | ¿ve la longitud? | dónde aparece |
|---|---|---|---|
| coseno | similitud, de a | no | casi todos los modelos de embeddings de texto |
| ángulo, | métrica | no | SimHash; cuando hace falta una métrica de verdad |
| producto escalar | similitud sin límites | sí | DPR, sistemas de recomendación |
| euclídea | métrica | sí, salvo entre vectores normalizados | índices en árbol, k-means |
| Manhattan | métrica: suma de diferencias absolutas | sí | rara vez con embeddings |
| Mahalanobis | métrica que descuenta las correlaciones entre coordenadas | sí | blanquear embeddings |
| Pearson | similitud, de a | no | el coseno tras restar a cada vector la media de sus coordenadas |
| Jaccard | es métrica; compara conjuntos | no aplica | deduplicar corpus (con MinHash) |
| Hamming | métrica: cuenta bits distintos | no aplica | códigos binarios, SimHash |
| Jensen–Shannon | divergencia entre distribuciones; su raíz es métrica | no aplica | comparar distribuciones de palabras o de temas |
| cross-encoder | aprendida, sin geometría | no aplica | reordenar resultados |
Tres merecen un párrafo.
El producto escalar es el que se queda con la longitud, y es el adecuado cuando la longitud es información. En un sistema de recomendación, el producto entre el vector de un usuario y el de un producto es la predicción, y la longitud del vector de un producto suele recoger lo popular que es, que es un buen motivo para recomendarlo. DPR (Dense Passage Retrieval, 2020), un buscador de pasajes para responder preguntas, se entrenó con producto escalar, y en sus propias pruebas la distancia euclídea rindió parecido y ambas por encima del coseno, aunque con los ajustes elegidos para el producto escalar. Eso sí, no es ni una similitud bien educada: un vector puede parecerse más a otro que a sí mismo. Con y , el producto de la primera consigo misma es y con la segunda es .
La distancia de Mahalanobis es la euclídea después de blanquear los datos: transformarlos para que las coordenadas no estén correlacionadas y tengan todas la misma varianza. Es la conexión con el arreglo de la sección siguiente.
Los cross-encoders juegan a otra cosa. Todas las medidas anteriores comparan dos vectores calculados por separado, cada texto codificado por su cuenta. Un cross-encoder lee los dos textos a la vez y devuelve una puntuación, así que ve cada palabra de uno frente a cada palabra del otro, y suele acertar más. El precio es que no se puede calcular nada por adelantado: cada par es una pasada entera del modelo. Por eso el patrón habitual es usar el coseno para sacar cien candidatos entre millones, y el cross-encoder para reordenar esos cien. El coseno no es la mejor similitud que existe. Es la mejor que cabe en un índice.
Dónde el coseno no encaja
Antes, una separación que ahorra discusiones: no es lo mismo un fallo de la medida que un fallo de la representación. «Caliente» y «frío» tienen un coseno alto en muchos modelos de palabras, y una frase y su negación también. No es culpa del coseno. Esas palabras aparecen en los mismos contextos, el modelo las colocó cerca, y el coseno informa fielmente de lo que el modelo aprendió. Ninguna medida arregla una representación que no distingue dos cosas; eso se arregla al entrenar.
Los fallos que sí son de la medida son tres.
Cuando todo apunta hacia el mismo sitio
Ethayarajh midió en 2019 el coseno medio entre palabras escogidas al azar dentro de modelos de lenguaje como BERT (Google, 2018) y GPT-2 (OpenAI, 2019), tomando el vector que cada capa del modelo da a cada palabra. En GPT-2 rondaba en las capas 2 a 8, y en la última casi : dos palabras cualesquiera tenían un coseno casi perfecto. En la última capa de BERT, alrededor de . Se llama anisotropía: los vectores no ocupan la esfera entera sino un cono estrecho, y todo se parece a todo.
Timkey y van Schijndel encontraron en 2021 parte de la causa: unas pocas dimensiones rebeldes con valores enormes. En la capa 11 de BERT, una sola coordenada de 768 aporta el 88 % del coseno esperado entre dos vectores; en XLNet, otro modelo de 2019, el 99,6 %. Ahí el coseno mide una coordenada.
Esto pasa sobre todo cuando se sacan vectores de un modelo de lenguaje que no se entrenó para compararlos. Los arreglos, de más barato a más caro: centrar (restar a todos los vectores la media de la colección; Mu y Viswanath quitan además las pocas direcciones dominantes), estandarizar cada coordenada, que es el arreglo de Timkey y van Schijndel, blanquear (comparar, en el fondo, con la distancia de Mahalanobis), o usar un modelo entrenado con pérdida contrastiva, cuya uniformidad empuja justo en contra del cono.
Incluso los modelos buenos tienen su propia escala. La ficha de E5, una familia de modelos de embeddings, avisa de que sus cosenos suelen caer entre y por la temperatura de su entrenamiento (), y de que lo que importa es el orden relativo. Un coseno de no significa «parecidos al 80 %», y un umbral elegido para un modelo no sirve para otro: hay que calibrarlo con pares etiquetados de tus propios datos.
Cuando la longitud era la señal
Steck, Ekanadham y Kallus, de Netflix, publicaron en 2024 un artículo con una pregunta por título: si el coseno entre embeddings mide de verdad similitud. En una familia de modelos lineales de recomendación, la predicción es el producto de dos matrices, , y se puede multiplicar cada columna de por un factor cualquiera y dividir la columna correspondiente de por el mismo factor. Con una matriz diagonal :
Las predicciones no cambian; los cosenos entre las filas de , sí. El modelo no los determina, y según el entrenamiento pueden salir arbitrarios. La receta de los autores: si se va a comparar con el coseno, entrenar con el coseno dentro de la pérdida. Si no, lo único que el modelo fijó es el producto escalar. Es el principio de antes, visto desde el lado en que falla.
Cuando la relación tiene dirección
El coseno es simétrico: es la tercera regla, la que sí cumple. Muchas relaciones no lo son. Una pregunta y su respuesta no son intercambiables. Un perro es un animal, pero no al revés. Una frase puede implicar otra sin que la segunda implique la primera.
Hay tres salidas. Meter la asimetría en el modelo y no en la medida: E5 pide anteponer query: a las
preguntas y passage: a los documentos, de modo que el mismo texto se codifica distinto según su
papel. Cambiar la geometría: los order embeddings representan
«es un» como un orden entre vectores, y los embeddings hiperbólicos
colocan las jerarquías en un espacio donde los árboles caben sin apretarse. O comparar por piezas:
ColBERT, un buscador de 2020, guarda un vector normalizado por palabra y puntúa sumando,
para cada palabra de la pregunta, su mejor coseno con alguna palabra del documento. Esa suma recorre
la pregunta y no el documento, así que es asimétrica por construcción. Y siempre queda el
cross-encoder.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: el coseno es una similitud, y es una distancia que no es una métrica, porque es la mitad del cuadrado de la distancia euclídea entre los vectores normalizados. Para buscar da igual, porque el ángulo, la cuerda y el coseno ordenan exactamente igual. Para promediar, encadenar o podar un índice, no da igual, y la métrica que hay que usar es el ángulo o la distancia euclídea entre vectores normalizados.
Y si te llevas una segunda: el coseno no ganó por medir mejor el significado, sino porque tira la longitud, que en casi todos los embeddings de texto es ruido o mide otra cosa, y porque los modelos se entrenan con él dentro de la pérdida.
Lo demás es práctico.
Usa la medida con la que se entrenó el modelo. Suele estar en su ficha. Si es el coseno y los vectores ya vienen normalizados, usa el producto escalar: mismo orden, menos cuentas.
Si la longitud significa algo, no la tires. Popularidad, frecuencia, importancia: si el modelo se entrenó con producto escalar, compara con producto escalar.
No fijes umbrales a ojo. Un coseno de significa cosas distintas en cada modelo, y dos parecidos de no garantizan un tercero. Calibra con pares etiquetados y, si sacas vectores de un modelo que no se entrenó para compararlos, céntralos antes.
Para relaciones con dirección, pon la asimetría en otra parte. Prefijos distintos para preguntas y documentos, o un cross-encoder que reordene los primeros resultados.