 Por Gustavo Torres
Una empresa de software de facturación, llamémosla Albarán, tiene un asistente interno para su equipo de soporte. Alguien del equipo le pregunta:
¿El cliente de la incidencia 4812 tiene derecho a reembolso?
Y el asistente contesta, con dos citas:
No. El cobro anual se hizo el 14 de agosto y el plazo de reembolso es de 14 días desde el cobro, así que venció el 28 de agosto. [Incidencia 4812] [Preguntas frecuentes sobre reembolsos]
Las dos citas existen y dicen lo que la respuesta dice que dicen. La incidencia 4812 es de Ferretería Ortega, que pagó su renovación anual el 14 de agosto y pidió el reembolso el 2 de septiembre. Las preguntas frecuentes dicen, literalmente, que «por lo general, los reembolsos pueden solicitarse en los 14 días siguientes al cobro». Y la respuesta es falsa. Ferretería Ortega tiene el plan Equipo, y las condiciones de ese plan, en otro documento del mismo índice, dan 30 días a las suscripciones anuales. El plazo acaba el 13 de septiembre; la petición llegó once días antes.
El caso es inventado, pero no tiene nada de raro. Nadie ha programado nada mal. El asistente busca en los documentos de la empresa antes de responder, que es lo que propone el patrón RAG (Retrieval-Augmented Generation, generación aumentada por recuperación), y su búsqueda es buena: encontró la incidencia correcta por su número, cosa que muchas no consiguen. Falló otra cosa. Para encontrar la regla que aplica había que buscar «plan Equipo», y la palabra «Equipo» no está en la pregunta: está dentro de la incidencia, es decir, dentro del resultado de la primera búsqueda. Un sistema que busca una vez, con la pregunta tal como llega, no puede escribir esa segunda consulta. Hace falta que alguien lea el primer resultado y decida qué buscar después.
La historia del RAG desde 2020 suele contarse como una escalera: RAG ingenuo, RAG avanzado, RAG híbrido, RAG agéntico, cada peldaño mejor que el anterior. La escalera mezcla dos cosas. Una es la calidad de la búsqueda: qué encuentra cuando le das una consulta. La otra es el control: quién decide si se busca, qué se busca, dónde, y cuándo se ha buscado bastante. El RAG híbrido mejora lo primero, el agéntico cambia lo segundo, y el asistente de Albarán enseña que una cosa no sustituye a la otra: tenía la mejor búsqueda de todo el artículo, y con ella dio la respuesta más convincente y más equivocada.
El eje del control, de un vistazo:
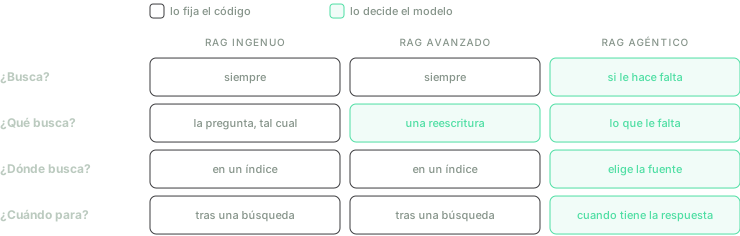
En el RAG ingenuo, las cuatro decisiones están escritas en el código antes de que llegue la primera pregunta. Cada generación le pasa alguna al modelo. El orden de las columnas es lógico, no cronológico: ReAct, la base del agéntico, se publicó dos meses antes que HyDE, una de las técnicas del avanzado.
Lo que el modelo no sabe, y tres formas de dárselo
Un modelo de lenguaje sabe lo que aprendió al entrenarse, y lo sabe de una manera particular: repartido entre sus pesos, sin ficha de procedencia. Eso tiene tres consecuencias que ninguna mejora del modelo arregla. No sabe nada posterior a la fecha en que se congelaron sus datos. No sabe nada que no fuese público: la incidencia 4812 nunca estuvo en internet. Y no puede decir de dónde saca lo que dice, porque no lo saca de ningún sitio concreto: una cita escrita de memoria es otra frase generada, igual de plausible e igual de imposible de comprobar.
Hay tres sitios donde poner el conocimiento que le falta.
| En los pesos (ajuste fino) | Todo en el contexto | En un índice (RAG) | |
|---|---|---|---|
| Actualizar un documento | reentrenar | editar el texto | reindexar ese documento |
| Coste de cada pregunta | el de siempre | proporcional a todo el corpus | proporcional a lo recuperado |
| Puede citar la fuente | no | sí | sí |
| Borrar un dato | no hay forma fiable | quitarlo del texto | quitarlo del índice |
Los pesos son el sitio equivocado para los hechos. El ajuste fino enseña bien maneras de hacer: un tono, un formato, el vocabulario de un dominio. Para hechos concretos es caro, lento y opaco. Cada cambio de política pide un reentrenamiento, no hay forma de comprobar qué ha aprendido exactamente, y si un cliente pide que se borren sus datos, no existe ninguna operación que los saque de unos pesos.
El contexto es la opción que las ventanas de un millón de tokens han vuelto seria, y no conviene despacharla rápido. Si el corpus cabe entero y cambia poco, pegarlo en cada petición con la caché de prompts del proveedor activada puede salir más barato y más fiable que cualquier índice, porque no hay búsqueda que pueda fallar. Deja de funcionar por tres lados. El coste y la latencia crecen con todo lo que pegas, en cada pregunta, lo necesites o no. Los documentos de una empresa no caben: las incidencias de soporte de un año no entran en ninguna ventana. Y tener el dato en el contexto no garantiza que el modelo lo use. Lost in the Middle midió en 2023 que la precisión cae cuando la información relevante está a mitad del contexto en lugar de al principio o al final, y en su experimento de preguntas sobre veinte documentos, GPT-3.5-Turbo acertaba menos con el documento bueno en el medio que sin ningún documento.
El índice es el término medio. Se trocean los documentos por adelantado y, en cada pregunta, se buscan los pocos trozos relevantes y se pegan sólo esos. Cada pregunta paga por lo que recupera, no por todo lo que hay; el conocimiento se actualiza reindexando un documento, sin tocar el modelo; y la respuesta puede citar el trozo exacto del que sale. El precio es que ahora hay una búsqueda en medio, y una búsqueda puede fallar. Todo lo que viene después sale de ahí.
El patrón original
El nombre viene de un artículo de 2020, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, y lo que proponía era más ambicioso que lo que hoy se llama RAG. Juntaba dos piezas. La primera era un buscador denso, DPR, que convierte la pregunta y cada fragmento en un vector, con un codificador para cada uno, y busca los fragmentos cuyo vector queda más cerca del de la pregunta. Los fragmentos eran 21 millones de trozos de Wikipedia. La segunda pieza era un generador, BART: un modelo de lenguaje de 400 millones de parámetros, publicado por Facebook en 2019. En RAG, leía la pregunta junto con los fragmentos recuperados y escribía la respuesta. Y el artículo entrenaba las dos piezas a la vez: el error de la respuesta final se propagaba hacia atrás hasta el codificador de las preguntas, de modo que el buscador aprendía a traer lo que al generador le servía. Sólo dejaba fijo el codificador de los documentos, y por una razón práctica: si cambiaba, habría que volver a codificar los 21 millones de fragmentos en cada paso del entrenamiento.
Lo que la industria adoptó fue el nombre y la forma, no el entrenamiento. El RAG que se construye hoy junta un modelo de embeddings de un proveedor y un modelo de lenguaje de otro, que nunca se han visto, y los une con un prompt. Conviene tenerlo presente, porque explica buena parte de los fallos de la sección siguiente: el buscador no sabe qué necesita el generador. Busca lo que se parece a la pregunta y confía en que eso sea lo que hace falta.
Esa versión tiene dos carriles:
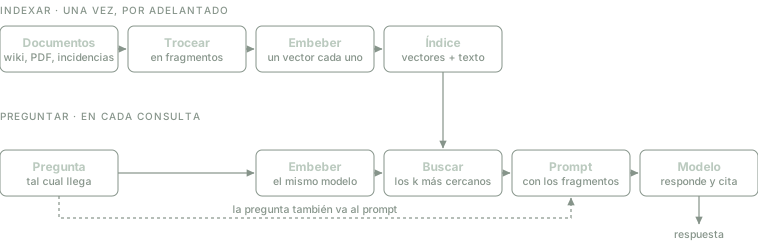
El RAG ingenuo. Arriba, lo que se hace una vez; abajo, lo que se hace en cada pregunta. Los dos «Embeber» están en la misma columna porque tienen que ser el mismo modelo: una pregunta y un fragmento sólo se pueden comparar si viven en el mismo espacio. El hueco entre «Pregunta» y «Embeber» no es un descuido; más adelante se llena.
Indexar es trabajo por adelantado. Los documentos se trocean en fragmentos de unos cientos de palabras, normalmente con algo de solape entre uno y el siguiente; cada fragmento pasa por un modelo de embeddings que lo convierte en un vector, y los vectores se guardan en un índice junto al texto del que salen. Qué es un embedding, y por qué la cercanía entre vectores refleja cercanía de significado, es el tema de esta lección del curso de NLP; aquí se da por sabido. El tamaño del fragmento es la primera decisión con consecuencias: un fragmento grande diluye su vector, que acaba representando el promedio de varias ideas, y uno pequeño se queda sin el contexto que le daba sentido.
Preguntar es el camino que se recorre cada vez. La pregunta pasa por el mismo modelo de embeddings, el índice devuelve los fragmentos cuyos vectores están más cerca (por similitud coseno, casi siempre) y un prompt junta la pregunta con esos fragmentos y una instrucción del estilo de «responde usando sólo estos fragmentos, cita de cuál sale cada afirmación y, si la respuesta no está, dilo». El modelo genera la respuesta.
Escrito como código, el camino de la pregunta cabe en dos líneas:
def responder(pregunta, indice, k=4):
    fragmentos = indice.buscar(embeber(pregunta), k)
    return modelo(prompt(pregunta, fragmentos))
Merece la pena fijarse en lo que esas dos líneas deciden sin consultar a nadie. Se busca siempre, aunque la pregunta sea «gracias». Se busca la pregunta tal como la escribió el usuario. Se busca en un único índice. Y se busca una vez: los fragmentos que salgan son todo lo que el modelo va a ver. Son las cuatro filas de la tabla del principio, y aquí están escritas como constantes.
Dónde se rompe el RAG ingenuo
Si la pregunta de Albarán pasa por esas dos líneas, el índice devuelve primero las preguntas frecuentes sobre reembolsos, que se parecen muchísimo a una pregunta sobre reembolsos, y después dos incidencias de otros clientes que también piden su dinero, la 4821 y la 4182. La 4812 queda cuarta, fuera del corte. El modelo, que es honesto, responde lo único que puede: que el plazo general es de 14 días y que no encuentra los datos de la incidencia 4812. No es una respuesta equivocada. Tampoco es una respuesta.
Ese es uno de los fallos. En la práctica aparecen seis, y cada uno ocurre en un sitio distinto del dibujo:
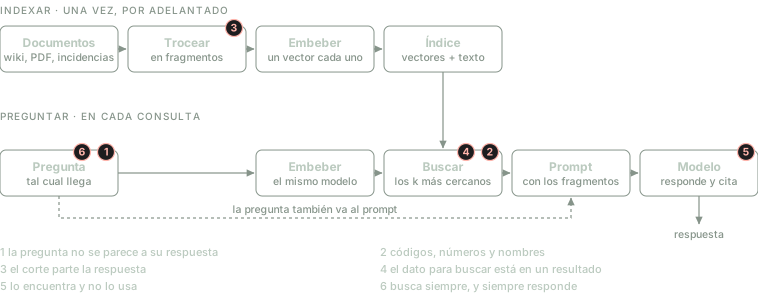
Los seis fallos del RAG ingenuo, cada uno donde ocurre. Dos caen en «Buscar», pero no son el mismo: el 2 es de puntería, el 4 es de que sólo hay un disparo.
- La pregunta no se parece a su respuesta. Una pregunta es corta e interrogativa; el fragmento que la responde es largo, afirmativo y usa el vocabulario del documento. «¿Me devuelven el dinero si cancelo?» y «Las suscripciones anuales podrán reembolsarse íntegramente dentro del plazo…» hablan de lo mismo, pero sus vectores no tienen por qué estar cerca: el modelo de embeddings mide parecido, y una pregunta se parece más a otras preguntas que a su respuesta.
- Códigos, números y nombres propios. Un embedding resume el significado, y un número de incidencia no tiene significado que resumir: son unos pocos tokens entre cientos, y para el modelo 4812, 4821 y 4182 son casi lo mismo. Entre incidencias que dicen todas «el cliente pide el reembolso», el orden lo deciden las demás palabras. Pasa igual con referencias de producto, códigos de error, versiones y apellidos: lo que el usuario escribe exacto, la búsqueda lo devuelve aproximado.
- El corte parte la respuesta. El troceado no sabe de estructura. Si la tabla de plazos empieza al final de un fragmento y sus filas caen en el siguiente, el fragmento con «30 días» ya no dice a qué plan se refiere, y ninguno de los dos responde la pregunta por sí solo.
- El dato que hace falta para buscar está en un resultado. Es el fallo de Albarán. La pregunta dice «4812»; la regla que la responde dice «plan Equipo»; lo que conecta las dos está dentro de la incidencia. Ninguna búsqueda única, por buena que sea, puede escribir una consulta con una palabra que todavía no ha leído. En la literatura se llaman preguntas de varios saltos (multi-hop).
- Lo encuentra y no lo usa. El fragmento correcto llega al prompt, pero en quinta posición de ocho, o al lado de otro que dice algo parecido con más aplomo, y el modelo sigue al otro. Es el efecto que midió Lost in the Middle, más un problema que ningún buscador resuelve: dos documentos que se contradicen, como unas preguntas frecuentes que dicen «por lo general, 14 días» y unas condiciones que dicen «30 días» para un plan concreto.
- Busca siempre, y siempre responde. El código busca ante un «gracias» y ante «resume lo que acabamos de hablar». Y en el otro extremo, cuando lo que devuelve la búsqueda no tiene nada que ver con la pregunta, el prompt entrega esos fragmentos igual, y un modelo al que se le ha pedido que responda con ellos tiende a responder con ellos.
Cada fallo tiene un arreglo, y no todos están en el mismo sitio:
| Fallo | Qué lo arregla | Dónde se cuenta |
|---|---|---|
| 1. La pregunta no se parece a su respuesta | reescribir la consulta, HyDE | Arreglar la pregunta |
| 2. Códigos, números y nombres | búsqueda léxica junto a la densa | El otro eje |
| 3. El corte parte la respuesta | fragmentos con contexto | El otro eje |
| 4. Varios saltos | buscar dentro de un bucle | RAG agéntico |
| 5. Lo encuentra y no lo usa | reordenar, traer menos y mejor, juzgar lo recuperado | El otro eje y Juzgar lo que vuelve |
| 6. Busca siempre | que el modelo decida si busca | RAG agéntico |
El otro eje: qué encuentra la búsqueda
Dos de los seis fallos, el 2 y el 3, son de puntería: la búsqueda no trae algo que existe. Se arreglan sin darle ninguna decisión al modelo, mejorando el buscador, y el arreglo principal es mucho más viejo que el RAG.
Antes de los embeddings, buscar era contar palabras. La búsqueda léxica, cuyo representante de referencia es BM25 (de mediados de los noventa, y todavía el algoritmo por defecto de Elasticsearch), puntúa un documento por los términos de la consulta que contiene, con tres correcciones: una palabra rara pesa más que una común (encontrar «4812» dice mucho más que encontrar «cliente»), repetir una palabra suma cada vez menos, y un documento largo no gana sólo por tener más palabras. No sabe nada de significado: «reembolso» y «devolución del dinero» son, para BM25, cosas sin relación. Pero lo que la búsqueda densa hace mal, BM25 lo hace bien por construcción: si el documento contiene «4812» y la consulta también, lo encuentra.
Las dos búsquedas fallan en preguntas distintas, y eso es lo que hace útil combinarlas. El problema es cómo. Sus puntuaciones no se pueden sumar: la similitud coseno vive entre −1 y 1, y la de BM25 no tiene techo y depende del corpus. La solución habitual no mira las puntuaciones, sino las posiciones. La fusión por rango recíproco (RRF, de 2009) le da a cada documento la suma, sobre cada lista en la que aparece, de
con . (El artículo original la llama ; aquí se llamaría igual que la de los fragmentos, y no tienen nada que ver.) La constante aplana las diferencias: ser primero en una lista vale y ser cuarto vale , así que un documento bien colocado en las dos listas le gana a uno que es primero en una y no aparece en la otra. RRF premia el acuerdo.
Con la pregunta de Albarán:
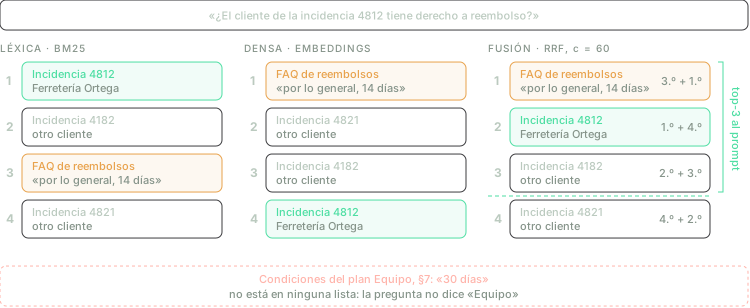
BM25 pone la incidencia 4812 la primera porque es el único documento que contiene «4812»; la búsqueda densa la deja cuarta. La fusión la sube a segunda y la mete en el corte. Las condiciones del plan Equipo no aparecen en ninguna de las dos listas.
Este es el buscador del principio del artículo. Arregla el fallo 2: la incidencia correcta llega al prompt. Y el modelo, que ahora tiene la fecha del cobro y una regla de 14 días, hace la cuenta y responde «no», con dos citas. Mejorar la búsqueda ha convertido una no-respuesta honesta en una respuesta falsa y segura de sí misma: el modelo tiene ya material suficiente para sonar convincente, y le sigue faltando el único dato que importa.
Alrededor de la fusión hay dos piezas más que casi todos los sistemas serios acaban usando.
Reordenar. El modelo de embeddings codifica la pregunta y cada fragmento por separado, y por eso es rápido: los fragmentos se codifican una sola vez, al indexar. Un reordenador (reranker, casi siempre un cross-encoder) lee la pregunta y el fragmento juntos, como un único texto, y puntúa cuánto responde uno a la otra. Es mucho más preciso y mucho más lento, así que se usa en dos etapas: la búsqueda híbrida trae cincuenta o cien candidatos baratos y el reordenador elige los cinco que llegan al prompt. Traer menos fragmentos, y mejores, ataca también el fallo 5.
Fragmentos con contexto. Para el fallo 3, la idea más eficaz de los últimos años consiste en escribir, antes de indexar, una o dos frases que sitúen cada fragmento dentro de su documento («Este fragmento pertenece a las condiciones del plan Equipo, sección 7, reembolsos») y pegarlas delante, tanto para el embedding como para BM25. Anthropic lo publicó en 2024 como Contextual Retrieval, con números: en sus pruebas, la proporción de búsquedas que no traían el fragmento necesario entre los veinte primeros bajaba del 5,7 % al 2,9 % con contexto en las dos búsquedas, y al 1,9 % añadiendo un reordenador.
Todo esto da para un artículo propio, con números medidos sobre texto en español. Para este importa lo que no hace: ninguna de estas técnicas cambia quién decide. Una búsqueda híbrida con contexto y reordenador sigue buscando siempre, una sola vez, con la pregunta tal cual. Es el mismo diagrama de dos carriles con un buscador mejor dentro.
Arreglar la pregunta antes de buscar
El primer paso en el eje del control es pequeño: dejar que el modelo toque la consulta antes de que salga hacia el índice. El resto del pipeline sigue igual. Es lo que la panorámica de 2023 que puso nombre a las etapas llamó RAG avanzado, y agrupa varias técnicas con la misma forma.
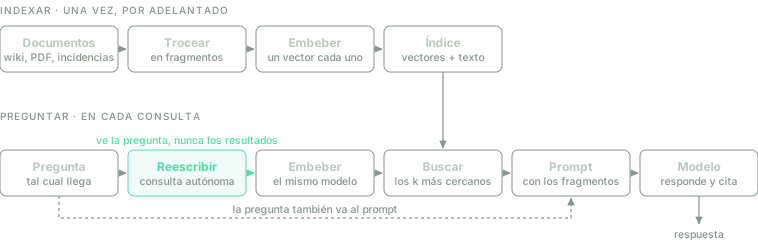
El hueco del carril de la pregunta, ocupado. Es la primera decisión que pasa del código al modelo, y la toma a ciegas: ve la pregunta, nunca los resultados.
Reescribir. En una conversación, la mayoría de las preguntas no se pueden buscar tal cual. Después de hablar de la 4812, «¿y la que abrió ayer la misma ferretería?» no contiene nada que un índice pueda encontrar. Un paso previo en el que el modelo lee la conversación y escribe una consulta autónoma («incidencias de Ferretería Ortega abiertas el 25 de septiembre») es probablemente la mejora con más retorno de todo el artículo, y una de las más olvidadas.
HyDE. Contra el fallo 1, HyDE (Hypothetical Document Embeddings, embeddings de documentos hipotéticos), publicado a finales de 2022 por investigadores de Carnegie Mellon y de la Universidad de Waterloo, le da la vuelta al problema, y el nombre ya lo cuenta: si una pregunta no se parece a su respuesta, que el modelo escriba primero una respuesta inventada, un documento hipotético, y se busca con esa. Las respuestas se parecen a respuestas. Lo que afirme la respuesta inventada da igual, aunque sea falso, porque nadie la lee: sólo sirve para caer, en el espacio de los embeddings, cerca de los fragmentos que dicen cosas de esa forma.
Varias consultas. El modelo escribe tres o cuatro formulaciones de la misma pregunta, se busca con todas y las listas se funden con RRF, la misma fusión de la sección anterior.
Descomponer. Una pregunta compuesta se parte en subpreguntas y se busca cada una. Y aquí aparece el límite de todo este bloque. Con la pregunta de Albarán, la descomposición natural es «¿qué plan tiene el cliente de la incidencia 4812?» y «¿qué plazo de reembolso tiene ese plan?». La segunda no se puede buscar: «ese plan» no es una consulta. Para escribirla bien hay que saber que el plan es Equipo, y eso se sabe después de la primera búsqueda, no antes. Toda esta preparación ocurre a ciegas, antes de ver un solo resultado. En cuanto una consulta depende de lo que devolvió otra, reescribir no alcanza: hace falta volver a pasar por el modelo después de buscar, y eso ya no es una línea recta. Es un bucle.
RAG agéntico: el modelo decide cuándo y qué buscar
El cambio es de forma. En lugar de una tubería en la que la búsqueda ocurre en un punto fijo, el modelo trabaja en un bucle y la búsqueda es una herramienta que puede llamar. Lee lo que tiene, decide si le falta algo y, si le falta, escribe la consulta y elige dónde lanzarla. El resultado vuelve a su contexto como una observación, y el modelo decide otra vez. Cuando juzga que tiene lo necesario, responde.
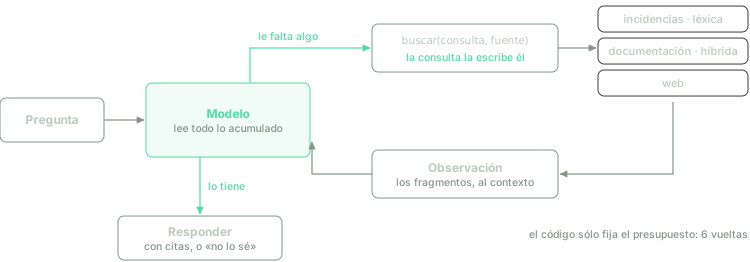
El pipeline convertido en bucle. Lo verde lo decide el modelo en cada vuelta; al código sólo le queda poner un límite.
La idea tiene fecha. ReAct (de Reasoning y Acting, razonar y actuar) es un método de prompting que publicaron en octubre de 2022 investigadores de Princeton y de Google. No necesita entrenar nada: con unos pocos ejemplos en el prompt, el modelo aprende a alternar pasos de razonamiento con acciones. En el artículo, las acciones eran llamadas a la API de Wikipedia (buscar una página, buscar una cadena dentro de ella, terminar), y el objetivo era responder las preguntas de varios saltos de HotpotQA, un conjunto de 113 000 preguntas publicado en 2018 y construido para que cada respuesta exija juntar datos de dos artículos distintos de Wikipedia. Un par de meses después, IRCoT (Interleaving Retrieval with Chain-of-Thought, intercalar la búsqueda con la cadena de razonamiento), otro método sin entrenamiento, de la Universidad de Stony Brook y el Allen Institute for AI, hizo lo mismo sin llamarlo agente: cada paso de la cadena de razonamiento servía de consulta para la búsqueda siguiente. Desde entonces no ha cambiado la idea, sino los modelos, que hoy se entrenan específicamente para llamar herramientas; con eso el bucle ha dejado de ser un experimento frágil y se ha convertido en la forma normal de construir un asistente. Es el mismo bucle que el de cualquier agente, y el curso de modelos de lenguaje y agentes lo construye pieza a pieza. Aquí interesa lo que cambia cuando la herramienta es un buscador.
Escrito como código, al lado de las dos líneas de antes:
def responder(pregunta, fuentes, max_pasos=6):
    contexto = [pregunta]
    for _ in range(max_pasos):
        paso = modelo(contexto, herramientas=fuentes)
        if paso.es_respuesta:
            return paso.texto
        resultados = fuentes[paso.fuente].buscar(paso.consulta)
        contexto.append((paso, resultados))
    return modelo(contexto, herramientas=None).texto
Las cuatro constantes de la versión ingenua se han convertido en decisiones que el modelo toma en
cada vuelta. Si busca: puede responder en la primera vuelta sin llamar a nada. Qué busca:
paso.consulta la escribe él, y la escribe después de haber leído todo lo anterior. Dónde:
paso.fuente elige entre índices distintos. Cuándo para: cuando decide responder. Al código sólo le
queda una decisión, el presupuesto de pasos, y la última línea dice qué pasa si se agota: se le pide
que responda con lo que tenga, ya sin herramientas.
Con la pregunta de Albarán, el recorrido es este:
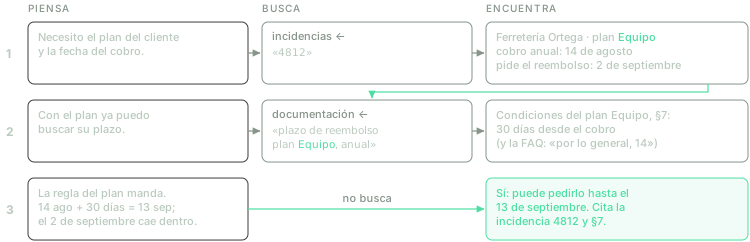
Tres vueltas. La palabra que hacía falta para la segunda búsqueda, «Equipo», sale del resultado de la primera. En la tercera no busca: tiene los dos datos y hace la cuenta.
La segunda vuelta es la que ningún pipeline podía dar. «Plazo de reembolso del plan Equipo, anual» es una consulta que nadie podía escribir antes de leer la incidencia. La traza tiene además dos detalles que importan. El primero es que cada fuente se busca con la herramienta que le conviene: las incidencias, por número, con búsqueda léxica; la documentación, con la híbrida. El eje de la sección anterior no desaparece: se mete dentro de cada herramienta. El segundo es que la búsqueda de la segunda vuelta devuelve también las preguntas frecuentes, con su «por lo general, 14 días», y el modelo tiene que decidir cuál de las dos reglas manda.
Juzgar lo que vuelve
Ese último punto, que es el fallo 5 y la mitad del 6, tiene su propia línea de trabajo, anterior a que los agentes fuesen lo normal. Self-RAG (Self-Reflective RAG, RAG con autorreflexión), de 2023, es un método de entrenamiento, y a la vez los modelos que salieron de él: investigadores de la Universidad de Washington, el Allen Institute for AI e IBM ajustaron Llama 2, de 7 000 y 13 000 millones de parámetros, para que emitiese, además del texto, unas fichas especiales de reflexión: si en ese punto le hacía falta buscar, si cada fragmento recuperado era relevante, si lo que acababa de escribir estaba respaldado por él y si la respuesta era útil. CRAG (Corrective RAG, RAG correctivo), de 2024, no toca el modelo que genera: es una pieza que se añade a cualquier pipeline RAG, propuesta por investigadores de la Universidad de Ciencia y Tecnología de China, UCLA y Google DeepMind. Consiste en un evaluador ligero (un T5 de 770 millones de parámetros, ajustado para esa tarea) colocado detrás del buscador, que clasifica lo recuperado como correcto, incorrecto o ambiguo. Si es incorrecto, lo descarta y sale a buscar a la web; si es correcto, lo depura antes de dárselo al generador y se queda sólo con las frases que importan.
Las dos son RAG agéntico por piezas: decisiones que antes tomaba el código, tomadas por un modelo, pero en puntos fijos y con componentes entrenados para cada una. En un sistema actual, con un modelo general que usa herramientas, las mismas decisiones se piden en el prompt de sistema («antes de responder, comprueba que cada fragmento que citas trata del caso preguntado; si dos fuentes se contradicen, di cuál aplicas y por qué; si no encuentras la respuesta, dilo») y el modelo las toma dentro del bucle. En la tercera vuelta de la traza es lo que ocurre: la regla del plan concreto manda sobre la general, y la respuesta lo dice.
Lo que cuesta darle el volante
Nada de esto sale gratis, y el precio es lo bastante alto como para que el RAG agéntico no deba ser la opción por defecto.
Latencia. Cada vuelta es una llamada al modelo más una búsqueda. Tres vueltas son, como poco, el triple de espera que una, y el modelo genera texto de razonamiento en cada una. Para una pregunta de soporte que se responde en diez segundos da igual; para un autocompletado o un asistente de voz, no.
Tokens. El contexto crece en cada vuelta: la pregunta, cada consulta y cada lote de fragmentos se acumulan, y cada llamada paga por todo lo anterior. Una traza de seis vueltas con cinco fragmentos por búsqueda mueve decenas de miles de tokens para responder con dos frases.
No determinismo. La misma pregunta, dos veces, puede seguir caminos distintos: otra consulta, otra fuente, una vuelta más. Depurar deja de ser mirar qué devolvió el índice y pasa a ser leer trazas. Sin registrar cada paso, un fallo no se puede reproducir.
Bucles. Un modelo que no encuentra lo que busca tiende a volver a buscarlo con otras palabras, y otra vez. Por eso el presupuesto de pasos no es opcional, y por eso conviene detectar consultas repetidas.
Un fallo nuevo. Al darle al modelo la decisión de buscar, también le das la de no hacerlo. Un modelo seguro de sí mismo puede responder de memoria una pregunta que tenía respuesta en el índice, y esa respuesta no lleva ninguna cita que la delate. El RAG ingenuo, con todos sus defectos, no podía cometer este error.
Con eso delante, la elección depende de las preguntas, no de la moda:
| Si tus preguntas… | Usa |
|---|---|
| caben enteras, con su corpus, en el contexto, y el corpus cambia poco | ningún índice: todo al contexto, con caché |
| se responden con un fragmento y no llevan códigos ni nombres exactos | RAG ingenuo |
| incluyen números de pedido, referencias, códigos de error o nombres | búsqueda híbrida, con o sin reordenador |
| llegan dentro de una conversación | reescritura de la consulta, siempre |
| necesitan un dato que sólo aparece en otro resultado, o varias fuentes | RAG agéntico |
| tienen que responderse en menos de un segundo | un pipeline fijo, por bueno que sea el agente |
La regla práctica es empezar por la fila más barata que funcione y subir cuando un fallo concreto, visto en preguntas reales, lo pida. Y para saber cuál es el fallo hay que medir.
Cómo saber si funciona
Un sistema RAG son dos sistemas, y hay que medirlos por separado, porque sus arreglos no se parecen en nada.
La búsqueda se mide sin el modelo de lenguaje. Hace falta un conjunto de preguntas reales (con treinta o cincuenta se puede empezar), cada una con los fragmentos que la responden anotados a mano. Con eso, la métrica principal es la cobertura en (recall@k): en qué proporción de preguntas los fragmentos necesarios están entre los recuperados. Si no están, ningún prompt lo arregla. El rango recíproco medio (MRR, Mean Reciprocal Rank) añade en qué posición aparecen, que importa por el fallo 5. Para cada pregunta se mira en qué puesto sale el primer fragmento correcto y se anota su inverso: 1 si sale el primero, si sale el segundo, si sale el tercero, y 0 si no sale. El MRR es la media de esos números. Con tres preguntas cuyo fragmento correcto sale el primero, el segundo y ninguna vez, vale . Cuanto más cerca de 1, más arriba llega lo bueno, que es donde el modelo mejor lo lee. Es el mismo inverso de la posición que usa RRF, pero aquí sirve para medir y no para fusionar.
La respuesta se mide sobre fragmentos que se sabe que eran buenos, y las preguntas son otras: si cada afirmación está respaldada por un fragmento (fidelidad), si responde a lo que se preguntó (relevancia) y si dice «no lo sé» cuando la respuesta no estaba en lo recuperado. Se evalúan normalmente con otro modelo como juez, al estilo que popularizó Ragas en 2023, y al juez hay que validarlo contra una muestra revisada a mano antes de fiarse de él.
El recorrido es la tercera cosa que medir en un sistema agéntico: cuántas vueltas da, si elige la fuente correcta, si se detiene cuando debe, y si responde sin buscar alguna pregunta que lo necesitaba.
La separación es lo que hace útil el diagnóstico. En Albarán, el pipeline ingenuo fallaba en la búsqueda: la incidencia no estaba entre los primeros, y la cobertura lo detecta. El híbrido fallaba en otro sitio: la cobertura de la incidencia era perfecta y la de las condiciones del plan, cero. Anotar todas las fuentes que necesita cada respuesta, y no sólo la primera, es lo que hace visible un problema de varios saltos antes de que llegue a un cliente.
Lo que viene después
Tres cosas se están moviendo a la vez.
Modelos entrenados para buscar. Self-RAG ya entrenaba la decisión de buscar; el paso siguiente ha sido entrenar el bucle entero. Search-R1 es un método de entrenamiento publicado en 2025 por investigadores de la Universidad de Illinois, la de Massachusetts y Google. Su nombre remite a DeepSeek-R1, el modelo que aprendió a razonar con aprendizaje por refuerzo, y hace lo mismo con la búsqueda: enseña a un modelo (en el artículo, Qwen 2.5 de 3 000 y 7 000 millones de parámetros) a intercalar razonamiento y llamadas a un buscador, y sólo premia que la respuesta final sea correcta. Los productos de investigación profunda que varios laboratorios lanzaron desde finales de 2024, que encadenan decenas de búsquedas antes de escribir un informe, son la versión industrial de la misma idea. Cuanto mejor aprende el modelo a buscar, menos comportamiento hay que escribir en el prompt.
La búsqueda como una herramienta más. Protocolos como MCP (Model Context Protocol, publicado por Anthropic a finales de 2024) convierten un índice en una herramienta que cualquier agente puede usar sin código a medida. El RAG deja de ser una arquitectura y pasa a ser una herramienta entre otras, junto a la que consulta una base de datos o lee un fichero, y el agente decide cuál usar. En Albarán, la herramienta de incidencias podría no ser un índice en absoluto: una consulta a la base de datos de soporte por número de incidencia es más fiable que cualquier búsqueda.
Contexto largo y búsqueda, juntos. Las ventanas de un millón de tokens no han acabado con el RAG, pero cambian su forma: con más sitio, se recuperan menos fragmentos y más grandes, o documentos enteros, y el fallo 3 pierde peso. La pregunta ha pasado de «¿buscar o meterlo todo?» a «¿cuánto meter después de buscar?».
Qué te llevas
Si te llevas una sola cosa, que sea ésta: la evolución del RAG no es una escalera, son dos ejes. Uno es qué encuentra la búsqueda, y se mejora con búsqueda léxica junto a la densa, fusión, reordenadores y fragmentos con contexto. El otro es quién decide la búsqueda, y se ha ido moviendo del código al modelo: primero la consulta, después si buscar, dónde y cuándo parar. Una pregunta de varios saltos sólo sale bien con los dos.
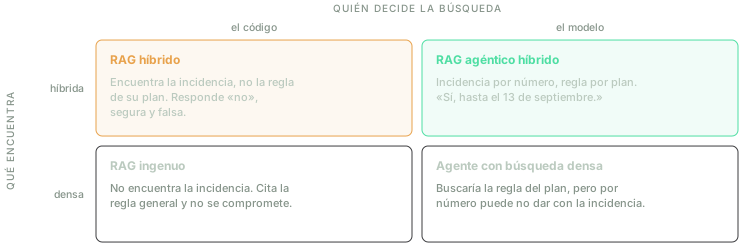
La pregunta de Albarán en los cuatro sistemas posibles. Mejorar sólo la búsqueda la vuelve más convincente sin volverla correcta; sólo responde bien el sistema que tiene los dos ejes.
Y si te llevas tres cosas más, que sean prácticas.
Mide la búsqueda antes de tocar el prompt. Treinta preguntas reales con sus fuentes anotadas (todas, no sólo la primera) te dicen si el problema está en encontrar o en usar lo encontrado. Sin eso, cada cambio es una apuesta.
Si tus usuarios escriben códigos, números o nombres, añade búsqueda léxica. Es la mejora más barata de todo el artículo: BM25 está disponible en casi cualquier motor de búsqueda y en muchas bases de datos, y RRF son diez líneas.
Dale el volante al modelo cuando la pregunta lo pida, no antes. El RAG agéntico se justifica cuando la consulta que hace falta depende de algo que sólo se sabe después de buscar. Si tus preguntas se responden con un fragmento, un agente te cobra latencia, tokens y trazas por decidir algo que el código ya decidía bien.