 Por Gustavo Torres
El asistente de soporte de Albarán, la empresa inventada del artículo anterior, aprendió hace poco a buscar en bucle. Ya no contesta «no» a la pregunta de la incidencia 4812: lee la incidencia, saca de ella el plan del cliente, busca las condiciones de ese plan y responde bien, con dos citas. Hasta que la responsable de soporte le hace otra pregunta:
¿Por qué nos están pidiendo reembolsos este trimestre?
El asistente da tres vueltas, lee veinte incidencias y contesta con seis citas:
Los dos motivos principales son los cobros duplicados tras el cambio de pasarela de pago, en agosto, y la subida de precio del plan Básico, en julio. [Incidencias 4182, 4377, 4590, 4821, 4903, 5011]
Las seis citas existen y dicen lo que la respuesta dice que dicen. Y la respuesta está mal. Entre julio y septiembre hay 900 incidencias en las que un cliente pide que le devuelvan dinero o que le den de baja. La causa más frecuente, con 340, no aparece: desde la versión 3.2, publicada en julio, las facturas rectificativas salen en PDF con el total del IVA mal, y los clientes que las necesitan se quieren ir. Sus incidencias hablan de «rectificativas», de «PDF», de «baja» y de «devolución», y casi nunca dicen «reembolso». Las veinte que leyó el asistente eran las que más se parecían a la pregunta, y la pregunta decía «reembolso».
Nada de lo que arreglaba el artículo anterior sirve aquí. El fallo no es de puntería: cada incidencia recuperada habla, de verdad, de reembolsos. Tampoco es de control: el modelo decidió qué buscar, buscó tres veces y se paró cuando creyó tener bastante. El problema es la pregunta. Todas las preguntas de aquel artículo tenían la respuesta escrita en algún documento, y el trabajo consistía en encontrarlo. Ésta no. Ninguna incidencia dice «la causa principal de los reembolsos de este trimestre es la versión 3.2». La respuesta está en el conjunto, y un buscador devuelve fragmentos: una muestra, que el modelo resume como si fuese el conjunto. El artículo de Microsoft que en 2024 dio nombre a GraphRAG describe este fallo casi con esas palabras: muestras de hechos recuperados presentadas como si fuesen un resumen global.
GraphRAG se suele contar como el paso siguiente del RAG: el mismo sistema con un grafo dentro, y mejor. Esa versión tiene dos problemas. El primero es que «GraphRAG» no nombra una técnica, sino por lo menos tres, que sólo comparten la palabra «grafo» y que responden a preguntas distintas. El segundo es que, medido con cuidado, un grafo empeora las respuestas a las preguntas sencillas, y cuesta caro. Aquí van las tres, con sus fuentes, y al final la pregunta que importa: cuándo hace falta cada una, y cuándo ninguna.
Cuatro sitios donde puede estar una respuesta
Antes de hablar de grafos conviene mirar las preguntas. La misma base de conocimiento, la de Albarán, admite preguntas cuya respuesta vive en sitios muy distintos:
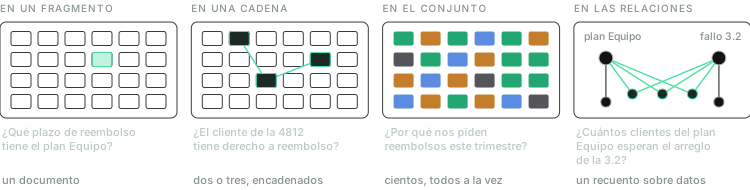
Cuatro preguntas sobre los mismos documentos. Las dos primeras las resolvía el artículo anterior; las dos últimas son el territorio de GraphRAG.
En un fragmento. «¿Qué plazo de reembolso tiene el plan Equipo?» lo responde, entera, la sección 7 de las condiciones del plan. Es la pregunta para la que se inventó el RAG, y la búsqueda híbrida del artículo anterior la resuelve sola.
En una cadena. «¿El cliente de la incidencia 4812 tiene derecho a reembolso?» necesita dos documentos, y el segundo sólo se puede buscar después de leer el primero. Es la pregunta de varios saltos, la que el RAG agéntico resuelve dando vueltas.
En el conjunto. «¿Por qué nos piden reembolsos este trimestre?» no la responde ningún documento ni ninguna cadena corta. La respuesta es un resumen de cientos de incidencias, y para escribirlo hay que haberlas leído todas.
En las relaciones. «¿Cuántos clientes del plan Equipo esperan el arreglo de la 3.2?» tiene por respuesta un número, 23. Un número así no se recupera: se calcula, cruzando qué plan tiene cada cliente con qué incidencias ha abierto.
Lo que le pasó al asistente se ve al comparar lo que había con lo que leyó:
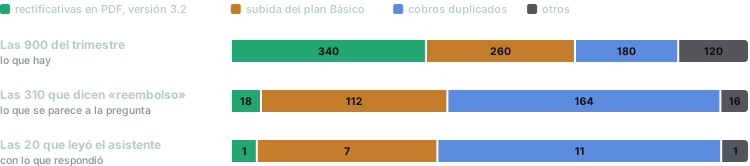
Quien ha pagado dos veces pide un reembolso; quien no puede emitir una rectificativa pide la baja. La búsqueda eligió entre las que se parecían a la pregunta, y la muestra salió torcida antes de que el modelo leyese nada.
Un buscador ordena por parecido con la consulta, y el parecido no es representatividad. Dar más vueltas no lo arregla. Un agente puede buscar seis veces en lugar de tres y leer 120 incidencias en lugar de 20, pero cada consulta la escribe a partir de lo que ya ha leído, y en lo que ha leído no hay nada que le haga pensar en un PDF. Es el fallo 4 del artículo anterior (el dato que hace falta para buscar está en un resultado) llevado a la escala del corpus: aquí está en 340 resultados que la búsqueda nunca devuelve. Y aunque los leyera todos, una búsqueda no sabe contar.
En estos dos artículos, «agente» no significa que el sistema haga cosas en el mundo, como emitir un reembolso o mandar un correo: significa que el modelo decide los pasos. El asistente de Albarán sólo lee, y aun así es un agente en ese sentido.
Queda la opción de pegarlo todo en el contexto. Novecientas incidencias caben en una ventana de un millón de tokens, y para una pregunta que se hace una sola vez puede ser lo razonable. Pero la pregunta se va a repetir cada trimestre, las incidencias de un año ya no caben, y el artículo anterior contaba lo que le pasa a la información que queda a mitad de un contexto largo.
Qué es un grafo, y de dónde sale
Un grafo de conocimiento guarda hechos como tripletas: un sujeto, una relación y un objeto. (Ferretería Ortega, tiene, plan Equipo). (incidencia 5120, afecta a, versión 3.2). Cada sujeto y cada objeto es un nodo, y cada relación, una arista entre dos nodos. Lo que un grafo sabe hacer, y un montón de fragmentos no, es seguir una arista: desde la incidencia se llega al cliente, desde el cliente al plan y desde el plan a sus condiciones, sin que ningún documento contenga los tres datos a la vez.
La idea es anterior a los modelos de lenguaje. Google presentó en mayo de 2012 su Knowledge Graph con un lema que resume el cambio, «cosas, no cadenas», y más de 500 millones de objetos y más de 3 500 millones de hechos y relaciones entre ellos. Durante la década siguiente, un grafo así era algo que construían empresas con equipos dedicados a decidir el esquema y a rellenarlo. Los modelos de lenguaje no cambiaron la idea. Cambiaron quién rellena el grafo.
Hoy un grafo puede salir de tres sitios, y el sitio decide lo que el grafo puede responder.
Ya existe. En Albarán, el CRM (Customer Relationship Management, el sistema donde la empresa guarda sus clientes y su historial comercial) sabe qué plan tiene cada cliente, y el sistema de incidencias sabe qué cliente abrió cada una, en qué estado está y con qué otras está enlazada. Nadie tuvo que extraer esas relaciones: alguien las escribió, campo a campo, cuando ocurrieron. Son exactas y baratas de consultar, y sólo contienen lo que alguien decidió guardar.
Lo extrae un modelo de lenguaje leyendo el texto. Se le pasa cada fragmento y se le pide que devuelva las tripletas que contiene:
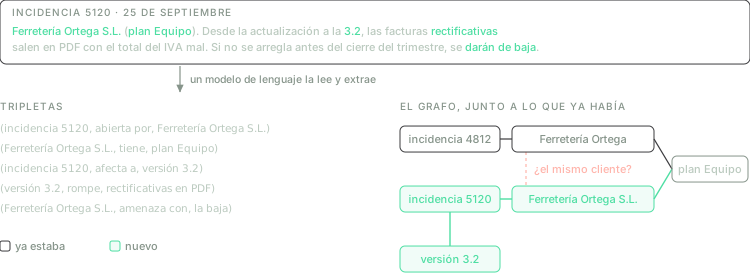
La incidencia que Ferretería Ortega abrió el 25 de septiembre, convertida en tripletas. El modelo no sabe que «Ferretería Ortega» y «Ferretería Ortega S.L.» son el mismo cliente, y el grafo acaba con dos nodos para él.
Es la opción más rica, porque saca relaciones que no están en ningún campo (que la versión 3.2 rompe las rectificativas no lo dice ninguna columna de ninguna tabla), y tiene tres costes. El primero es el dinero: hay que pasar el corpus entero por el modelo, y volver a pasar lo que cambie. El segundo es el de la figura: reconciliar los nombres distintos de una misma cosa es un problema con nombre propio, la resolución de entidades, y el artículo de GraphRAG de Microsoft lo resolvía con la regla más sencilla posible, que dos nodos son el mismo si su nombre coincide letra a letra. El tercero es lo que se pierde. En una comparación controlada de 2025, el grafo que GPT-4o-mini extrajo de los documentos de HotpotQA, un conjunto de preguntas de varios saltos sobre artículos de Wikipedia, contenía el 65,8 % de las entidades que eran la respuesta a alguna pregunta. Una de cada tres respuestas no estaba en el grafo, aunque estuviese en el texto. Los autores eligieron ese modelo por coste. Con GPT-4o extrayendo el grafo, las respuestas mejoraban de forma consistente, aunque no volvieron a contar cuántas entidades se perdían.
Lo extrae un procesamiento barato. Sin modelo de lenguaje: se sacan las frases nominales de cada fragmento con técnicas clásicas de procesamiento del lenguaje y se unen las que aparecen juntas. El grafo resultante es tosco (dice que dos conceptos van juntos, no qué relación tienen), y cuesta lo mismo que indexar para un RAG normal.
Con esas tres fuentes, las técnicas que se venden como GraphRAG hacen tres cosas distintas: usan el grafo como mapa, lo usan como memoria o lo consultan. Van en ese orden.
El grafo como mapa: resumir el conjunto
Antes del grafo, un árbol
La primera respuesta seria a las preguntas globales no tenía grafo. RAPTOR, publicado en enero de 2024 por un grupo de Stanford, agrupa los fragmentos de un documento por parecido, escribe con un modelo un resumen de cada grupo, agrupa los resúmenes y los vuelve a resumir, y repite hasta quedarse con un árbol cuyas hojas son el texto original y cuya raíz resume el documento entero. Al preguntar, busca a la vez en todos los niveles: una pregunta concreta cae en las hojas, y una general, en los resúmenes. El artículo lo motiva con una pregunta sobre un cuento, «¿cómo consiguió Cenicienta su final feliz?», que ningún fragmento corto responde, y con GPT-4 mejoró en 20 puntos absolutos el mejor resultado publicado en QuALITY, un conjunto de preguntas sobre textos largos.
RAPTOR agrupa por parecido del texto. GraphRAG agrupa por entidades conectadas.
GraphRAG, pieza a pieza
From Local to Global, el artículo de Microsoft Research que se publicó en abril de 2024 (el código salió en julio), convierte el corpus en un mapa antes de que llegue ninguna pregunta:
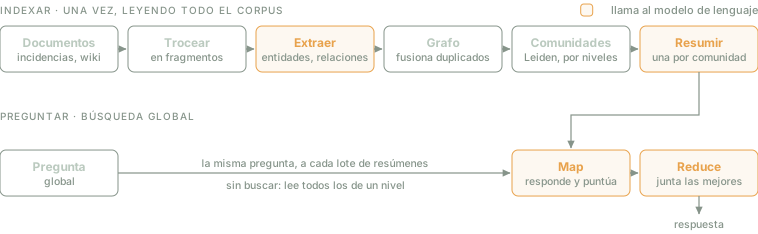
Los mismos dos carriles que el RAG del artículo anterior. Cambia dónde está el modelo: al indexar lee el corpus entero dos veces, una para extraer y otra para resumir, y al preguntar no hay búsqueda.
Extraer. Cada fragmento pasa por un modelo que devuelve entidades, relaciones y afirmaciones (fechas, hechos, sucesos), cada una con una descripción breve. Una relación que aparece en muchos fragmentos se convierte en una arista con más peso.
Comunidades. Sobre el grafo se ejecuta Leiden, un algoritmo de 2019 que parte un grafo en grupos de nodos más conectados entre sí que con el resto. Lo hace por niveles: grupos grandes, dentro de ellos subgrupos, y así hasta que no se pueden partir más. Leiden corrige a Louvain, el algoritmo clásico para esta tarea, que en los experimentos de sus autores dejaba desconectadas hasta el 16 % de las comunidades.
Resumir. Cada comunidad recibe un informe escrito por el modelo, de abajo arriba: las comunidades pequeñas se resumen a partir de sus entidades y relaciones, y las grandes, a partir de los informes de sus subcomunidades. El resultado es un índice que se puede leer sin preguntar nada: un informe por tema, a varias escalas.
Preguntar. La búsqueda global no busca. Toma todos los informes de un nivel, los baraja, los reparte en lotes que quepan en el contexto y le hace la misma pregunta a cada lote. En ese paso, llamado map, cada lote devuelve una respuesta parcial y una nota de 0 a 100 sobre cuánto ayuda, y las de nota 0 se descartan. El paso reduce ordena el resto por nota y junta las mejores, hasta llenar el contexto, en la respuesta final. Hay también una búsqueda local, que parte de las entidades de la pregunta y reúne su vecindario en el grafo, pensada para preguntas concretas.
Con las incidencias de Albarán, la diferencia está en la extracción. El modelo lee las 340 incidencias de la versión 3.2 aunque no digan «reembolso», y en todas encuentra las mismas entidades: la versión 3.2, las facturas rectificativas, la exportación a PDF. Esas entidades acaban muy conectadas entre sí, Leiden las pone en la misma comunidad y el modelo le escribe un informe sobre clientes que amenazan con la baja porque sus rectificativas salen mal. Cuando llega la pregunta de la responsable de soporte, ese informe ya existe, y en el paso map saca una nota alta. Ninguna búsqueda tuvo que acertar con la palabra «PDF».
Lo que da el mapa es la forma del conjunto: qué temas hay y, con suerte, cuál pesa más. No da un recuento exacto (un informe dice «numerosos clientes», no «340»). Eso es trabajo de la tercera familia.
Cómo lo midieron. Sobre dos corpus de alrededor de un millón de tokens, las transcripciones de un pódcast de tecnología y un conjunto de noticias, un modelo generó 125 preguntas globales por corpus, imaginando usuarios y tareas, y otro modelo hizo de juez comparando respuestas por pares. Frente a un RAG normal, las de GraphRAG ganaban en exhaustividad entre el 72 y el 83 % de las veces, y en diversidad, entre el 62 y el 82 %. El RAG normal ganaba en el criterio de control, lo directa que era la respuesta. Y responder con los informes del nivel superior, los más resumidos, costaba más de un 97 % menos de tokens por pregunta que aplicar el mismo map-reduce al texto original, perdiendo poco.
Dos asteriscos, a los que vuelve la sección de comparaciones. No había respuestas de referencia: todo lo decidió un modelo juez. Y el mapa se paga por adelantado: indexar el pódcast, unos 1 700 fragmentos de 600 tokens, llevó 281 minutos de llamadas a GPT-4 Turbo.
Pagar la lectura al preguntar
El mapa se paga entero antes de la primera pregunta, y cada documento nuevo cambia entidades, relaciones y comunidades, cuyos informes hay que volver a escribir. Si el corpus cambia cada día, o si le vas a hacer pocas preguntas globales, el mapa no se amortiza. Casi todo lo que vino después de GraphRAG son formas de pagar menos.
LightRAG, de investigadores de Hong Kong y Pekín, en octubre de 2024, renuncia a las comunidades. Guarda el grafo junto a un índice de vectores, y al preguntar el modelo escribe dos clases de claves: concretas, que buscan entidades, y generales, que buscan relaciones y temas. Un documento nuevo se añade al grafo sin reconstruir nada. En la cuenta de sus propios autores, sobre un corpus legal, la búsqueda global de GraphRAG leía 610 informes de unos 1 000 tokens por pregunta, en cientos de llamadas, y LightRAG usaba menos de 100 tokens en una sola.
LazyGraphRAG, del propio Microsoft, en noviembre de 2024, lleva la idea al extremo, y el nombre ya lo dice: es perezoso. No usa el modelo de lenguaje al indexar. Extrae frases nominales, las une por coaparición y saca las comunidades con estadísticas del grafo, así que indexar cuesta lo mismo que para un RAG normal, un 0,1 % de lo que cuesta el GraphRAG completo. Todo el trabajo se hace al preguntar. La pregunta se parte en tres a cinco subpreguntas; para cada una se ordenan los fragmentos por parecido y las comunidades por sus mejores fragmentos; un modelo juzga, frase a frase, si lo que lee es relevante; y la búsqueda baja a las subcomunidades cuando varias seguidas no aportan nada. Un único parámetro, el presupuesto de pruebas de relevancia (100, 500 o 1 500 en sus experimentos), fija cuánto gasta cada pregunta. En la evaluación de Microsoft, sobre 5 590 noticias de la agencia AP, igualaba en preguntas globales a la búsqueda global de GraphRAG con un coste por pregunta más de 700 veces menor.
Esa es la variable que ordena esta rama: cuándo se paga la lectura del corpus. GraphRAG la paga entera al indexar, para que cada pregunta global sea rápida; LazyGraphRAG no paga casi nada al indexar y paga, al preguntar, lo que cada pregunta necesita. Cuál conviene depende de cuántas preguntas globales vayas a hacerle al mismo corpus.
El grafo como memoria: conectar en un paso
La segunda familia usa el grafo para otra cosa. No quiere resumir el corpus, sino encontrar lo que está conectado con la pregunta aunque no se parezca a ella.
La pregunta de la incidencia 4812 es el ejemplo. El asistente del artículo anterior la resolvía en tres vueltas: buscaba la incidencia, leía en ella que el cliente tenía el plan Equipo y buscaba entonces las condiciones de ese plan. Tres llamadas al modelo y dos búsquedas, una detrás de otra, para seguir una cadena que en un grafo ya está dibujada: la incidencia 4812 está unida a Ferretería Ortega, Ferretería Ortega al plan Equipo y el plan Equipo a sus condiciones.
HippoRAG, publicado en mayo de 2024 por la Universidad Estatal de Ohio y Stanford, aprovecha exactamente eso, y lo hace inspirándose en una teoría sobre la memoria humana. La teoría del índice hipocampal, de 1986, propone que los recuerdos se guardan en la corteza y que el hipocampo guarda otra cosa: un índice de asociaciones entre ellos, con el que se recupera un recuerdo completo a partir de una pista parcial. En HippoRAG, el modelo de lenguaje hace de corteza: lee cada pasaje y extrae sus tripletas, sin esquema fijo. El grafo de esas tripletas hace de hipocampo. Y un modelo de embeddings añade aristas de sinónimos entre frases muy parecidas, que es una solución aproximada al problema de «Ferretería Ortega» y «Ferretería Ortega S.L.».
Al preguntar, el modelo saca las entidades de la pregunta, se localizan en el grafo, y desde ellas se ejecuta un PageRank personalizado: un paseo aleatorio por el grafo que en cada paso tiene una probabilidad fija de volver a los nodos de partida (0,5 en HippoRAG). Después de muchos pasos, la probabilidad se acumula en los nodos cercanos a los de partida, y más en los cercanos a varios a la vez. Cada pasaje recibe la suma de la probabilidad de las frases que contiene. Hay un detalle que importa: cada nodo de partida pesa menos cuantos más pasajes lo mencionan, que es lo mismo que hace la búsqueda léxica con las palabras comunes. «4812» aparece en un pasaje; «reembolso», en muchos.
Con un índice de juguete de Albarán, el cálculo da esto:
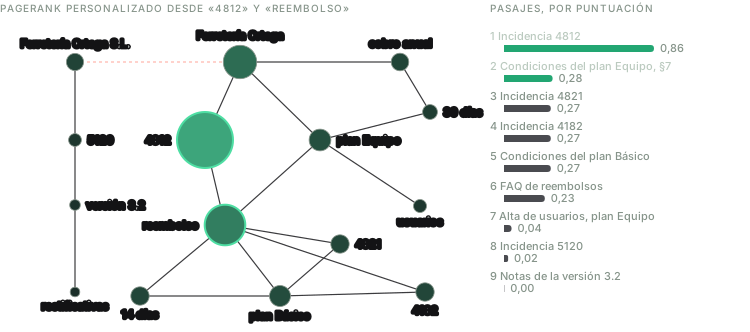
El grafo es inventado; el orden de la derecha está calculado, con el PageRank personalizado y la ponderación de HippoRAG. Los dos primeros pasajes son los dos que hacían falta.
Los dos primeros pasajes son exactamente los que hacían falta, y salen de una sola búsqueda. Nadie escribió la palabra «Equipo»: la probabilidad llegó al plan Equipo desde la incidencia, a través del cliente, y de ahí a las condiciones del plan. En este grafo la ventaja de las condiciones sobre el pasaje siguiente es pequeña, 0,28 frente a 0,27, porque en un índice de nueve pasajes casi todo lo que menciona «reembolso» puntúa parecido. En un índice real, «reembolso» aparece en cientos de pasajes y su peso se reparte entre todos.
En los conjuntos de preguntas de varios saltos, HippoRAG mejoró hasta en 20 puntos a los mejores buscadores publicados, y su búsqueda en un solo paso igualó o superó a IRCoT, el método que intercala búsqueda y razonamiento en bucle y que el artículo anterior presentaba junto a ReAct, siendo entre 10 y 20 veces más barata y entre 6 y 13 veces más rápida.
Hay un caso en el que esta memoria hace algo que al agente le cuesta de verdad. El artículo de HippoRAG lo ilustra con una pregunta: «¿qué profesor de Stanford investiga la neurociencia del alzhéimer?». En un corpus con miles de pasajes sobre profesores de Stanford y miles sobre investigadores del alzhéimer, ninguno dice las dos cosas. Un agente no sabe por dónde empezar: cualquier búsqueda le devuelve cientos de candidatos de uno de los dos lados. El PageRank personalizado arranca desde los dos nodos a la vez, y la probabilidad se acumula en el profesor que está unido a ambos.
El problema de esta familia lo sacaron a la luz las comparaciones. Un grafo de tripletas pierde detalle, y en las preguntas de un solo dato los métodos con grafo rendían peor que un RAG normal. HippoRAG 2, de febrero de 2025 y presentado en ICML 2025 (International Conference on Machine Learning, uno de los grandes congresos de aprendizaje automático), lo corrigió metiendo los pasajes en el grafo como nodos propios y haciendo que el modelo descarte, al preguntar, las tripletas que no vienen al caso. Según sus autores, supera a un RAG normal en las preguntas de un dato, en las de comprensión de textos largos y en las de varios saltos, donde mejora en un 7 % al mejor modelo de embeddings que probaron.
El grafo que ya tienes: consultar, no recuperar
La tercera pregunta de Albarán no necesita que nadie extraiga ningún grafo:
¿Cuántos clientes del plan Equipo tienen abierta una incidencia por el fallo de las rectificativas de la 3.2?
La respuesta es 23, y ni un buscador ni un mapa la pueden dar. Un buscador devuelve una muestra; el mapa, un informe que dice «numerosos clientes»; un grafo extraído por un modelo, un recuento sobre un grafo al que le puede faltar una de cada tres entidades. Pero las relaciones que hacen falta ya están guardadas, y son exactas: el CRM sabe qué plan tiene cada cliente, y el sistema de incidencias sabe quién abrió cada una, si sigue abierta y a qué fallo está enlazada. Lo que el modelo tiene que hacer no es recuperar, sino escribir una consulta:
MATCH (c:Cliente)-[:TIENE]->(:Plan {nombre: "Equipo"}),
      (c)-[:ABRIO]->(:Incidencia {estado: "abierta"})-[:ENLAZADA_A]->(:Fallo {id: "PDF-RECT-3.2"})
RETURN count(DISTINCT c)
Está en Cypher, el lenguaje de consulta de la base de datos de grafos Neo4j, pero la misma pregunta se escribe en SQL sobre las tablas del CRM, y los modelos actuales escriben bien las dos. El recuento lo hace la base de datos, que no se equivoca contando.
El caso publicado que más se parece a Albarán es de LinkedIn. Su sistema de soporte, presentado en SIGIR 2024 (Special Interest Group on Information Retrieval, el principal congreso sobre búsqueda y recuperación de información), parte de una observación sencilla: una incidencia de Jira no es texto plano. Tiene secciones (resumen, descripción, prioridad, causa raíz, pasos para reproducirla) y enlaces explícitos a otras incidencias, como «clonada de». El sistema convierte cada incidencia en un árbol de secciones, une los árboles con esos enlaces y con otros implícitos, entre incidencias de título parecido, y guarda el resultado en Neo4j. Al preguntar, un modelo identifica en la pregunta qué secciones y qué valores menciona, localiza las incidencias con embeddings sección a sección y reescribe la pregunta como una consulta Cypher sobre el grafo, del estilo de «dame los pasos para reproducir la incidencia ENT-22970». Frente a un RAG sobre el texto de las incidencias, el rango recíproco medio (una métrica que vale 1 si la incidencia correcta sale la primera, 1/2 si sale la segunda, y así) subió de 0,522 a 0,927, un 77,6 %. En producción, repartieron al azar a su equipo de soporte en dos grupos durante unos seis meses, y el que usaba el sistema resolvía cada incidencia en una mediana de 5 horas, frente a 7: un 28,6 % menos. Dos avisos al leerlo. El artículo no dice cuántas preguntas tenía el conjunto con el que midieron, y la comparación en producción es contra el grupo que trabajaba sin herramienta, no contra otro RAG.
Cuando el grafo es enorme y público, como Wikidata, la consulta no siempre se puede escribir de una vez, porque el modelo no conoce sus relaciones. Think-on-Graph, presentado en ICLR 2024 (International Conference on Learning Representations, otro de los grandes congresos de aprendizaje automático), hace que el modelo lo explore como un agente: parte de las entidades de la pregunta, en cada paso elige qué relaciones seguir y se queda con los caminos más prometedores, en una búsqueda en haz. Su ejemplo es «¿qué partido tiene hoy la mayoría en el país donde está Canberra?». El modelo, por sí solo, contesta con lo que sabía en 2021. Una consulta escrita de golpe en SPARQL, el lenguaje de consulta estándar de este tipo de grafos, falla porque el grafo no tiene ninguna relación «partido mayoritario». Explorando, el modelo va de Canberra a Australia, de Australia a su primer ministro y del primer ministro a su partido. Sin entrenar nada, logró el mejor resultado publicado en 6 de los 9 conjuntos de preguntas que probó.
Esta familia tiene su propio límite. Una comparación de doce métodos con grafo, publicada en VLDB 2025 (Very Large Data Bases, uno de los dos grandes congresos de bases de datos), encontró que los que responden sólo con el grafo, como Think-on-Graph, lo hacen mal cuando la respuesta está en un texto: sin los fragmentos originales, faltan los detalles. Consultar el grafo es lo correcto cuando la respuesta es una relación. Cuando es una frase, hay que volver al texto.
La regla práctica es corta. Si una relación ya está en una base de datos, consúltala. Extraerla del texto con un modelo de lenguaje es construir, y caro, una copia peor de algo que ya tenías.
Lo que dicen las comparaciones
Entre 2024 y 2026 aparecieron decenas de variantes de GraphRAG, casi todas evaluadas por sus autores con sus propias preguntas. Desde 2025 hay comparaciones controladas: los mismos corpus, el mismo modelo, las mismas condiciones. Cuatro sirven para decidir.
RAG y GraphRAG se complementan. La comparación de 2025 que contaba las entidades perdidas encontró que el RAG normal gana en las preguntas de un solo salto y en las que piden un detalle concreto, y el GraphRAG, en las de varios saltos. La búsqueda global de Microsoft, en particular, sacrifica detalles: frente a resúmenes de referencia escritos por personas, los del RAG normal se parecían más. Y el hallazgo más incómodo es sobre la evaluación. Cuando un modelo juez compara dos resúmenes, cambiar el orden en que los lee cambia el veredicto, en algunos casos hasta darle la vuelta. Con el orden controlado y preguntas sobre personajes o sucesos concretos, el juez prefería el RAG normal en exhaustividad y la búsqueda global en diversidad. Es el mismo tipo de juez que sostenía los resultados originales de GraphRAG, aunque aquellas preguntas eran globales de verdad.
El grafo ayuda cuando la pregunta se complica, y estorba cuando es sencilla. GraphRAG-Bench (ICLR 2026) mide siete métodos con grafo contra un RAG normal, sobre novelas y guías médicas, con preguntas de dificultad creciente. En las de un dato, el RAG normal recupera el 83,2 % de la evidencia necesaria, más que cualquier grafo, que trae información relacionada pero redundante. En las de los niveles 2 y 3, HippoRAG recupera entre el 87,9 y el 90,9 %. Y el coste por pregunta varía en casi tres órdenes de magnitud:
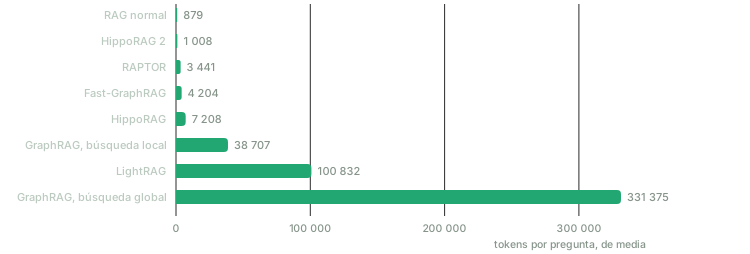
Tokens por pregunta, de media, en el conjunto de novelas de GraphRAG-Bench (tablas 6 y 7). Es el coste total de responder, no el tamaño de un prompt: la búsqueda global reparte el suyo entre muchas llamadas. HippoRAG 2 cuesta casi lo mismo que un RAG normal.
Doce métodos, las mismas piezas. La comparación de VLDB 2025 desmonta doce métodos con grafo en cuatro piezas comunes y los mide en las mismas condiciones. Confirma que, para preguntas abstractas, los informes de comunidades de Microsoft son la mejor estructura, y les pone precio: en uno de sus conjuntos, cada pregunta de la búsqueda global tardaba unos 9 minutos y gastaba unos 300 000 tokens, 57 veces más tiempo y 210 veces más tokens que un RAG normal.
Los agentes acortan la distancia. La última pregunta es la que dejaba abierta el artículo anterior: si un agente que busca en bucle ya sigue cadenas, ¿sigue haciendo falta el grafo? Do We Still Need GraphRAG?, de abril de 2026, lo mide. Con una sola búsqueda, el GraphRAG gana por 27 puntos de media en preguntas de varios saltos y por medio punto en las generales. Con un agente encima, el RAG normal mejora y recorta parte de esa distancia, y con modelos más grandes la recorta más: en los agentes entrenados, pasar de 3 000 a 7 000 millones de parámetros la reduce de 14,7 a 9,75 puntos. Pero no la cierra, y el grafo da resultados más estables de una ejecución a otra. La conclusión de sus autores es la mejor frase para resumir el estado de la cuestión: los agentes no sustituyen a la estructura, cambian de sitio parte de ella, de la construcción del grafo por adelantado a la interacción al preguntar.
Una advertencia al leer esto último: los modelos de ese estudio van de 3 000 a 32 000 millones de parámetros. Que con los modelos más grandes de hoy la distancia se estreche todavía más es lo que sugiere su propia tendencia, no algo que hayan medido.
Lo que viene
Grafos como entorno de un agente entrenado. Search-R1, del artículo anterior, entrenaba con aprendizaje por refuerzo a un modelo para intercalar razonamiento y búsquedas. Graph-R1 (ICML 2026) hace lo mismo con un grafo: construye un hipergrafo ligero, con aristas que unen más de dos nodos a la vez, y entrena de principio a fin a un agente que piensa, consulta, recupera un subgrafo y vuelve a pensar. De momento no es la última palabra: en la comparación de 2026, un agente sin entrenar pero con un flujo bien diseñado, que descompone la pregunta y busca de forma estructurada, superaba en general tanto a Search-R1 como a Graph-R1.
Grafos con fecha. Un hecho de un grafo puede dejar de ser cierto. Si Ferretería Ortega hubiese cambiado de plan en julio, ¿qué plan tenía el día del cobro? Los grafos temporales, como el de Zep, de enero de 2025, no borran la arista vieja: le ponen fecha de fin, y cada relación guarda desde cuándo y hasta cuándo fue cierta. Es la dirección que está tomando la memoria de los agentes.
El recorrido de Microsoft. La empresa que popularizó el nombre es un buen termómetro. LazyGraphRAG no ha llegado a su biblioteca de código abierto: en junio de 2025 se integró en Microsoft Discovery, su plataforma de investigación científica, y en una versión preliminar de Azure Local. La biblioteca siguió publicando versiones (la 3.0, en enero de 2026, la partió en paquetes), y en agosto de 2026 su página del repositorio empezó a avisar de que, desde la primera versión, en julio de 2024, las capacidades de los modelos punteros han cambiado mucho, y de que el proyecto está en gran parte en modo de mantenimiento. Mientras tanto, en su conferencia Build de 2026, Microsoft anunció la disponibilidad general de Graph in Fabric, un servicio para declarar un grafo sobre los datos de negocio de cada empresa, pensado como contexto para sus agentes. Leído junto al resto del artículo, el movimiento tiene sentido: el pipeline que extraía un grafo del texto por adelantado pierde peso, y ganan las otras dos opciones, el grafo que se construye al preguntar y el grafo que ya existe.
Cuándo hace falta un grafo
Con todo lo anterior, la elección depende de dónde vive la respuesta, no del nombre de moda:
| Si la respuesta está… | En Albarán | Usa |
|---|---|---|
| en un corpus que cabe entero en el contexto | cualquier pregunta | ningún índice: todo al contexto, con caché |
| en un fragmento | «¿Qué plazo tiene el plan Equipo?» | RAG híbrido, sin grafo |
| en una cadena de documentos, o en el cruce de dos pistas muy frecuentes | «¿La 4812 tiene derecho a reembolso?» | un agente; una memoria asociativa como HippoRAG si el bucle es lento o caro |
| en el conjunto de un corpus de texto | «¿Por qué piden reembolsos?» | un mapa: comunidades con informes si las preguntas globales se repiten; un mapa perezoso si son pocas o el corpus cambia a menudo |
| en relaciones que ya están en una base de datos | «¿Cuántos clientes del plan Equipo…?» | una consulta que escribe el modelo; ningún grafo extraído |
Antes de construir nada, clasifica tus preguntas. Toma cincuenta reales y apunta, para cada una, dónde está su respuesta. Si casi todas están en un fragmento o en una cadena corta, no necesitas un grafo, y las comparaciones de 2025 dicen que empeoraría tus respuestas sencillas. Si hay preguntas globales, cuenta cuántas hay y con qué frecuencia se repiten sobre el mismo corpus, porque eso decide si el mapa se amortiza. Y mide contra una referencia seria, un agente con búsqueda híbrida y no un RAG ingenuo, con respuestas de referencia escritas por alguien. Si además usas un modelo juez, enséñale las dos respuestas en los dos órdenes.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: «GraphRAG» no es una técnica, son tres grafos distintos para tres preguntas distintas. Un mapa del corpus, para las preguntas cuya respuesta es el conjunto. Una memoria asociativa, para seguir cadenas en un solo paso. Y el grafo que ya tienes en tus bases de datos, para las preguntas cuya respuesta es una relación o un recuento. Antes de elegir uno, pregúntate dónde vive la respuesta.
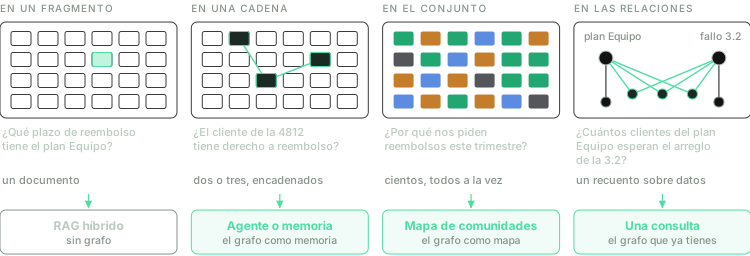
Las preguntas del principio, con su herramienta. La primera no necesita grafo; cada una de las otras tres tiene el suyo, aunque la segunda puede pasar sin él si un agente da las vueltas.
Y si te llevas tres cosas más, que sean prácticas.
Si la relación ya está en una base de datos, consúltala. Es la opción más barata de las tres y la única exacta. Un grafo extraído por un modelo es una copia con pérdidas de lo que ya tenías.
Paga el mapa sólo si lo vas a usar. Construir comunidades e informes obliga a leer el corpus entero con un modelo, y cada pregunta global sigue costando cientos de miles de tokens. Si las preguntas globales son pocas, o el corpus cambia cada día, paga la lectura al preguntar.
Antes que un grafo para varios saltos, prueba un agente. Es lo que ya tienes si seguiste el artículo anterior, y con modelos grandes recorta buena parte de la ventaja del grafo. Pasa a una memoria asociativa cuando el bucle sea demasiado lento o demasiado caro, o cuando tus preguntas crucen dos pistas que, por separado, aparecen en miles de documentos.