 Por Gustavo Torres
Una tienda online tiene una tabla clientes con 200 000 filas y una tabla pedidos con 3
millones. Hace tiempo alguien creó un índice sobre pedidos.cliente_id, la columna que une las
dos, precisamente para que los JOIN fuesen rápidos. Esta consulta suma lo que han comprado los
clientes de Soria:
SELECT count(*) AS pedidos, sum(p.importe) AS facturado
FROM clientes c
JOIN pedidos p ON p.cliente_id = c.id
WHERE c.provincia = 'Soria';
Postgres la resuelve como se aprende en clase: toma los 339 clientes de Soria y, para cada uno,
busca sus pedidos en el índice. Tarda 31 milisegundos. Si se cambia 'Soria' por 'Madrid', el
plan cambia entero: Postgres lee los 3 millones de pedidos de principio a fin y no toca el
índice. Parece un descuido, así que se le puede obligar a usarlo (se verá cómo más adelante).
Tarda 1,4 segundos, en lugar de 0,7.
| Buscando en el índice | Leyendo las dos tablas enteras | Lo que elige Postgres | |
|---|---|---|---|
| Soria (339 clientes) | 31 ms | 457 ms | el índice |
| Madrid (28 804 clientes) | 1,4 s | 0,72 s | las tablas enteras |
La consulta es la misma, y el índice también. Lo que cambia es cuántas filas salen del filtro, y con eso cambia qué forma de hacer el JOIN resulta barata.
La forma de pensar un JOIN que suele enseñarse es la que acaba de funcionar con Soria: para cada fila de una tabla, buscar en la otra las filas con el mismo valor. Sin índice eso cuesta comparaciones; con índice, . No es falso, pero describe uno de los tres algoritmos que tiene una base de datos para hacer un JOIN, el nested loop o bucle anidado, y es justo el que Postgres descartó para Madrid. Los otros dos, el hash join y el merge join, no buscan nada fila a fila. Cuál se ejecuta lo decide el optimizador, la parte de la base de datos que, antes de ejecutar una consulta, considera varios planes posibles, estima lo que costaría cada uno y se queda con el más barato. Estima, no mide, y de esa diferencia sale buena parte de lo que sigue.
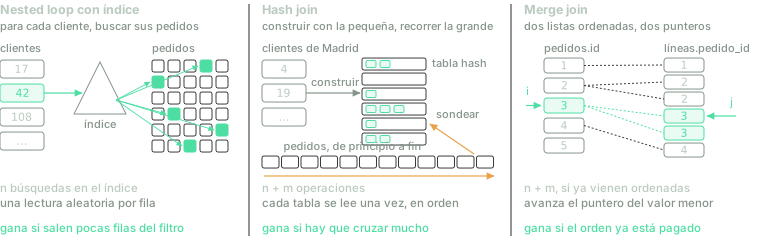
Los tres algoritmos de JOIN. El primero es el que suele enseñarse; los otros dos no buscan nada fila a fila. La es el número de filas de la entrada pequeña y la el de la grande.
Todos los números del artículo están medidos. La tienda es inventada: las provincias de los clientes se reparten como la población, y el 2 % de los clientes son empresas, que compran bastante más que un particular (esto importará). El script que la genera es público y usa semillas fijas, así que produce exactamente las mismas filas en cualquier Postgres 18, y cualquiera puede repetir las mediciones. Las consultas corren en Postgres 18.6, en Docker, en un portátil de cuatro núcleos con un SSD SATA, con el paralelismo desactivado para que cada plan se lea de una vez. Cada tiempo es la mediana de tres ejecuciones. Los tiempos dependen mucho de dónde estén los datos, y esa dependencia tiene su propia sección más abajo; mientras tanto, todos los de Postgres son con su memoria por defecto, en una máquina en la que los ficheros de la base de datos caben en la memoria del sistema operativo.
Lo que dice SQL y lo que no
El resultado de clientes JOIN pedidos ON p.cliente_id = c.id se define así: se forman todas
las parejas posibles de un cliente y un pedido, y se quedan las que cumplen la condición. Con
200 000 clientes y 3 millones de pedidos son 600 000 millones de parejas. De ahí sale el
: es la definición del resultado, no la forma de calcularlo. Ningún motor forma esas
parejas, igual que nadie ordena una lista comparando cada elemento con todos los demás aunque
ordenar se pueda definir así.
SQL es declarativo: la consulta dice qué filas quieres, no cómo encontrarlas, igual que
ORDER BY no dice qué algoritmo de ordenación usar. Entre la consulta y el resultado hay un
plan, y el plan lo decide el optimizador. Para un JOIN de dos tablas tiene que decidir tres
cosas: cómo leer cada tabla (entera o a través de un índice), con qué algoritmo juntarlas y qué
tabla va por fuera. Con más tablas, además, en qué orden juntarlas.
El plan se ve con EXPLAIN, que lo muestra sin ejecutar la consulta, y con EXPLAIN ANALYZE,
que la ejecuta y pone al lado de cada estimación lo que ocurrió de verdad. Este es el plan de
Soria, recortado a lo que importa:
Nested Loop  (rows=6600) (actual rows=5372.00 loops=1)
  ->  Seq Scan on clientes c  (rows=440) (actual rows=339.00 loops=1)
        Filter: (provincia = 'Soria'::text)
  ->  Bitmap Heap Scan on pedidos p  (rows=31) (actual rows=15.85 loops=339)
        Recheck Cond: (c.id = cliente_id)
        ->  Bitmap Index Scan on pedidos_cliente_id_idx  (rows=31) (actual rows=15.85 loops=339)
              Index Cond: (cliente_id = c.id)
Se lee como un árbol. Cada línea con -> es una operación, sus hijos van debajo y más
sangrados, y las filas suben desde las hojas hasta la raíz. La raíz es el JOIN, un Nested
Loop con dos hijos. El primero, el exterior, recorre la tabla clientes entera (un Seq Scan,
recorrido secuencial) y se queda con los de Soria. El segundo, el interior, trae los pedidos de
un cliente en dos pasos: el Bitmap Index Scan busca en el índice dónde están, y el Bitmap Heap
Scan va a leerlos a la tabla, después de ordenar esas posiciones por página para no leer ninguna
dos veces. Cada nodo lleva dos cuentas de filas: rows es lo que el optimizador estimó antes de
empezar, y actual rows lo que salió de verdad, en promedio por ejecución; loops dice cuántas
veces se ejecutó el nodo. Los dos nodos del interior tienen loops=339: se ejecutaron una vez por
cada cliente de Soria y devolvieron 15,85 pedidos de media. Es, literalmente, el algoritmo del que
se partía. El optimizador esperaba 440 clientes y 31 pedidos por cliente. Lo primero se acerca a
los 339 reales. Lo segundo volverá a aparecer.
Nested loop: el bucle que ya conocías
La versión más simple son dos bucles, uno dentro del otro:
for c in clientes:              # la tabla exterior
    for p in pedidos:           # la interior, entera, una vez por cada cliente
        if p.cliente_id == c.id:
            emitir(c, p)
Para los 339 clientes de Soria son mil millones de comparaciones, así que nadie la usa entre
tablas grandes. Pero tiene algo que los otros dos algoritmos no tienen: acepta cualquier
condición. El hash join sólo sirve para igualdades, y el merge join de Postgres también. Un JOIN
con ON p.fecha BETWEEN c.alta AND c.alta + 30, o con ON t.texto LIKE f.patron, no se puede
resolver con ninguno de los dos, y si además no hay un índice que sirva para esa condición, el
bucle anidado es lo único que queda.
La segunda versión ahorra lecturas, no comparaciones. En lugar de recorrer la tabla interior una vez por cada fila de la exterior, lee la exterior a bloques que caben en memoria y recorre la interior una vez por bloque: si caben mil clientes en cada bloque, la tabla de pedidos se lee mil veces menos. Es el block nested loop, y fue el último recurso de MySQL para los JOIN sin índice hasta 2019.
La tercera versión, el nested loop con índice, es la del principio: cambiar el bucle interior por una búsqueda en un índice.
for c in clientes:
    for posicion in indice_pedidos_cliente.buscar(c.id):   # bajar por el árbol
        p = leer_fila(pedidos, posicion)                     # e ir a por cada pedido
        emitir(c, p)
Un índice de Postgres es un árbol B: los valores de cliente_id, ordenados y repartidos en
páginas de 8 KB, con páginas de ramas por encima que dicen en qué página seguir. El de
pedidos.cliente_id tiene tres niveles para 3 millones de valores, así que encontrar los
pedidos de un cliente cuesta bajar tres páginas. De ahí el , y la cuenta es
correcta, pero deja fuera lo que más cuesta. El índice no guarda los pedidos; guarda dónde
están. Por cada coincidencia hay que ir a leer la fila a la página de la tabla en la que vive, y
los pedidos se guardaron según llegaban, en orden de fecha: los pedidos de un mismo cliente
están desperdigados entre las 22 059 páginas que ocupa la tabla. Para Soria son 5372 pedidos,
casi cada uno en una página distinta. Para Madrid, 431 921. El Bitmap Heap Scan del plan de
Soria ordena por página las posiciones de cada cliente, pero entre un cliente y el siguiente las
páginas vuelven a estar en cualquier parte.
Eso decide cuándo gana el nested loop con índice: cuando del lado exterior salen pocas filas,
porque su coste crece con ellas y no con el tamaño de la tabla interior. Soria es el caso de
libro. También gana con un LIMIT, porque puede parar en cuanto tiene las primeras filas, y
cuando la condición no es una igualdad.
Hash join: leer cada tabla una vez
El plan de Madrid es otro:
Hash Join  (rows=430095) (actual rows=431921.00 loops=1)
  Hash Cond: (p.cliente_id = c.id)
  ->  Seq Scan on pedidos p  (rows=3000000) (actual rows=3000000.00 loops=1)
  ->  Hash  (rows=28673) (actual rows=28804.00 loops=1)
        Buckets: 32768  Batches: 1  Memory Usage: 1269kB
        ->  Seq Scan on clientes c  (rows=28673) (actual rows=28804.00 loops=1)
              Filter: (provincia = 'Madrid'::text)
Ningún nodo tiene loops mayor que 1: cada tabla se lee una sola vez. El algoritmo tiene dos
fases. En la de construcción, lee la entrada pequeña, los 28 804 clientes de Madrid, y mete
cada id en una tabla hash en memoria (1,2 MB, según el plan). En la de sondeo,
recorre la entrada grande de principio a fin y, por cada pedido, calcula el hash de su
cliente_id y mira si está en la tabla. Mirar cuesta lo mismo haya treinta clientes en la tabla
o treinta mil.
tabla = {}
for c in clientes_de_madrid:              # construir, con la entrada pequeña
    tabla.setdefault(c.id, []).append(c)
for p in pedidos:                         # sondear, con la grande, de principio a fin
    for c in tabla.get(p.cliente_id, []):
        emitir(c, p)
El coste es , y aquí está lo interesante. Si sólo se cuentan operaciones, en Madrid
debería ganar el nested loop: 28 804 búsquedas de unos 22 pasos cada una ( de 3
millones) son unas 620 000 comparaciones, más 431 921 filas que ir a buscar a la tabla; poco
más de un millón de operaciones, frente a los más de 3 millones de sondeos del hash join. Pierde,
1,4 s frente a 0,72, porque lo que cuesta no son las operaciones sino las
páginas. El hash join lee las 22 059 páginas de pedidos una detrás de otra, y leer en orden es
lo más barato que hay: Postgres pide las páginas de muchas en muchas, la siguiente ya viene en
camino cuando termina con la anterior, y cada página se toca una sola vez. El nested loop pide
431 921 filas desperdigadas por toda la tabla, cada una en su página, muchas páginas más de una
vez, y cada petición espera a que termine la anterior. El optimizador cuenta, sobre todo,
páginas, y distingue las que se leen en orden de las que se leen salteadas.
El hash join tiene dos límites. Sólo sirve para igualdades: una tabla hash sabe responder «¿está
este valor?», no «¿qué valores caen entre estos dos?». Y la tabla tiene que caber en la memoria
que Postgres da a cada operación, work_mem, que por defecto son 4 MB. Si no cabe, reparte las
dos entradas en lotes según el hash de la clave, los escribe en disco y los junta lote a lote; el
plan lo avisa con Batches mayor que 1. Por eso importa qué entrada se usa para construir: la
pequeña, contada después de aplicar los filtros. Postgres construyó con los clientes de Madrid y
recorrió los pedidos, no al revés, y el orden en que se escriben las tablas en la consulta no
influye.
Merge join: dos listas ordenadas
Si las dos entradas vienen ordenadas por la clave, juntarlas es como mezclar dos listas ordenadas: un puntero en cada una, se avanza el que apunta al valor menor y, cuando los dos coinciden, se emite la pareja.
i = j = 0
while i < len(pedidos) and j < len(lineas):
    if pedidos[i].id < lineas[j].pedido_id:
        i += 1
    elif pedidos[i].id > lineas[j].pedido_id:
        j += 1
    else:
        emitir(pedidos[i], lineas[j])
        j += 1          # un pedido tiene varias líneas: sólo avanza j
Recorre cada entrada una vez, , sin tabla hash y casi sin memoria. Si las entradas no vienen ordenadas hay que ordenarlas antes, y eso cuesta y memoria, o disco. Así que el merge join gana cuando el orden ya está pagado: porque hay un índice (un árbol B guarda las claves ordenadas), porque la tabla está guardada en ese orden o porque la consulta tiene que ordenar de todos modos.
La tienda tiene una tercera tabla, lineas_pedido, con las 7 498 570 líneas de los pedidos y
una clave primaria (pedido_id, linea). Esta consulta recalcula el total de cada pedido a partir
de sus líneas, en orden de pedido, que es lo que se hace para comprobar que el importe guardado
cuadra:
SELECT p.id, p.importe, sum(l.cantidad * l.precio) AS total_lineas
FROM pedidos p
JOIN lineas_pedido l ON l.pedido_id = p.id
GROUP BY p.id
ORDER BY p.id;
GroupAggregate (rows=3000000) (actual rows=3000000.00 loops=1)
Group Key: p.id
-> Merge Join (rows=7498532) (actual rows=7498570.00 loops=1)
Merge Cond: (p.id = l.pedido_id)
-> Index Scan using pedidos_pkey on pedidos p (rows=3000000) (actual rows=3000000.00 loops=1)
-> Index Scan using lineas_pedido_pkey on lineas_pedido l (rows=7498532) (actual rows=7498570.00 loops=1)No hay ningún nodo que ordene. Las dos claves primarias entregan las filas en orden de pedido,
el merge join las junta sin perder ese orden, el GROUP BY agrupa filas que ya llegan seguidas
(GroupAggregate, sin tabla hash) y el ORDER BY sale gratis. Tarda 6,5 s. Obligado a usar
un hash join tarda 16,4 s: los 3 millones de pedidos no caben en los 4 MB de work_mem, así
que la tabla hash se parte en 32 lotes en disco, y después hay que agrupar 3 millones de pedidos
con otra tabla hash que tampoco cabe (384 MB a disco) y ordenar el resultado (82 MB más).
Y por eso el merge join no ganó nunca entre clientes y pedidos: los pedidos no están ordenados
por cliente. El índice de cliente_id podría entregarlos en ese orden, pero leyendo los 3
millones de pedidos a saltos, de página en página. Incluso con toda la tabla en la caché de
Postgres, eso son unos tres segundos, se filtre un cliente o doscientos mil.
Cómo elige
El optimizador no ejecuta los tres algoritmos para ver cuál gana: los estima. Para eso necesita saber dos cosas, cuántas filas va a mover cada paso y cuánto cuesta cada operación.
Las filas salen de las estadísticas que ANALYZE recoge de una muestra de cada tabla. Para cada
columna guarda los valores más frecuentes con su frecuencia, un histograma del resto y el número
de valores distintos. Nadie tiene que acordarse de lanzarlo: el autovacuum, un proceso de
mantenimiento que Postgres tiene siempre en marcha (su trabajo principal es limpiar las versiones
viejas de las filas que dejan UPDATE y DELETE), ejecuta ANALYZE por su cuenta cuando ha
cambiado más o menos un 10 % de la tabla. Entre una vez y la siguiente, el optimizador trabaja con
una foto de la tabla tal como era, y por eso, después de cargar muchos datos de golpe, conviene
lanzar ANALYZE a mano. Las 52 provincias están en la lista de frecuentes de clientes.provincia, y de ahí
salen las estimaciones de 28 673 clientes para Madrid y 440 para Soria, cerca de los 28 804 y 339
reales. El coste sale de un modelo de costes con unas pocas constantes: leer una página en orden cuesta
1 (seq_page_cost), leer una página salteada cuesta 4 (random_page_cost), procesar una fila
cuesta 0,01 (cpu_tuple_cost), y unas pocas más. Para cada plan candidato, el optimizador
multiplica filas y páginas por esas constantes, suma, y se queda con el total más bajo. Para las
dos consultas del principio:
| Coste estimado | Nested loop | Hash join |
|---|---|---|
| Soria | 48 475 | 64 974 |
| Madrid | 144 492 | 67 444 |
Las unidades son «lo que cuesta leer una página en orden». El coste del hash join apenas cambia de Soria a Madrid, porque lo domina leer los pedidos enteros. El del nested loop crece con cada cliente, porque cada uno trae unas cuantas páginas salteadas a precio 4.
¿Dónde está el punto a partir del cual conviene cambiar de algoritmo? Para verlo he repetido la
consulta variando cuántos clientes pasan el filtro, desde uno hasta los 200 000 (con una columna
aleatoria, para poder elegir el número exacto), y he medido los dos algoritmos forzados con
SET enable_hashjoin = off y SET enable_nestloop = off, que no prohíben un algoritmo pero lo
hacen tan caro que el optimizador lo evita. Lo he hecho en tres situaciones, porque «leer una
página salteada» no cuesta lo mismo en todas:
- En la caché de Postgres. Toda la base de datos cabe en la memoria que Postgres reserva
para sí (
shared_buffers), y ya está cargada. Leer una página es leer 8 KB de memoria. - En la caché del sistema. Postgres con su memoria por defecto, que reserva 128 MB. La tabla de pedidos, de 172 MB, no cabe, pero sus ficheros están en la memoria del sistema operativo, y cada página que falta en la caché de Postgres cuesta una llamada al sistema. Es la situación de los tiempos del principio, y la de muchos servidores.
- En el SSD. La primera ejecución, con las dos cachés vacías y en un contenedor limitado a 160 MB para que la tabla no quepa en ninguna. Cada página salteada es una petición al SSD.
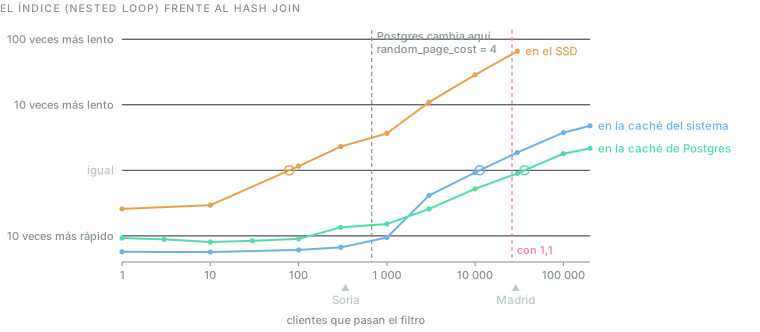
Cuántas veces más lento, o más rápido, es el nested loop con índice que el hash join, según
cuántos clientes pasan el filtro. Cada situación cruza el «igual» en un sitio distinto (el
círculo): unos 80 clientes en el SSD, 11 000 en la caché del sistema y 36 000 en la de
Postgres. La línea gris marca dónde cambia Postgres de algoritmo con su configuración por
defecto, la misma en los tres casos; la rosa, dónde lo haría con random_page_cost = 1,1. En el
SSD no he medido el nested loop por encima de 30 000 clientes: cada ejecución habría tardado
varios minutos.
En el SSD, el nested loop sólo gana hasta unos 80 clientes. Con los 339 de Soria ya tarda 1,4 s frente a 0,8 del hash join, y con los 28 804 de Madrid, 61 segundos frente a uno. En la caché del sistema, el cruce está en torno a los 11 000 clientes, y en la caché de Postgres, en torno a los 36 000: con toda la tabla en memoria, Madrid es casi un empate (554 ms con el índice, 592 sin él). El punto de cambio real se mueve más de dos órdenes de magnitud según dónde estén las páginas. El de Postgres no se mueve: con los valores por defecto, deja el índice a partir de 673 clientes en los tres casos.
Ese 673 no es un descuido, está puesto entre medias a propósito. La
documentación de Postgres explica
que leer una página salteada del disco cuesta normalmente mucho más que cuatro lecturas en orden, y
que el 4 es más bajo porque supone que la mayoría de las lecturas salteadas, como las de un índice,
encontrarán la página en caché. Es una apuesta sobre tu hardware y sobre qué parte de tus datos está
en memoria, y el optimizador no tiene forma de saber, al planificar, en cuál de las tres situaciones
se va a ejecutar la consulta. Por eso random_page_cost se puede cambiar, para toda la base de
datos o para un tablespace. Con 1,1, un valor que suele recomendarse cuando los datos caben en
memoria, Postgres deja el índice a partir de 26 161 clientes: cerca del cruce real en la caché
de Postgres, y donde en el SSD el índice ya es casi sesenta veces más lento. Para acertar en el
SSD de este portátil habría que subirlo a unos 27. Ninguna constante acierta en los tres casos; lo
razonable es ajustarla a donde suelen estar tus datos.
Con más de dos tablas aparece una decisión más, que suele pesar más que la del algoritmo: en qué
orden juntarlas. Contando sólo los planes en los que cada JOIN añade una tabla nueva, tablas
admiten órdenes: 120 con cinco tablas, más de tres millones con diez. El optimizador de
System R, el prototipo de IBM del que salió SQL, lo resolvió en 1979 con
programación dinámica:
calcula el mejor plan para cada pareja de tablas, después para cada trío a partir de los mejores
de dos, y así hasta tenerlas todas. Guarda además el mejor plan para cada orden interesante,
uno más caro que entrega las filas ordenadas porque un paso posterior lo aprovechará, como el
merge join de antes. Postgres hace lo mismo hasta once tablas; a partir de doce
(geqo_threshold) pasa a un algoritmo genético que no garantiza el mejor orden. Y hay un límite
más práctico: en una consulta con más de ocho tablas unidas con JOIN explícitos
(join_collapse_limit), Postgres deja de buscar entre todos los órdenes y respeta en parte el
que está escrito.
Cuando se equivoca
Los algoritmos no fallan; fallan las estimaciones. En 2015, un equipo de la Universidad Técnica de Múnich y del CWI de Ámsterdam midió los optimizadores de cinco bases de datos con consultas reales de muchos JOIN. Todos cometían errores de estimación de mil veces o más, y los errores crecían exponencialmente con cada JOIN. Las consultas de Postgres que no terminaban tenían casi siempre lo mismo: una estimación muy baja que le llevaba a elegir un bucle anidado (sin índice, en su caso) donde luego había muchas más filas. La tienda tiene un caso parecido. Esta consulta suma lo que han comprado, línea a línea, las empresas de Madrid:
SELECT count(*), sum(l.cantidad * l.precio)
FROM clientes c
JOIN pedidos p       ON p.cliente_id = c.id
JOIN lineas_pedido l ON l.pedido_id  = p.id
WHERE c.tipo = 'empresa' AND c.provincia = 'Madrid';
Nested Loop (rows=22646) (actual rows=233051.00 loops=1)
-> Nested Loop (rows=9060) (actual rows=93417.00 loops=1)
-> Seq Scan on clientes c (rows=604) (actual rows=575.00 loops=1)
Filter: ((tipo = 'empresa'::text) AND (provincia = 'Madrid'::text))
-> Bitmap Heap Scan on pedidos p (rows=31) (actual rows=162.46 loops=575)
Recheck Cond: (c.id = cliente_id)
-> Bitmap Index Scan on pedidos_cliente_id_idx (rows=31) (actual rows=162.46 loops=575)
-> Index Scan using lineas_pedido_pkey on lineas_pedido l (rows=4) (actual rows=2.49 loops=93417)
Index Cond: (pedido_id = p.id)Un plan como este se lee de las hojas hacia arriba, comparando en cada nodo rows con
actual rows (multiplicado por loops cuando es mayor que 1), hasta encontrar el primero en el
que no cuadran. Las empresas de Madrid: 604 estimadas, 575 reales, bien. Los pedidos de cada
una: 31 estimados, 162 reales. Ahí nace el error, y desde ahí sube: el optimizador esperaba 9060
pedidos y salen 93 417, así que la búsqueda en el índice de lineas_pedido, que planeó para unas
nueve mil veces, se ejecuta 93 417 veces, cada una en un sitio distinto de una tabla de 373 MB. Con
nueve mil pedidos el plan era razonable. Con 93 417, lo que cueste depende de dónde estén las
páginas. Frente a la misma consulta sin bucles anidados (con SET enable_nestloop = off, sólo para
comprobarlo):
| Plan elegido | Sin bucles anidados | |
|---|---|---|
| En la caché de Postgres | 0,63 s | 1,4 s |
| En la caché del sistema | 2,3 s | 1,8 s |
| En el SSD | 58 s | 2,7 s |
Con todo en memoria, una lectura salteada es tan barata que el plan equivocado es incluso el más rápido. En la caché del sistema pierde por poco, nada que llame la atención. En el SSD es veinte veces más lento. Esa es la trampa de estos errores: el plan que va bien en desarrollo, con datos de prueba que caben en memoria, es el que un día se vuelve lento en producción sin que nadie haya tocado la consulta.
El 31 tiene dos causas. Postgres estima las filas de un JOIN con las estadísticas de cada columna
por separado: pedidos tiene 3 millones de filas y, según su muestra, 95 851 valores distintos de
cliente_id (en realidad hay 200 000), así que calcula 3 000 000 / 95 851 ≈ 31 pedidos por
cliente. La primera causa es ese recuento de distintos, que sale mal de una muestra de 30 000
filas. La segunda, la que importa, es que la
media se aplica a cualquier cliente, sea cual sea el filtro: un particular tiene 12 pedidos y una
empresa 162. Postgres no tiene forma de saber que la columna tipo de clientes dice algo sobre
cuántas filas tiene cada cliente en pedidos, porque son dos columnas de dos tablas distintas. El
estudio de Múnich llama a esto una correlación que cruza el JOIN, y las encontró por todas partes
en los datos reales que usó. Arreglar el recuento no ayudaría: con los 200 000 clientes distintos
correctos, la estimación bajaría a 15 pedidos por cliente, todavía más lejos de 162.
Qué se puede hacer:
- Mirar antes de tocar.
EXPLAIN ANALYZEy buscar, desde las hojas, el primer nodo en el querowsyactual rowsse separan un orden de magnitud. El algoritmo equivocado casi nunca es la causa; es la consecuencia de una estimación que se equivocó antes. - Si la correlación es entre columnas de una misma tabla, como provincia y código postal, la
corrige
CREATE STATISTICS: por defecto, el optimizador supone que las condiciones son independientes y multiplica sus probabilidades, y las estadísticas extendidas le dan las de las columnas juntas. - Si es entre tablas, no hay estadística que la arregle. Queda llevar la columna a la tabla
donde está el sesgo (si
pedidosguardase el tipo de cliente, el filtro se estimaría con las estadísticas depedidos), partir la consulta y guardar el resultado intermedio en una tabla temporal con su propioANALYZE, u obligar al algoritmo sólo en esa consulta, conSET LOCAL enable_nestloop = offdentro de una transacción. Ninguna es elegante.
MySQL y Oracle
Con los mismos datos cargados en MySQL 9.4, con 1 GB de caché para que quepan enteros, las tres
consultas de clientes y pedidos (Soria, Madrid y todos los clientes) se resuelven igual: bucle
anidado con búsqueda en el índice. MySQL sólo conoció el nested loop, con índice o por bloques,
hasta la 8.0.18, de 2019, cuando llegó el hash join;
en la 8.0.20 sustituyó del todo al bucle por bloques. Pero su optimizador lo usa cuando no hay un
índice que sirva para la condición del JOIN, y aquí lo hay. Para Soria y Madrid acierta, con los
datos en memoria: 117 ms y 1,42 s con el índice, frente a 1,06 s y 1,63 s con un hash join. Con
los 200 000 clientes se equivoca: 9,7 s con el índice, frente a 2,3 s con un hash join que hay que
forzar pidiéndole que ignore los dos índices (IGNORE INDEX).
Dos detalles más. Sin histogramas, que MySQL no recoge solo, supuso que el 10 % de los clientes
eran de Soria, y el mismo 10 % para Madrid; con
ANALYZE TABLE clientes UPDATE HISTOGRAM ON provincia pasa a estimar 286 y 24 830, y el plan
no cambia, porque la decisión no dependía de ese número. Y MySQL no tiene merge join: la consulta
de los totales por pedido la resuelve con un bucle sobre la clave primaria. MySQL tiene un
optimizador nuevo, el hypergraph, que sí compara los algoritmos por su coste, pero la 9.4
rechaza activarlo fuera de las compilaciones de depuración. En MySQL, por tanto, el modelo del
principio es literalmente lo que se ejecuta: si hay índice, se busca en él. Un informe que cruce
tablas enteras puede ir más rápido sin índice, y hay que decírselo.
Oracle, que no he medido, tiene los tres algoritmos, con hints para pedir cada uno (USE_NL,
USE_HASH, USE_MERGE), y su merge join acepta desigualdades. Lo interesante es lo que añadió en
la versión 12c, en 2013: planes adaptativos.
Cuando duda entre un bucle anidado y un hash join, prepara los dos. Durante la primera ejecución,
un colector de estadísticas cuenta las filas que llegan del lado exterior; si pasan del número en
el que los dos planes costarían lo mismo, cambia al hash join, y si no, sigue con el bucle. El plan
que resulta se queda fijo para las ejecuciones siguientes. Es la respuesta directa al problema de
la sección anterior: decidir con las filas que llegan de verdad, no con las estimadas. SQL Server
tiene un operador equivalente desde 2017; Postgres, en la versión 18, no.
En una base de datos por columnas
Postgres y MySQL guardan filas: cada página contiene filas completas, con todas sus columnas. Una
base de datos por columnas, como DuckDB, ClickHouse, Snowflake, BigQuery o Redshift, guarda cada
columna por separado, comprimida y en bloques. En DuckDB, cada tabla se divide en grupos de
122 880 filas, y para cada columna de cada grupo se guardan su mínimo y su máximo. Una consulta
que usa dos columnas de pedidos lee esas dos, y nada más.
He cargado los mismos datos en DuckDB 1.5.6, que se ejecuta dentro del propio programa, con todo
en memoria y un solo hilo para compararlo con Postgres, y he creado el mismo índice sobre
pedidos.cliente_id. Las tres consultas de clientes y pedidos salen con hash join, ninguna usa el
índice, y tardan 30 ms (Soria), 41 ms (Madrid) y 42 ms (todos los clientes). La
documentación de DuckDB lo dice sin rodeos: un índice no cambia lo que tarda un JOIN;
existe para las restricciones de clave y para búsquedas muy selectivas. La ventaja del nested loop
con índice era no leer la tabla entera, y leer dos columnas de números de 3 millones de filas, en
memoria, cuesta unos milisegundos.
No lo leas como «DuckDB es cincuenta veces mejor que Postgres»: son herramientas para trabajos distintos. Postgres guarda filas para poder leer, cambiar y bloquear un pedido concreto, que es lo que una tienda hace cada segundo; DuckDB guarda columnas para recorrer millones de filas de pocas columnas, que es lo que hace un informe. Y parte de la diferencia es del formato: DuckDB suma los importes como enteros, y Postgres como números decimales de precisión arbitraria.
Lo que sí cambia en una base de datos por columnas es dónde se va el tiempo del JOIN, y eso trae dos ideas que conviene conocer.
La primera es la ejecución vectorizada. Cada operador procesa vectores de 2048 valores en lugar de una fila cada vez, así que el hash join sondea 2048 claves seguidas en un bucle corto que el procesador ejecuta muy deprisa. La idea viene de MonetDB/X100, en 2005. Con los datos en memoria, el cuello de botella de un JOIN deja de ser el disco y pasa a ser la caché del procesador: una tabla hash que cabe en ella se sondea mucho más deprisa que una que obliga a ir a la memoria principal en cada consulta.
La segunda es el filtro dinámico: el JOIN le pasa un filtro al escaneo de la tabla grande. Cuando DuckDB termina de construir la tabla hash, conoce el mínimo y el máximo de sus claves y, a veces, construye además un filtro Bloom, una estructura compacta que responde, para cada valor, «seguro que no está» o «puede que esté». Con eso filtra la tabla que va a recorrer antes de leerla. Con el mínimo y el máximo de cada grupo, puede saltarse grupos enteros sin abrirlos. Esta consulta suma las líneas de los pedidos de septiembre:
SELECT count(*), sum(l.cantidad * l.precio)
FROM pedidos p
JOIN lineas_pedido l ON l.pedido_id = p.id
WHERE p.fecha >= DATE '2026-09-01';
Los 82 116 pedidos de septiembre tienen números entre 2 917 885 y 3 000 000, y eso es lo que el
plan le pasa al escaneo de lineas_pedido:
Dynamic Filters:
  optional: pedido_id>=2917885 AND optional: pedido_id<=3000000
AND optional: pedido_id IN BF(BF es el filtro Bloom). Las líneas están guardadas en orden de pedido, así que de los 65 grupos
de la tabla sólo 3 se cruzan con ese rango: DuckDB lee 249 458 líneas de 7 498 570, y tarda
50 ms. Con esa optimización desactivada lee las 7 498 570 y tarda 250 ms. En la
consulta de Soria pasa lo mismo, y no sirve de nada: los clientes de Soria tienen números entre 116
y 197 499, y los pedidos, guardados en orden de fecha, tienen clientes de todo el rango en cada
grupo.
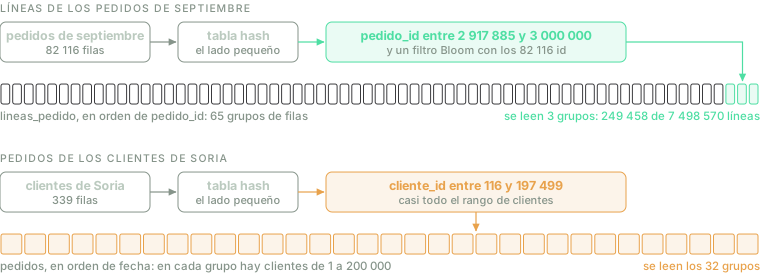
El mismo mecanismo, con y sin efecto. El filtro sólo ahorra lecturas si la tabla grande está guardada en un orden que se parezca al de la clave del JOIN: es el equivalente, en una base de datos por columnas, de elegir bien el índice.
DuckDB tampoco tiene merge join para igualdades: la consulta de los totales por pedido la resuelve
con un hash join, una agrupación por hash y una ordenación al final. Guarda los algoritmos basados
en ordenar para los JOIN con desigualdades, como ON a.fecha BETWEEN b.inicio AND b.fin, que una
tabla hash no puede resolver. Y en las bases de datos por columnas que reparten los datos entre
varias máquinas aparece una decisión más, que aquí no cabe: enviar la tabla pequeña entera a todas
las máquinas o redistribuir las dos por la clave del JOIN.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: el JOIN que escribes dice qué filas quieres, no cómo encontrarlas. «Para cada fila, busca en la otra tabla» es el nested loop, uno de tres algoritmos, y gana sólo cuando de un lado salen pocas filas. Cuando hay que cruzar mucho, leer cada tabla una vez (hash join) o recorrer dos listas que ya vienen ordenadas (merge join) cuesta menos, aunque cuente más operaciones, porque lo caro es leer páginas y leerlas salteadas.
Y si te llevas tres cosas más, que sean prácticas.
Un índice sobre la columna del JOIN ayuda al nested loop, y sólo cuando salen pocas filas del otro lado. Si el optimizador de Postgres lo ignora en un informe que cruza tablas enteras, probablemente tiene razón. En MySQL pasa lo contrario: lo usará aunque no convenga.
Antes de cambiar nada, EXPLAIN ANALYZE. Busca desde las hojas el primer nodo en el que las
filas estimadas y las reales se separan un orden de magnitud: ahí está el problema, y el algoritmo
elegido después es sólo su consecuencia. Y prueba con datos del tamaño de producción, porque en
memoria un plan equivocado puede parecer bueno.
random_page_cost es una afirmación sobre tu hardware. Con el valor por defecto, Postgres
deja el índice a partir de 673 clientes, en la caché de Postgres, en la del sistema o en el
SSD, cuando el punto real va de unos 80 a unos 36 000 según dónde estén las páginas. Si tu base de
datos cabe en memoria, bajarlo acerca el optimizador a la realidad; si es mucho más grande que la
memoria, déjalo como está.
En una base de datos por columnas lo que se optimiza no son índices, sino cuántos datos llegan al JOIN: filtrar pronto y guardar las tablas ordenadas por la columna por la que se filtran o se unen, para que los mínimos y máximos de cada grupo sirvan de algo.
Soria y Madrid escriben la misma consulta. Lo que cambia es cuántas filas salen del filtro, y con eso, qué algoritmo es barato. El optimizador lo sabe, o lo estima; tu trabajo es comprobar que lo estima bien.