 Por Gustavo Torres
Tienes un millón de fragmentos de texto, y cada uno está convertido en un embedding: un vector de 768 números con el que un modelo representa lo que dice el fragmento, entrenado para que dos textos que significan algo parecido reciban vectores cercanos. Llega una pregunta, se convierte en otro vector igual, y hay que devolver los diez fragmentos cuyos vectores están más cerca del suyo. Es lo que hace un buscador semántico, la mitad de búsqueda de un RAG (retrieval-augmented generation: buscar fragmentos y dárselos a un modelo de lenguaje para que responda con ellos), un recomendador de canciones o un buscador de fotos parecidas.
La forma segura de hacerlo es comparar la pregunta con el millón entero. Son 768 millones de multiplicaciones por pregunta sobre 3 GB de vectores, y en un solo núcleo de un procesador eso cuesta unas décimas de segundo. Un núcleo (core) es cada una de las unidades de un procesador que ejecutan instrucciones por su cuenta; un portátil tiene unos pocos y un servidor, decenas. Para una consulta de vez en cuando, vale. Para cien por segundo, o para mil millones de vectores, no.
En una base de datos relacional, ese problema lo resuelve un índice, casi siempre un árbol B, que encuentra una fila entre millones leyendo tres o cuatro bloques del disco. Pero el árbol B necesita que las claves tengan un orden, y los vectores no lo tienen: no hay forma de poner un millón de puntos de 768 dimensiones en fila de manera que los cercanos queden juntos. Hace falta otro tipo de índice, y el que usan las bases de datos vectoriales tiene una diferencia de fondo con los que conoces: es aproximado. No promete encontrar los diez más cercanos. Promete encontrar casi siempre casi todos, y deja elegir cuánto «casi» se acepta a cambio de cuánta velocidad.
Este artículo recorre cómo se construyen esos índices: las cuatro familias de algoritmos que deciden dónde mirar, las técnicas de compresión que deciden cuánto guardar de cada vector, cómo se combinan en los índices que se usan de verdad, qué tuvieron que añadirles las bases de datos y cómo quedan comparados. Los números de rendimiento son de dos bancos de pruebas públicos, citados y no medidos aquí.
Qué es una base de datos vectorial, y qué no
Una base de datos vectorial guarda, para cada objeto, un vector, un identificador y casi siempre unos cuantos campos más: el texto original, la fecha, el idioma, el cliente al que pertenece. Su operación central es una sola. Dados un vector y un número , devolver los objetos cuyos vectores están más cerca. Los objetos no tienen por qué ser documentos: pueden ser fragmentos de texto, imágenes, canciones, productos o usuarios, cualquier cosa a la que un modelo sepa asignar un vector.
Se suele decir que una base de datos vectorial es NoSQL, y es verdad en el sentido más débil de la palabra. NoSQL nombra todo lo que no es relacional, y mete en el mismo saco a los almacenes de clave y valor, de documentos, de columnas y de grafos, que se distinguen entre sí por cómo modelan los datos. Lo que define a una base de datos vectorial no es cómo modela los datos, sino cómo los busca. Milvus, Qdrant, Weaviate, Pinecone o Chroma son bases de datos dedicadas, construidas alrededor de esa búsqueda. Pero la misma búsqueda existe hoy como una función más dentro de bases de datos de todas las familias: en PostgreSQL con la extensión pgvector, en Oracle, en SQL Server 2025, en MongoDB Atlas, en Elasticsearch, en Redis. «Base de datos vectorial» ha acabado nombrando una capacidad más que una familia.
La segunda idea que conviene ajustar pronto es el orden en que pasaron las cosas. Los algoritmos que usan estas bases de datos no se inventaron para ellas. El árbol k-d es de 1975; el hashing sensible a la localidad, de 1998; la cuantización por producto, de 2011; HNSW, el índice de grafo que hoy usan casi todas, de 2016. Nacieron en la geometría computacional, en la búsqueda de imágenes y en los sistemas de recomendación, y se publicaron como bibliotecas de programación: Annoy, de Spotify, en 2013; Faiss, de Facebook, en 2017. Las bases de datos dedicadas llegaron después, a partir de 2019, y Milvus se construyó directamente sobre Faiss. Lo que sí trajeron fueron variantes: formas de filtrar mientras se busca, de insertar y borrar sin reconstruir el índice, y de que el índice no tenga que caber en memoria.
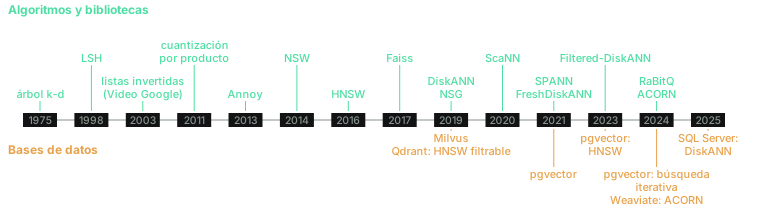
No a escala. En verde, los algoritmos y las bibliotecas; en naranja, las bases de datos y lo que añadieron.
Buscar el más cercano, sin aproximar
Antes de aproximar, conviene ver por qué no basta con lo exacto. La búsqueda exacta de los vecinos más cercanos (k-nearest neighbors, k-NN) por fuerza bruta compara la pregunta con todos los vectores. Con la distancia euclídea o con el coseno, cada comparación son multiplicaciones y sumas, y el coste crece con el número de vectores por su dimensión. Lo lento no son las cuentas, que un procesador hace de muchas en muchas con instrucciones vectoriales, sino la memoria: un millón de vectores de 768 números de 4 bytes ocupa 3 GB, y cada pregunta tiene que leerlos enteros. En ANN-Benchmarks, el banco de pruebas público de referencia durante años, la fuerza bruta sobre un millón de vectores de 960 dimensiones responde 2,6 preguntas por segundo: casi 0,4 segundos por pregunta. Es lo que consigue un solo núcleo de un Intel Xeon de tercera generación en un servidor de Amazon Web Services (una instancia r6i.16xlarge).
La fuerza bruta tiene virtudes que el resto del artículo va a echar de menos. Es exacta, no hay que construir nada, admite cualquier filtro y no le importa que los datos cambien. La guía de Faiss, la biblioteca de búsqueda vectorial de Meta, lo dice sin rodeos: el único índice que garantiza resultados exactos es el plano, el que compara con todo. Con unas decenas de miles de vectores, o con una GPU, a menudo basta.
Para hacerlo mejor que la fuerza bruta, la idea clásica es partir el espacio. El árbol k-d (k-dimensional tree), que Jon Bentley publicó en 1975, divide el conjunto de puntos en dos por la mediana de una coordenada. Se toman todos los valores de esa coordenada, la primera por ejemplo, se calcula la mediana, y los puntos cuya primera coordenada es menor que la mediana van a un grupo y el resto a otro. Luego cada mitad se divide en dos por otra coordenada, y así hasta tener hojas pequeñas (con pocos puntos). Para buscar, baja hasta la hoja donde caería la pregunta, toma el mejor candidato de esa hoja (el más cercano) y luego vuelve hacia arriba mirando las ramas que todavía podrían contener algo más cerca. En dos o tres dimensiones descarta casi todo el árbol sin mirarlo.
En 768 dimensiones no descarta casi nada. Un árbol sobre un millón de puntos tiene unos veinte niveles, así que el camino de la raíz a una hoja decide mirando veinte de las 768 coordenadas. El vecino más cercano difiere un poco de la pregunta en todas ellas, y basta con que quede al otro lado de uno de esos veinte cortes para que haya que volver atrás a buscarlo. Con tantas coordenadas y tan poca diferencia en cada una, queda al otro lado de muchos, y la vuelta atrás acaba visitando casi todas las hojas.
El problema se conocía mucho antes de los embeddings y de las bases de datos vectoriales. A finales de los noventa ya se buscaban imágenes parecidas describiendo cada una con un vector, por ejemplo un histograma de color (cuántos píxeles de cada tono tiene la imagen) de cientos de dimensiones, y esos vectores se indexaban con árboles que parten el espacio en regiones, como el árbol k-d. En 1998, Roger Weber, Hans-Jörg Schek y Stephen Blott analizaron esa familia de árboles y demostraron que, por encima de unas diez dimensiones, en promedio, leer todos los datos de forma secuencial gana.
Así que queda renunciar a lo exacto. Un índice de vecinos más cercanos aproximados (approximate nearest neighbors, ANN) devuelve vectores que casi siempre coinciden casi del todo con los verdaderos. La medida de ese «casi» es el recall (exhaustividad, aunque en este campo casi nadie lo traduce), la fracción de los vecinos verdaderos que aparecen en la respuesta:
Un recall@10 de quiere decir que, de cada diez vecinos verdaderos, la respuesta trae nueve y medio de media. Y no es una propiedad fija del índice. Casi todos tienen un parámetro que se fija al preguntar y que cambia velocidad por recall sin reconstruir nada, así que los resultados de cualquier comparación seria son curvas: preguntas por segundo frente a recall.
Dos decisiones: dónde mirar y cuánto guardar
Todos los índices aproximados hacen el mismo trato, y se entiende mejor separándolo en dos decisiones independientes, porque los índices reales combinan una respuesta a cada una.
La primera es dónde mirar: cómo elegir, para cada pregunta, una fracción pequeña de los vectores con la que merezca la pena comparar, sin comparar con el resto. Hay cuatro familias de respuestas: partir el espacio con árboles, agrupar con funciones hash, agrupar por cercanía en listas, o enlazar los vectores en un grafo y recorrerlo.
La segunda es cuánto guardar de cada vector: si las comparaciones se hacen con los 768 números en coma flotante o con una versión comprimida que ocupa una fracción y se compara más deprisa, a cambio de un error.
La primera decisión ahorra comparaciones. La segunda abarata cada una y, sobre todo, hace que el índice quepa en memoria. Las dos se pagan con recall.
Dónde mirar
Para comparar las familias con datos uso los resultados de VIBE (Vector Index Benchmark for Embeddings), un banco de pruebas publicado en 2025 por investigadores de las universidades de Helsinki, Aalto y Padua y de la IT University de Copenhague. Uno de sus conjuntos de datos es exactamente el caso de este artículo: 1 344 643 resúmenes de artículos de arXiv convertidos en vectores de 768 dimensiones, 4,1 GB en coma flotante. Cada índice se prueba en un solo núcleo de un servidor con dos procesadores Intel Xeon Gold 6230, con muchas configuraciones, midiendo cuántas preguntas por segundo responde y con qué recall@100. Aquí cito, para cada familia, su mejor configuración con un recall de al menos ; la comparación completa viene más abajo.
Árboles al azar
El árbol k-d falla porque corta por coordenadas. Annoy (Approximate Nearest Neighbors Oh Yeah), la biblioteca que Erik Bernhardsson escribió en Spotify para recomendar música, corta por planos al azar: en cada nodo elige dos puntos al azar y parte el espacio por el plano que queda a la misma distancia de los dos. Y en lugar de un árbol construye un bosque de cientos, cada uno con cortes distintos. Un vecino que queda al otro lado de un corte en un árbol queda del mismo lado en otros, así que buscar en todos a la vez, con un presupuesto común de nodos por visitar, recupera lo que cada árbol por separado se dejaría.
Funciona, pero cada árbol más es otra estructura entera en memoria. En VIBE, Annoy necesita 12 GB para indexar 4,1 GB de vectores, y responde 117 preguntas por segundo. Además, un índice de Annoy no admite añadir nada una vez construido.
Hashing: que lo parecido caiga junto
Una función hash normal reparte las claves al azar, y dos claves casi iguales acaban en casilleros (buckets, en inglés) distintos. El hashing sensible a la localidad (locality-sensitive hashing, LSH), que Piotr Indyk y Rajeev Motwani propusieron en 1998, busca lo contrario: funciones con las que dos vectores cercanos caen en el mismo casillero con mucha más probabilidad que dos lejanos. Para buscar, se calcula el casillero de la pregunta y se compara sólo con lo que hay dentro.
Para el coseno hay una función así muy sencilla, SimHash, de Moses Charikar (2002). Se elige al azar un plano que pase por el origen, y el hash de un vector es un bit: de qué lado del plano cae. Dos vectores reciben el mismo bit salvo que el plano pase entre ellos, y eso ocurre con una probabilidad proporcional al ángulo que forman:
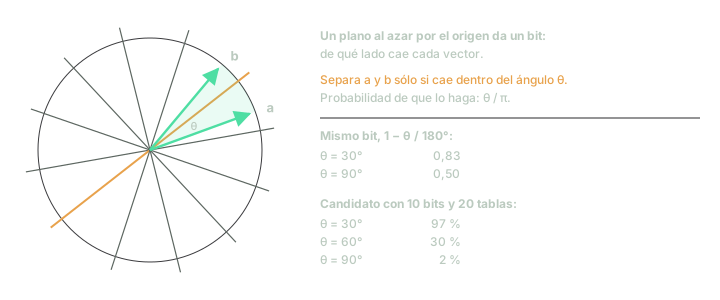
Un plano al azar separa a y b sólo si cae dentro del ángulo que forman: probabilidad .
Un bit separa poco. Dos vectores a 30° comparten bit con probabilidad , y dos perpendiculares, con . Por eso se concatenan planos en una clave de bits, que coincide entera con probabilidad , y se construyen tablas independientes, de modo que basta con coincidir en una. La probabilidad de que un vector a ángulo de la pregunta salga como candidato es
Con y , un vector a 30° de la pregunta sale como candidato el 97 % de las veces; uno a 60°, el 30 %; uno perpendicular, el 2 %. Separa muy bien lo cerca de lo lejos, con una garantía que se puede demostrar, y ése es su atractivo.
El problema es que buscar no consiste en separar lo cerca de lo lejos, sino en ordenar lo cerca. Los diez vecinos de una pregunta y los cien siguientes están a ángulos parecidos, y para distinguirlos hacen falta claves más largas, que dejan casi todos los casilleros vacíos, y por tanto muchas más tablas, cada una con una entrada por vector. Ahí se va la memoria. En VIBE, PUFFINN, una implementación moderna de LSH, ocupa 9,5 GB y responde 12 preguntas por segundo: la última de todas las familias.
Listas invertidas: agrupar y visitar los grupos cercanos
La tercera idea viene de los buscadores de texto, que guardan, para cada palabra, la lista de los documentos que la contienen: un índice invertido. En 2003, Josef Sivic y Andrew Zisserman la llevaron a los vectores en Video Google, un sistema para encontrar objetos en vídeos. Agruparon los vectores con k-means, trataron cada grupo como si fuera una palabra y buscaron con un índice invertido. De ahí el nombre que el índice conserva: IVF, de inverted file.
k-means es el algoritmo de agrupamiento más común: coloca centros y los mueve hasta que cada uno es la media de los vectores que tiene más cerca. Cada centro define una celda, la región del espacio más cercana a él que a cualquier otro, y el índice guarda una lista por celda con sus vectores. Para buscar, se compara la pregunta con los centros, se eligen las celdas más cercanas y se compara sólo con los vectores de sus listas.
Con un millón de vectores y mil celdas, que es lo que recomienda pgvector para empezar (las filas entre mil), cada lista tiene unos mil vectores. Visitando 32 celdas, la raíz cuadrada de mil, que es su otra recomendación, una pregunta hace comparaciones en lugar de un millón, unas treinta veces menos.
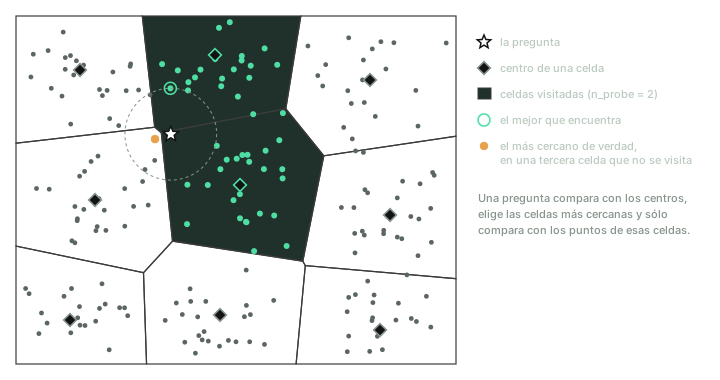
Con se visitan las dos celdas de centro más cercano, y el vecino más cercano de verdad está en una tercera.
Lo que se pierde está en los bordes. El vecino más cercano puede quedar justo al otro lado de la frontera de una celda que no se visitó, y entonces no aparece. Subir lo arregla y cuesta tiempo en la misma proporción.
IVF tiene dos virtudes que la familia siguiente no tiene: se construye deprisa, porque k-means sobre una muestra es barato, e insertar es trivial, porque basta con añadir el vector a la lista de su centro más cercano. Y un defecto: los centros se calcularon con los datos del principio. Si los datos nuevos se parecen poco a los viejos, las listas se desequilibran y hay que recalcular, y por eso pgvector pide crear su índice IVF cuando la tabla ya tiene datos. En VIBE, el IVF de Faiss responde 246 preguntas por segundo y se construye en menos de diez minutos.
Grafos: saltar de vecino en vecino
La cuarta familia es la que ganó. La idea es enlazar cada vector con unos cuantos de sus vecinos y buscar caminando: se empieza en un vector cualquiera, se mira cuál de sus vecinos está más cerca de la pregunta, se salta a él, y se repite hasta que ningún vecino del vector actual está más cerca que él. Es una búsqueda voraz (greedy): cada paso toma la mejor opción local.
Para que funcione, el grafo necesita dos tipos de enlace. Los cortos, entre vecinos de verdad, dan la precisión al final. Los largos permiten cruzar el espacio en pocos saltos al principio. Un grafo con esa mezcla es un mundo pequeño navegable (navigable small world, NSW): pequeño, porque cualquier par de nodos está a pocos saltos, como en los seis grados de separación entre dos personas cualesquiera; navegable, porque esos pocos saltos se encuentran con información local, sin conocer el grafo entero. Yury Malkov y sus coautores publicaron en 2014 un índice así en el que los enlaces largos salían solos: los vectores se insertan uno a uno, enlazados con sus vecinos más cercanos del momento, y los primeros, insertados cuando había pocos, acaban con vecinos lejanos.
En 2016, Malkov y Dmitry Yashunin separaron los dos tipos de enlace en capas, y así nació HNSW (hierarchical navigable small world). Al insertarse, cada vector recibe un nivel al azar, con una probabilidad que cae de forma exponencial: todos están en la capa 0, una fracción también en la 1, una fracción de esa fracción en la 2, y así. Cada capa es un grafo de vecinos entre los vectores que llegan a ella, y como las capas altas tienen pocos vectores, sus enlaces son largos. La búsqueda empieza en la capa de arriba, avanza de forma voraz hasta que no puede acercarse más, baja a la capa siguiente desde ese mismo vector y repite. Es la idea de la lista con saltos (skip list), una lista ordenada con atajos para saltarse tramos, llevada a un espacio que no tiene orden.
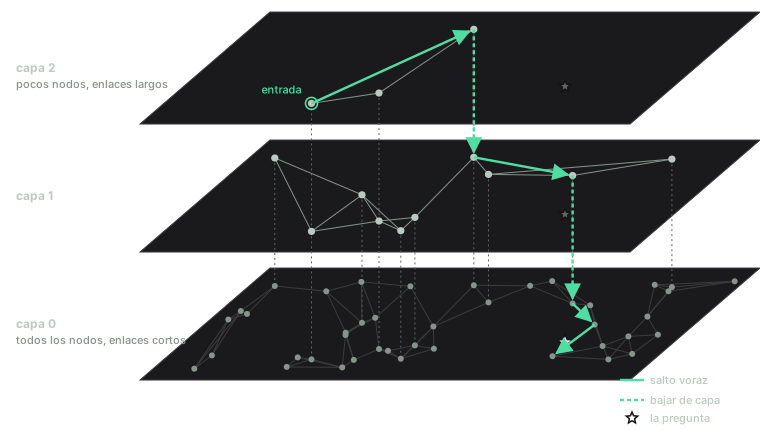
La búsqueda cruza el espacio con pocos saltos largos arriba y termina con pasos cortos abajo.
En la capa 0, en lugar de un solo candidato, la búsqueda mantiene una lista con los mejores encontrados y explora los vecinos de todos ellos, lo que la protege de quedarse atascada en un callejón. Ese es el parámetro que se fija al preguntar y cambia velocidad por recall. Los otros dos se fijan al construir: , cuántos vecinos guarda cada vector (el doble en la capa 0), y , cuánto busca cada inserción para elegirlos. pgvector usa por defecto , y . El coste de una búsqueda crece con el logaritmo del número de vectores, y en VIBE el HNSW de hnswlib responde 2 001 preguntas por segundo, ocho veces más que las listas invertidas.
Lo que paga a cambio son tres cosas. La memoria: además de los vectores, unos enlaces de 4 bytes por vector, y todo tiene que estar en memoria, porque la búsqueda salta de un vector a otro sin ningún orden y en disco cada salto sería una lectura aleatoria. La construcción, que es lenta porque cada inserción es una búsqueda: en VIBE, 52 minutos. Y el borrado, porque quitar un nodo rompe los caminos que pasaban por él; el HNSW de Faiss, directamente, no admite borrar.
Después de HNSW llegaron grafos de una sola capa construidos con más cuidado. NSG (navigating spreading-out graph, 2019) acabó en el buscador de Taobao, la tienda online de Alibaba. Vamana (2019), el grafo de DiskANN, conserva a propósito algunos enlaces largos al elegir los vecinos de cada vector, para llegar a cualquier sitio en menos saltos.
Cuánto guardar: comprimir para comparar más deprisa
Un vector de 768 números en coma flotante ocupa 3 072 bytes. Un millón, 3 GB; cien millones, 307 GB, más de lo que cabe en la memoria de casi cualquier servidor. Comprimirlos ataca dos problemas a la vez: el índice cabe en memoria, y cada comparación lee menos bytes, que era lo que de verdad la hacía lenta.
Cuantización escalar. Cada número se guarda en un byte en lugar de cuatro: se mira entre qué valores se mueve cada coordenada y se reparte ese intervalo en 256 escalones. El vector baja a 768 bytes, cuatro veces menos, y el error es pequeño.
Cuantización binaria. Cada número se reduce a su signo, un bit. El vector baja a 96 bytes, treinta y dos veces menos, y comparar dos vectores se convierte en contar en cuántos bits difieren (la distancia de Hamming), algo que un procesador hace con dos instrucciones por cada 64 bits. Es el plano al azar del LSH, sólo que los planos son los de los ejes. En las pruebas de Hugging Face con modelos de embeddings de texto, buscar con vectores binarios conserva alrededor del 92,5 % de la calidad de la búsqueda original, y el 96 % si los candidatos se reordenan después con la pregunta sin comprimir.
Cuantización por producto (product quantization, PQ), de Hervé Jégou, Matthijs Douze y Cordelia Schmid (2011), la más importante de las tres. El vector se parte en trozos seguidos, por ejemplo 96 trozos de 8 números. Para cada posición se entrena un k-means con 256 centros sobre los trozos de esa posición de todos los vectores; esos centros son el diccionario (codebook) de la posición. Cada trozo se sustituye por el número de su centro más cercano, que cabe en un byte. El vector entero queda en 96 bytes, y los diccionarios, comunes a todos los vectores, ocupan números, unos 786 KB.
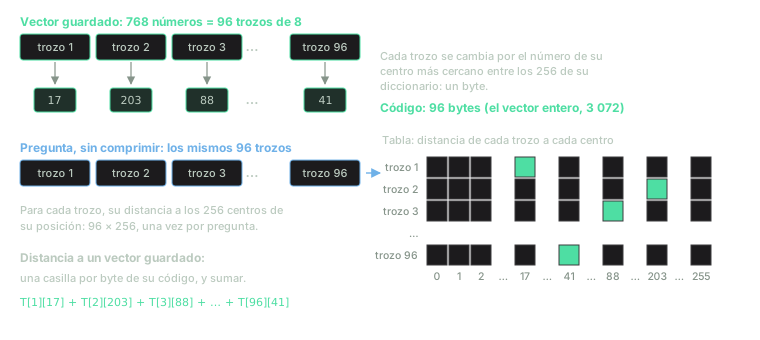
Cada trozo del vector se guarda como un byte. Para comparar, la pregunta llena una tabla una vez y cada vector cuesta 96 lecturas de esa tabla.
Lo ingenioso es cómo se compara. La pregunta no se comprime. Se parte en los mismos 96 trozos y, para cada posición, se calcula una sola vez su distancia a los 256 centros de esa posición: una tabla de distancias. Después, la distancia aproximada a cualquier vector guardado es la suma de 96 casillas de esa tabla, una por cada byte de su código:
donde es el trozo de la pregunta y es el centro que sustituye al trozo del vector guardado. Los autores la llaman distancia asimétrica (asymmetric distance computation, ADC), porque un lado está comprimido y el otro no, y es más precisa que comprimir los dos. Son 96 sumas de valores leídos de una tabla que cabe en la caché del procesador, en lugar de 768 multiplicaciones sobre datos que hay que traer de la memoria.
En 2024, Jianyang Gao y Cheng Long publicaron RaBitQ, que también comprime cada dimensión en un bit, pero después de girar los vectores al azar, y con una cota demostrada para el error de la distancia, que la PQ no tiene. En sus pruebas mejora a la PQ en precisión por velocidad.
Toda compresión se paga con error, y la forma de pagar menos es reordenar (re-ranking): usar los códigos comprimidos para elegir deprisa unos cientos de candidatos y calcular sólo para ellos la distancia exacta con los vectores completos, que pueden vivir en disco porque se leen pocos. Casi todos los índices con compresión lo hacen.
Los índices de verdad son combinaciones
Con las dos decisiones separadas, los índices que ofrecen las bibliotecas y las bases de datos se leen como combinaciones.
- IVF-Flat: listas invertidas con los vectores enteros. Es el
ivfflatde pgvector. - IVF-PQ: listas invertidas con códigos PQ, el diseño del artículo de 2011, que lo probó con dos mil millones de vectores. Es el caballo de batalla de Faiss a gran escala, también en GPU.
- HNSW con cuantización: el grafo se recorre comparando vectores comprimidos, y los finalistas se reordenan con los completos.
- ScaNN, de Google (2020): listas invertidas, una cuantización que penaliza más el error en la dirección del propio vector, que es el que más altera el producto escalar con las preguntas que lo encuentran, y reordenación.
- DiskANN (2019): el grafo Vamana y los vectores completos en un SSD, y en memoria sólo los códigos PQ. Los códigos guían la búsqueda, y cada salto lee del disco la lista de vecinos de un nodo junto con su vector completo, guardados juntos para que sea una sola lectura. Así indexa mil millones de vectores en una máquina con 64 GB de memoria y responde más de 5 000 preguntas por segundo, con menos de 3 milisegundos de media.
Faiss hace explícita la idea: sus índices se describen con una cadena que nombra cada pieza.
IVF65536_HNSW32,PQ32 son 65 536 listas invertidas cuyos centros se buscan, a su vez, con un grafo
HNSW de 32 vecinos, y vectores comprimidos con PQ en 32 bytes. La parte de las listas es lo que su
guía recomienda para entre uno y diez millones de vectores.
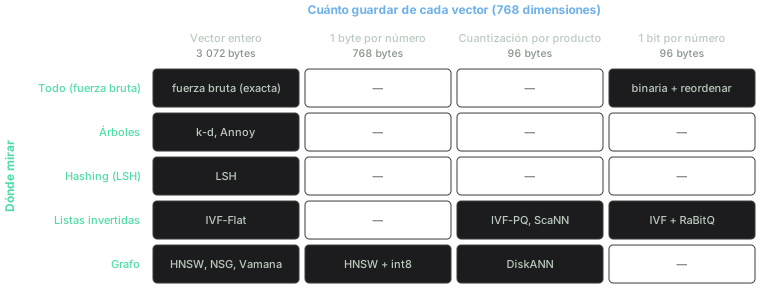
Los índices de este artículo, cada uno en la combinación que elige. Las celdas vacías son combinaciones poco usadas o que el artículo no trata.
Todo esto cabe en una biblioteca, y durante años fue lo único que hubo: Annoy, Faiss, hnswlib, y luego ScaNN y DiskANN. Una biblioteca recibe una matriz de vectores, construye el índice en memoria y responde preguntas. Cuando el equipo de Milvus presentó su sistema en SIGMOD 2021, la conferencia principal de bases de datos, explicó por qué eso no bastaba con una lista de carencias: las bibliotecas suponen que los datos y el índice caben en la memoria de una máquina; suponen que los datos no cambian después de construir; no admiten consultas más allá del vecino más cercano, como filtrar por un atributo; y no aprovechan a la vez el procesador y la GPU. Milvus se construyó encima de Faiss para cubrirlas, y la sección siguiente es, casi punto por punto, esa lista.
Lo que una base de datos tuvo que añadir
La competición Big-ANN, que organizan varios de los autores de los índices de este artículo, ha ido siguiendo esa lista. Su edición de 2021 midió índices para mil millones de vectores con poca memoria o con un SSD, y la de 2023 dedicó una prueba a los filtros, otra a los datos que cambian, otra a los vectores dispersos y otra a las preguntas que no se parecen a los datos.
Filtrar mientras se busca
La pregunta típica no es «los diez fragmentos más parecidos», sino «los diez más parecidos que sean de este cliente, en español y de este año». Hay dos formas obvias de hacerlo, y las dos fallan.
Filtrar antes: quedarse con los vectores que cumplen el filtro y buscar entre ellos por fuerza bruta. Es exacto, y es lo correcto si el filtro deja pocos. Si deja la mitad de diez millones, es una fuerza bruta sobre cinco millones.
Filtrar después: pedir al índice los más cercanos y tirar los que no cumplen. Si el filtro deja
pasar a pocos, no queda casi nada. La documentación de pgvector lo cuenta con números: con un índice
HNSW y su ef_search por defecto de 40, si la condición la cumple el 10 % de las filas, la consulta
devuelve de media 4 resultados. Desde la versión 0.8.0, de 2024, pgvector puede seguir recorriendo el
índice hasta reunir suficientes (iterative index scans), que es pedir más candidatos hasta que
alcancen.
La tercera forma es filtrar durante el recorrido: no saltar a los nodos que no cumplen. El problema es que el grafo se rompe. Andrei Vasnetsov, de Qdrant, lo explicó en 2019 con la teoría de la percolación: si a un grafo al azar con una media de enlaces por nodo se le quitan nodos al azar, por debajo de una fracción de supervivientes de deja de tener un gran trozo conectado, y la búsqueda voraz queda encerrada en islas. La solución de Qdrant fue añadir enlaces: construir, además del grafo general, enlaces entre los vectores que comparten cada valor de un campo filtrable, de modo que el subgrafo de cada valor siga conectado, a cambio de como mucho duplicar los enlaces.
Los artículos posteriores generalizaron la idea. Filtered-DiskANN (2023) construye el grafo teniendo en cuenta las etiquetas de cada vector. ACORN (2024) construye un HNSW más denso y, al buscar, salta sólo a los vecinos que cumplen el filtro, mirando también a los vecinos de los vecinos cuando hace falta, con lo que funciona con cualquier condición y no sólo con igualdades sobre un campo. En sus pruebas da entre 2 y 1 000 veces más preguntas por segundo que los métodos anteriores con el mismo recall, y Weaviate lo incorporó en 2024.
Insertar y borrar
Una biblioteca construye el índice una vez. Una base de datos recibe inserciones, cambios y borrados
todo el tiempo, y cada familia los lleva de una manera. Annoy no admite añadir nada después de
construir. IVF inserta sin esfuerzo, con los centros envejeciendo. Un grafo inserta bien, porque así
es como se construye, pero borra mal, porque quitar un nodo rompe los caminos que pasaban por él. Las
implementaciones lo marcan como borrado, lo siguen usando para navegar sin devolverlo y reparan el
grafo más tarde, que en pgvector es trabajo del VACUUM.
La alternativa obvia, reconstruir el índice cada cierto tiempo, es cara. Los autores de FreshDiskANN (2021) partían de que los grafos existentes sólo servían para índices estáticos, y propusieron uno que acepta miles de inserciones, borrados y búsquedas por segundo sobre mil millones de vectores, con un coste de mantenerlo al día entre 5 y 10 veces menor que el de los métodos anteriores.
Más datos que memoria
Según la fórmula de la guía de Faiss, un HNSW con vectores de 768 dimensiones y ocupa bytes por vector: para cien millones de vectores, 320 GB de memoria. Hay dos salidas, y las dos vienen de Microsoft Research. DiskANN, la de la sección anterior, lleva el grafo al SSD y deja en memoria los códigos PQ. SPANN (2021) hace lo mismo con listas invertidas: los centros en memoria, las listas en disco, y un agrupamiento equilibrado para que ninguna lista sea enorme; en sus pruebas alcanza un recall de 0,90 el doble de deprisa que DiskANN con la misma memoria. SQL Server 2025 eligió DiskANN para su índice vectorial.
Palabras además de vectores
Los embeddings son malos con lo literal: un código de producto, un nombre propio poco frecuente, un número de versión. La búsqueda por palabras de siempre, con un índice invertido y una puntuación como BM25, es buena justo en eso. Por eso las principales bases de datos vectoriales ofrecen búsqueda híbrida: las dos búsquedas a la vez y una fusión de los dos órdenes de resultados. Es más una pieza de la recuperación que de los índices vectoriales, y aquí basta con saber que existe.
Comparación
La figura dibuja, para un representante de cada familia en VIBE, la mejor velocidad que alcanza para cada nivel de recall: cada punto de una curva es la configuración más rápida que llega a ese recall o más. Por eso las curvas bajan en escalones, y cada una acaba en el recall más alto que alcanzó su implementación: PUFFINN, por ejemplo, no pasa de 0,99.
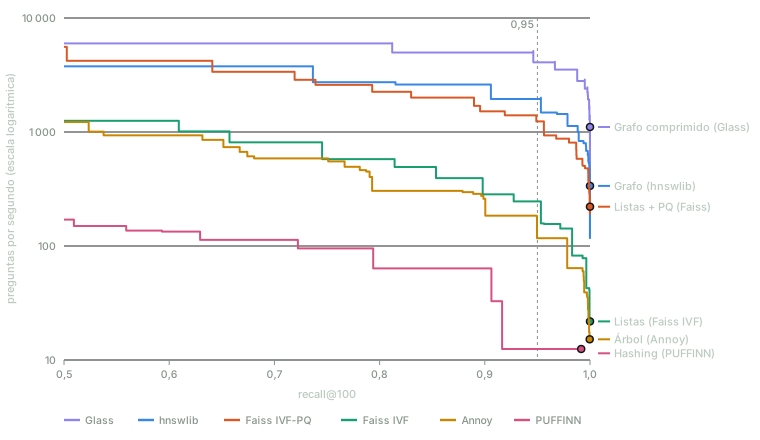
VIBE, 1,3 millones de resúmenes de arXiv en 768 dimensiones, un núcleo, recall@100. Cada curva es la mejor configuración de cada implementación para cada nivel de recall.
La tabla da los valores de cada familia con un recall de al menos , con la memoria que ocupa el índice y lo que tarda en construirse, en un núcleo. Los vectores originales ocupan 4,1 GB.
| Familia | Implementación | Preguntas por segundo | Memoria del índice | Construcción |
|---|---|---|---|---|
| Hashing | PUFFINN | 12 | 9,5 GB | 35 min |
| Árboles al azar | Annoy | 117 | 12,0 GB | 47 min |
| Listas invertidas | Faiss IVF | 246 | 5,7 GB | 10 min |
| Listas con RaBitQ | RaBitQ IVF | 983 | 0,7 GB | 1,3 min |
| Listas con PQ y reordenación | Faiss IVF-PQ | 1 239 | 4,5 GB | 1,4 min |
| Grafo | hnswlib | 2 001 | 4,5 GB | 52 min |
| Grafo comprimido | Glass | 4 125 | 2,8 GB | 15 min |
Se leen tres cosas.
El orden de las familias. Es el del resto del artículo, y el mismo que concluye VIBE sobre el conjunto de sus pruebas: los grafos, primero; las listas invertidas con compresión, cerca; los árboles y el hashing, uno o dos órdenes de magnitud por detrás. El grafo responde ocho veces más preguntas que las listas invertidas sin comprimir, diecisiete veces más que el bosque de árboles y 160 veces más que el LSH. Y comparado con no tener índice: en el millón de vectores de 960 dimensiones de ANN-Benchmarks, hnswlib responde 351 preguntas por segundo con recall 0,95, frente a las 2,6 de la fuerza bruta, unas 130 veces más.
La compresión no es sólo para ahorrar memoria. Las listas invertidas pasan de 246 preguntas por segundo a más de mil al comparar con códigos PQ en lugar de vectores enteros, y a casi mil con RaBitQ, en un índice de 0,7 GB, menos de la quinta parte de los datos originales. El IVF-PQ de Faiss ocupa más porque guarda también los vectores completos para reordenar. Y el índice más rápido de la tabla, Glass, una biblioteca de grafos, recorre el grafo con vectores comprimidos a medio byte por número y reordena con vectores en media precisión, dos bytes por número.
El precio del grafo es la construcción. hnswlib tarda 52 minutos en construir lo que el IVF-PQ de Faiss construye en minuto y medio, unas 38 veces más. Para datos que se reconstruyen a menudo, eso pesa tanto como la velocidad de búsqueda.
Dos advertencias. VIBE mide un núcleo y una pregunta cada vez; con lotes de preguntas en una GPU el panorama cambia de escala, y en la misma prueba CAGRA, el grafo para GPU de NVIDIA, pasa de 100 000 preguntas por segundo con recall 0,95. Y estos son vectores de un solo modelo sobre un solo tipo de texto. En el resto de los conjuntos de VIBE los grafos siguen arriba, pero cuando las preguntas no se parecen a los datos, como al buscar imágenes con una frase, hasta los mejores índices empeoran bastante.
¿Base de datos vectorial dedicada o la que ya tienes?
Los algoritmos no deciden esta pregunta, porque son los mismos en los dos lados. pgvector ofrece HNSW e IVF; Oracle, HNSW e IVF; SQL Server 2025, DiskANN; Elasticsearch y MongoDB Atlas, HNSW. Lo que cambia es todo lo de alrededor.
A favor de la base de datos que ya tienes, los vectores viven junto al resto de los datos: en la
misma transacción, con los mismos permisos y las mismas copias de seguridad. Un filtro es un WHERE,
y se puede cruzar con cualquier otra tabla. Y no hay un segundo sistema que mantener sincronizado con
el primero, que es donde suelen aparecer los errores, cuando un vector y el dato del que salió dejan
de coincidir.
A favor de una dedicada: más índices y más formas de compresión, índices en disco, filtros dentro del recorrido del grafo, reparto entre máquinas cuando los datos no caben en una, y no pagar en cada pregunta el resto de un motor SQL. En ANN-Benchmarks, con los mismos datos y recall 0,90, hnswlib responde 781 preguntas por segundo y pgvector, también con HNSW, 69; parte de la diferencia es el viaje de cada pregunta por la conexión y el ejecutor de SQL. También hay límites concretos: pgvector indexa vectores de hasta 2 000 dimensiones, o 4 000 en media precisión, así que los de 3 072 de algunos modelos actuales no entran en su índice sin reducirlos.
Una regla razonable: si tus datos ya están en PostgreSQL y el índice cabe con holgura en la memoria del servidor sin quitársela al resto de la base de datos, empieza por pgvector. Un millón de vectores de 768 dimensiones con HNSW son unos 3,2 GB. Cuando el índice deja de caber, cuando las preguntas por segundo se cuentan por miles o cuando filtrar exige algo más que pedir más candidatos, una base de datos dedicada empieza a compensar lo que cuesta mantenerla.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: un índice vectorial no encuentra los más cercanos: encuentra casi siempre casi todos, y el «casi» es un parámetro que eliges tú. En cientos de dimensiones, ningún índice exacto evita acabar comparando casi todo, así que todos renuncian a algo. Los árboles y el hashing, a la memoria; las listas invertidas, a lo que queda al otro lado de sus bordes; los grafos, a la construcción rápida y al borrado; la compresión, a la precisión de cada distancia.
Y si te llevas tres cosas más, que sean prácticas.
Mide el recall con tus datos. Toma unos cientos de preguntas reales, calcula sus vecinos exactos por fuerza bruta (es lento, pero se hace una vez) y compáralos con lo que devuelve el índice. Sin eso, no sabes si un cambio de parámetros o de modelo te ha costado resultados.
Ajusta al preguntar, no al construir. ef_search en HNSW y probes en IVF cambian velocidad por
recall sin reconstruir nada, y se pueden subir sólo en las consultas que lo necesitan.
Elige por tamaño, por cambios y por filtros. Mientras la latencia te lo permita, la fuerza bruta es exacta y no hay nada que mantener. Si el índice cabe en memoria, un grafo HNSW. Si no cabe, compresión con reordenación o un índice en disco como DiskANN. Si los datos cambian sin parar, mira cómo borra tu motor. Y si filtras mucho, comprueba cómo filtra antes de que una consulta te devuelva cuatro resultados donde pediste diez.
Los algoritmos de este artículo tienen entre diez y cincuenta años y nacieron fuera de las bases de datos. Lo que las bases de datos vectoriales hicieron fue convertirlos en algo que admite datos que cambian, filtros y más datos que memoria. Por eso, al elegir una, la pregunta útil no es qué algoritmo usa, porque casi todas usan los mismos, sino qué hace con todo lo demás.