 Por Gustavo Torres
Dos frases sobre la inteligencia artificial circulan a la vez, y se contradicen. La primera: una inteligencia artificial general podrá revisar cualquier programa y decirnos si tiene errores. La segunda: ninguna máquina será nunca inteligente de verdad, porque Turing demostró que hay cosas que las máquinas no pueden calcular. Las dos citan el mismo resultado, de 1936, y las dos lo leen mal.
El resultado es el problema de la parada (halting problem): no existe ningún algoritmo que, dado cualquier programa y cualquier entrada, diga si el programa termina o se queda ejecutándose para siempre. Es uno de los teoremas más citados de la informática, y uno de los que más se citan para cosas que no dice.
Este artículo cuenta qué dice exactamente, cómo se demuestra en diez líneas de Python y qué no dice. Después, por qué de él se deduce que casi ninguna pregunta sobre lo que hace un programa tiene un algoritmo general, cómo lo esquivan a diario los compiladores, los verificadores y los tests, y qué pasa cuando quien intenta decidir es una persona.
La pregunta
En 1928, David Hilbert y Wilhelm Ackermann plantearon en un libro de lógica lo que llamaron el Entscheidungsproblem, el «problema de la decisión»: encontrar un procedimiento mecánico que, dada cualquier afirmación de la lógica, dijese si se puede demostrar o no. Hilbert estaba convencido de que existía. En septiembre de 1930, en Königsberg, cerró un discurso con la frase que acabaría en su tumba: «Debemos saber. Sabremos». El día anterior, en la misma ciudad, en un congreso sobre los fundamentos de las matemáticas, un lógico de 24 años, Kurt Gödel, había mencionado casi de pasada, en una mesa redonda, su teorema de incompletitud, que ya apuntaba en la dirección contraria.
El problema tenía una dificultad previa: nadie había definido qué es un «procedimiento mecánico». Mientras la respuesta fuese «sí, éste», bastaba con enseñar el procedimiento. Para demostrar que no existe hacía falta una definición precisa de todos los procedimientos posibles. En 1936 llegaron dos casi a la vez. En primavera, Alonzo Church, en Princeton, publicó la suya, el cálculo lambda, y con ella la primera respuesta negativa. En mayo, Alan Turing, de 23 años, envió a la London Mathematical Society On Computable Numbers, con otra definición y la misma respuesta.
La definición de Turing es la que se quedó, porque se parece a lo que hace una persona con lápiz y papel. Una máquina de Turing tiene una cinta infinita dividida en casillas, cada una con un símbolo, un cabezal que lee una casilla cada vez y una tabla finita de reglas del tipo «si estás en el estado A y lees un 0, escribe un 1, muévete a la derecha y pasa al estado B». Nada más. Turing argumentó que cualquier cálculo que pueda hacer alguien siguiendo instrucciones lo puede hacer una de estas máquinas, y también que existe una máquina universal, capaz de simular cualquier otra si se le da su tabla de reglas escrita en la cinta. Esa máquina universal es, noventa años antes de tiempo, un ordenador que ejecuta programas.
Turing no habló de «parar». Sus máquinas calculaban las infinitas cifras de un número, y lo que demostró es que ninguna máquina puede decidir, para cualquier otra, si seguirá escribiendo cifras para siempre o se atascará. La versión que se enseña hoy, con programas que terminan o no, la escribió Stephen Kleene en 1952, y el nombre de «problema de la parada» lo popularizó Martin Davis en un libro de 1958. Por eso los historiadores discuten si Turing demostró exactamente el problema de la parada; Salvador Lucas ha reconstruido esa historia. La idea de la demostración, en todo caso, es la suya.
Antes de seguir conviene fijar qué significa decidir, porque es la palabra que más se malinterpreta. Un algoritmo decide una pregunta si, para cualquier caso, termina y da la respuesta correcta. Las tres condiciones a la vez. Un algoritmo que acierta en casi todos los casos no decide; uno que acierta siempre pero a veces no termina, tampoco.
La demostración, en Python
Supongamos que alguien nos da una función que resuelve el problema:
def para(programa, entrada):
    """True si programa(entrada) termina; False si se queda ejecutándose
    para siempre. Siempre responde, y nunca se equivoca."""
    ...
No importa cómo funcione por dentro: puede analizar el código, simularlo, consultar un oráculo. Lo único que vamos a usar es que existe y que cumple lo que promete. Con ella se puede escribir este programa:
def paradoja(programa):
    if para(programa, programa):
        while True:   # si el programa termina sobre sí mismo, no terminar nunca
            pass
    else:
        return        # si no termina, terminar
paradoja recibe un programa, pregunta qué haría ese programa si recibiese su propio código como
entrada, y hace lo contrario. Ahora la pregunta es qué pasa con paradoja(paradoja).
- Si
para(paradoja, paradoja)devuelveTrue, es queparadoja(paradoja)termina. Pero entoncesparadojaentra en elwhile Truey no termina nunca. - Si devuelve
False, es queparadoja(paradoja)no termina. Pero entoncesparadojaejecuta elreturny termina.
En los dos casos para se equivoca, y no hay un tercer caso. Así que la función para no puede
existir: ningún programa, por listo que sea, responde bien sobre todos los programas. Ésa es la
demostración entera.
Pasar a un programa su propio código como entrada puede parecer un truco, pero es algo normal. Un
programa es texto, y cualquier programa que lee texto puede leer ese texto: GCC, el compilador de C
más usado, se compila a sí mismo, y un intérprete de Python puede leer cualquier fichero .py, también el suyo.
En la versión formal, para recibe el código fuente como una cadena de caracteres; aquí, para que
se lea mejor, recibe la función.
El argumento tiene nombre: diagonalización. Lo inventó Georg Cantor en 1891 para demostrar que
hay más números reales que naturales, y sirve siempre que se quiera construir algo distinto de
todos los elementos de una lista. Si se ponen en una tabla todos los programas en las filas, todos
los programas otra vez en las columnas, y en cada casilla si el de la fila termina con el de la
columna como entrada, paradoja es la fila que hace lo contrario de la diagonal. Se distingue de
cada programa de la lista justo en una casilla, la suya, así que no puede estar en la lista. Pero
si para existiera, paradoja sería un programa más, y tendría que estar.
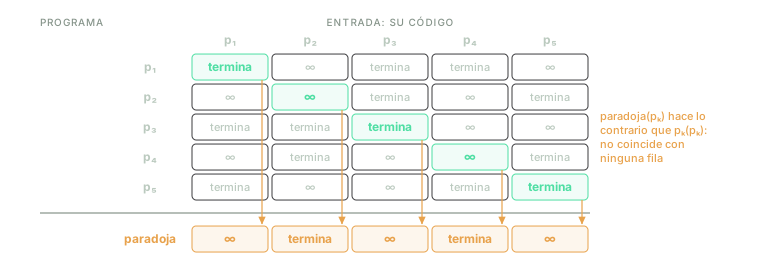
Si para existiera, se podría rellenar la tabla, y paradoja sería una fila más. Pero
paradoja se construye para no coincidir con ninguna.
Hay una consecuencia que conviene tener presente desde ya. La única forma general de saber si un programa termina es ejecutarlo, y eso sólo da la mitad de la respuesta. Si termina, lo ves terminar. Si no termina, nunca llega el momento en que puedes estar seguro: el programa que lleva una hora ejecutándose puede terminar en el minuto 61. Esta asimetría tiene nombre: el problema es semidecidible. Hay un procedimiento que confirma los «sí, termina», pero ninguno que confirme siempre los «no».
Lo que el teorema no dice
El enunciado es corto y los cuantificadores lo son todo: ningún algoritmo, cualquier programa, siempre. Cambiar uno de ellos lleva a afirmaciones que el teorema no hace.
No dice que no se pueda saber si un programa concreto termina. Casi siempre se puede. Este bucle termina, y se ve a simple vista:
for i in range(10):
    print(i)
Lo que el teorema prohíbe es un único método que funcione con todos. De hecho, para cada programa concreto siempre existe un algoritmo que acierta: o el que imprime «sí» o el que imprime «no». El problema no es que no exista la respuesta, sino que ningún procedimiento la encuentra para todos los casos.
No dice que haga falta un programa raro para que sea difícil. Al contrario: algunos de los programas más cortos que existen son los más difíciles. Lo veremos más abajo con uno de cuatro líneas que nadie sabe si termina.
No se escapa porque los ordenadores reales sean finitos. Es una objeción habitual: un ordenador con memoria finita tiene un número finito de estados, así que si se ejecuta más pasos que estados tiene, por fuerza repite uno, y desde ahí se repite para siempre. Con eso se puede decidir si termina. Es cierto, y no sirve de nada: un ordenador con 16 GB de memoria tiene unos estados posibles. El procedimiento existe, pero recorrer esos estados no cabe en la vida entera del universo.
No habla de lo difícil, sino de lo imposible. Hay problemas que se pueden resolver, pero tardando tanto que en la práctica no se puede: comprobar todas las combinaciones de un problema de horarios, por ejemplo. Ésa es la complejidad, y es otra pregunta. El problema de la parada no se resuelve ni con tiempo infinito por adelantado, porque ningún algoritmo sabe cuánto tiempo esperar.
El teorema de Rice: casi nada se puede decidir
El problema de la parada parece una curiosidad sobre bucles infinitos, pero su consecuencia principal es mucho más amplia. En 1953, Henry Gordon Rice demostró que es indecidible cualquier propiedad no trivial de lo que hace un programa. «No trivial» significa sólo que algunos programas la tienen y otros no. «De lo que hace» significa que habla del comportamiento del programa, no de su texto.
La demostración reutiliza la de antes. Supongamos que existe una función que decide una propiedad cualquiera, por ejemplo si un programa devuelve 42 con alguna entrada. Con ella se puede decidir la parada:
def devuelve_42(programa):
    """True si existe alguna entrada con la que programa devuelve 42."""
    ...

def para(programa, entrada):
    def envoltorio(_):
        programa(entrada)   # si esto no termina, envoltorio no devuelve nada nunca
        return 42
    return devuelve_42(envoltorio)
envoltorio devuelve 42 si programa(entrada) termina, y no devuelve nada si no termina. Así que
saber si envoltorio devuelve 42 es saber si programa(entrada) termina, y eso ya sabemos que es
imposible. Cambiando el return 42 por otra cosa, el mismo truco funciona con casi cualquier
propiedad.
La lista de lo que queda fuera es larga, y es la lista de lo que querríamos que hiciera una herramienta:
- ¿Tiene este programa algún error que lo haga fallar con alguna entrada?
- ¿Cumple su especificación?
- ¿Filtra datos que no debería?
- ¿Hacen estos dos programas lo mismo?
- ¿Es este programa un virus? Fred Cohen lo demostró indecidible en 1984, en el primer artículo que dio una definición formal de virus informático, con el mismo argumento de la diagonal.
Ninguna de esas preguntas tiene un algoritmo que la conteste siempre, sin equivocarse, para
cualquier programa. En cambio, las preguntas sobre el texto sí se pueden decidir: si el programa
tiene más de cien líneas, si llama a eval, si usa una biblioteca concreta. Por eso tantas
herramientas de seguridad miran el texto: es lo que se puede decidir, aunque no sea lo que importa.
General, total, exacto: elige dos
Si casi nada se puede decidir, ¿cómo funcionan los compiladores que avisan de errores, los verificadores que certifican software de aviones o los tests? Porque ninguno decide nada en el sentido estricto. El teorema prohíbe un procedimiento que tenga a la vez tres propiedades:
- General: funciona con cualquier programa.
- Total: siempre termina y contesta «sí» o «no».
- Exacto: nunca da una respuesta equivocada.
Se pueden tener dos, y cada herramienta útil que existe ha elegido cuál de las tres sacrificar.
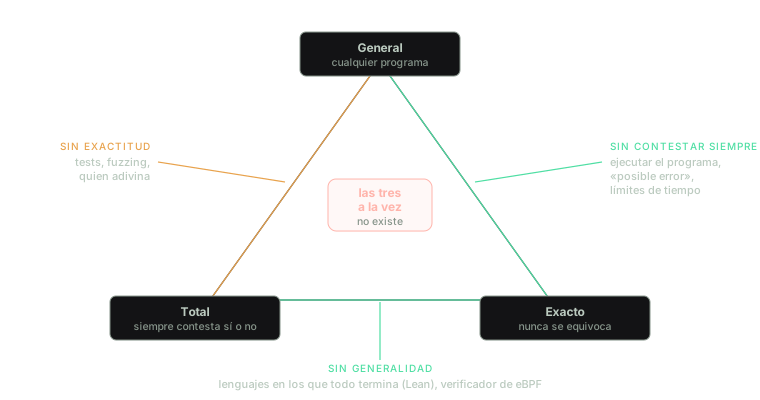
Cada lado del triángulo es una forma de esquivar el teorema. Lo que no existe es el centro.
Restringir la pregunta
La primera salida es no aceptar cualquier programa. Si el lenguaje sólo permite escribir programas que terminan, la pregunta deja de tener sentido.
Es lo que hacen los asistentes de demostración como Lean, Coq (hoy
llamado Rocq) o Agda,
que son a la vez lenguajes de programación y sistemas para escribir demostraciones matemáticas que
el ordenador comprueba. Cuando se define una función recursiva, Lean exige ver que termina: que
algún argumento se hace más pequeño en cada llamada, o una demostración de que lo hace. Si no la
encuentra, rechaza la función, y la única forma de definirla es marcarla como partial, que la
deja fuera de las demostraciones. No es manía. Si Lean aceptase def f (n : Nat) : Nat := f n + 1,
se podría deducir que f n = f n + 1, restar f n en los dos lados y demostrar que . En un
sistema lógico, un programa que no termina es una contradicción.
El núcleo de Linux hace lo mismo por otra razón. Los programas eBPF (extended Berkeley Packet Filter) son pequeños programas que cualquier aplicación con permiso puede cargar en el núcleo para filtrar paquetes de red, medir o vigilar, y un programa que se quedase en un bucle dentro del núcleo bloquearía la máquina. Antes de cargarlo, un verificador recorre todos sus caminos. Hasta Linux 5.3, en 2019, rechazaba cualquier programa con un bucle; desde entonces los admite si, al recorrerlos, comprueba que se acaban, con un presupuesto de un millón de instrucciones analizadas. Si se agota, rechaza el programa, aunque fuera a terminar.
El precio de esta salida es que ningún lenguaje así contiene todos los programas que terminan. La
razón es otra vez la diagonal: el intérprete de un lenguaje en el que todo termina es un programa
que también termina siempre, pero no se puede escribir en ese lenguaje. Tiene incluso un ejemplo
histórico. Un lenguaje cuyos únicos bucles son for con el número de vueltas fijado antes de
empezar termina siempre (calcula lo que los lógicos llaman funciones recursivas primitivas), y en
1928 el mismo Ackermann del Entscheidungsproblem definió una función que siempre termina, que se
puede calcular, y que no se puede escribir en él.
Contestar «no lo sé»
La segunda salida es admitir una tercera respuesta. El procedimiento sigue funcionando con cualquier programa y no se equivoca nunca cuando dice «sí» o «no», pero a veces dice «no lo sé».
El ejemplo más cotidiano es un comprobador de tipos. Éste es un programa de TypeScript que nunca falla, y que el compilador rechaza:
function siempreUno(): number {
  if (1 + 1 === 2) return 1;
  return "nunca llega aquí";   // error: Type 'string' is not assignable to type 'number'
}
La última línea no se ejecuta nunca, pero el compilador no lo sabe, y en lugar de arriesgarse rechaza el programa. Un sistema de tipos es un procedimiento que dice «este programa no tendrá errores de tipos» sólo cuando puede garantizarlo, y «no lo sé» en el resto de los casos, aunque se presente como un error.
La versión industrial de la misma idea es la interpretación abstracta, que formularon Patrick y Radhia Cousot en 1977: en lugar de ejecutar el programa con valores concretos, se ejecuta con aproximaciones, como «este número está entre 0 y 100» o «este puntero puede ser nulo», que cubren todos los valores posibles a la vez. Si la aproximación dice que algo no puede fallar, no falla. Si dice que puede, quizá sí y quizá no, y es una falsa alarma posible. Astrée, un analizador construido así, demostró en 2003, de forma completamente automática, que el software principal de control de vuelo del Airbus A340, de más de cien mil líneas de C, no tenía errores de ejecución (divisiones por cero, desbordamientos, accesos fuera de un vector). No contradice el teorema: Astrée se afinó para ese tipo de programas, y sus propios autores advierten de que la primera vez que se analiza un programa nuevo suele dar falsas alarmas, «posible error» en líneas correctas, que hay que revisar a mano.
Con la terminación pasa lo mismo. Herramientas como Terminator, de Microsoft Research, que en 2006 demostró que terminaban controladores de dispositivos de Windows de más de 20 000 líneas, buscan un argumento de terminación y contestan «termina», «no termina» o «no lo sé». Un límite de tiempo es la versión más simple: si no hay respuesta en quince minutos, la respuesta es «no lo sé». Y ejecutar el programa también es de esta familia: si termina, «sí», con total seguridad; si no, sigue esperando.
Equivocarse a veces
La tercera salida es aceptar errores. El procedimiento funciona con cualquier programa y siempre contesta, pero a veces contesta mal.
Es lo que hacen los tests. Si un programa pasa cien pruebas, se da por bueno, aunque falle con la entrada ciento uno. Edsger Dijkstra lo resumió hace más de cincuenta años: las pruebas pueden demostrar que hay errores, nunca que no los hay. El fuzzing, que genera millones de entradas al azar o mutadas buscando una que rompa el programa, es la misma apuesta a gran escala. Y es lo que hace cualquiera que mira un programa y dice «esto termina» sin demostrarlo: casi siempre acierta, y no siempre.
| Renuncia a | Ejemplos | Qué garantiza |
|---|---|---|
| La generalidad | Lean, Coq, Agda; el verificador de eBPF | Respuesta exacta, sólo para los programas que acepta |
| Contestar siempre | Sistemas de tipos, interpretación abstracta, Terminator, un límite de tiempo, ejecutar el programa | Si dice «sí» o «no», es verdad; a veces dice «no lo sé» |
| La exactitud | Tests, fuzzing, la intuición de quien revisa el código | Siempre contesta, y a veces se equivoca |
La pregunta útil, ante cualquier herramienta o cualquier afirmación sobre lo que puede comprobar, no es si «resuelve» el problema, sino a cuál de las tres renuncia. Todas renuncian a una.
Buscar no es comprobar
Hay una idea que hace que la segunda salida funcione mucho mejor de lo que parece, y que explica por qué se pueden verificar programas reales a pesar del teorema: encontrar una demostración puede ser imposible en general, pero comprobarla es mecánico.
Un ejemplo. Esta función calcula el máximo común divisor con el algoritmo de Euclides:
def mcd(a, b):         # a y b enteros, b >= 0
    while b != 0:
        a, b = b, a % b
    return a
¿Termina siempre? La prueba clásica es encontrar una función de ranking: una cantidad que no
puede bajar de cero y que baja en cada vuelta del bucle. Si existe, el bucle no puede dar infinitas
vueltas, porque una cantidad entera que baja siempre y no pasa de cero se acaba. Aquí la cantidad
es b: mientras el bucle sigue, b es positivo, y el nuevo valor, a % b, está entre 0 y b - 1.
Encontrar esa función requiere ingenio, y no hay ningún algoritmo que la encuentre siempre que exista: si lo hubiera, se podría confirmar siempre que un programa termina con cualquier entrada, y eso también es imposible. Pero una vez propuesta, comprobar que es válida es otra cosa. La comprobación es una afirmación aritmética concreta, y existen programas que deciden afirmaciones de ese tipo: los solucionadores SMT (satisfiability modulo theories), que dicen si una fórmula sobre números, vectores o bits tiene alguna solución. Con algunos tipos de fórmulas, también ellos contestan a veces «no lo sé». Con Z3, el solucionador SMT de Microsoft, la comprobación es ésta:
from z3 import Ints, Solver, And, Not

a, b = Ints("a b")
s = Solver()
# ¿Hay algún estado en el que el bucle sigue y b no baja, o se hace negativa?
s.add(b > 0, Not(And(a % b >= 0, a % b < b)))
print(s.check())   # unsat: no lo hay, así que mcd termina siempre
unsat (unsatisfiable) significa que no existe ningún contraejemplo. La función de ranking es
un certificado: un objeto que alguien ha tenido que encontrar, y que cualquiera puede
comprobar sin repetir la búsqueda.
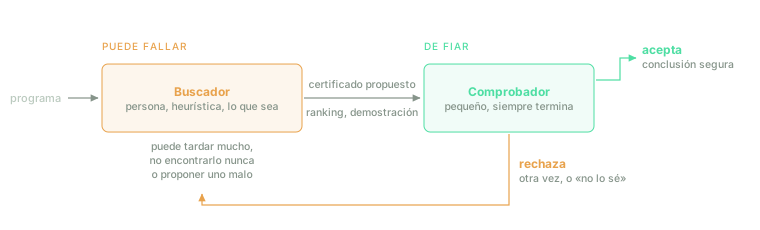
El buscador puede ser cualquier cosa, incluso algo que se equivoca a menudo, porque la garantía la da el comprobador.
Esta asimetría está en todas partes. En Lean, el núcleo que comprueba las demostraciones es un programa pequeño, que siempre termina, y del que depende toda la confianza; las tácticas que buscan las demostraciones pueden ser tan complicadas y tan poco fiables como haga falta. Las herramientas como Terminator funcionan igual: una parte busca funciones de ranking con heurísticas, y otra comprueba cada candidata con un solucionador.
Y explica el reparto de la segunda salida. Para un programa que termina con una entrada concreta, el certificado más simple es la propia ejecución. Para afirmaciones más fuertes, como «termina con cualquier entrada» o «no termina nunca», no siempre existe un certificado que se pueda encontrar, pero muchas veces sí, y cuando existe, buscarlo con cualquier método y comprobarlo con uno fiable da una respuesta segura. El teorema dice que la búsqueda a veces fracasará, no que no merezca la pena.
¿Y nosotros?
Todo lo anterior habla de algoritmos. La pregunta obvia es si una persona, que no es un programa, puede hacer lo que ningún programa hace.
La respuesta estándar es la tesis de Church-Turing: todo lo que se puede calcular siguiendo un método mecánico lo calcula una máquina de Turing. No es un teorema, porque «método mecánico» no es un concepto matemático, pero en noventa años nadie ha encontrado un contraejemplo, y todas las definiciones alternativas que se han propuesto han resultado equivalentes. Si el cerebro funciona según leyes físicas que un ordenador puede simular, aunque sea muy despacio, el teorema también se aplica a nosotros. Pero no hace falta aceptar esa hipótesis para ver que, en la práctica, tampoco decidimos la parada.
Este programa tiene cuatro líneas:
def collatz(n):        # n entero positivo
    while n != 1:
        n = n // 2 if n % 2 == 0 else 3 * n + 1
Si n es par, se divide entre dos; si es impar, se multiplica por tres y se suma uno. Con 6, la
secuencia es 6, 3, 10, 5, 16, 8, 4, 2, 1, y termina. La conjetura de Collatz, de 1937, dice
que termina con cualquier n. Se ha comprobado con ordenador para todos los números hasta ,
unos , y nadie ha conseguido demostrarla. Paul Erdős dijo que las matemáticas
no estaban preparadas para problemas así.
El castor atareado
Hay una forma de medir hasta dónde llegamos. En 1962, Tibor Radó definió el castor atareado (busy beaver): entre todas las máquinas de Turing con estados que, empezando con la cinta en blanco, terminan, ¿cuántos pasos da la que más tarda? Ese número se escribe .
Conocer resolvería el problema de la parada para todas las máquinas de estados: basta con ejecutar cada una pasos, y si no ha terminado, ya no terminará. Por eso no se puede calcular en general, y crece más deprisa que cualquier función que se pueda calcular. Pero para pequeños se puede intentar, máquina a máquina, y es un experimento directo de cuánto puede decidir la gente:
- , y se conocen desde los años sesenta.
- lo demostró Allen Brady en 1983.
- . Heiner Marxen y Jürgen Buntrock encontraron en 1989 la máquina que da esos pasos, pero demostrar que ninguna otra de cinco estados termina más tarde llevó 35 años. Lo consiguió en 2024 bbchallenge, una colaboración abierta, sobre todo de aficionados, que decidió una a una cuáles de 181 385 789 máquinas se paran y comprobó la demostración entera en Coq. Es, otra vez, la asimetría de antes: las técnicas para decidir cada máquina se buscaron como se pudo, y el comprobador garantiza que todas son correctas.
Con seis estados, todo cambia. La mejor máquina conocida, de junio de 2025, da más de pasos, un número tan grande que ni siquiera la altura de la torre de potencias de 2 que lo representa se puede escribir con cifras. Y entre las que todavía no se sabe si se paran está Antihydra, una máquina de seis estados aislada en 2024 cuyo comportamiento, traducido a Python, es éste:
h, c = 8, 0
while c != -1:
    c += 2 if h % 2 == 0 else -1
    h += h // 2
h crece multiplicándose por algo menos de 1,5 en cada vuelta, y c sube dos cuando h es par y baja uno
cuando es impar. El programa termina si alguna vez los impares acumulados superan al doble de los
pares. Si la paridad de h se comporta como una moneda al aire, c sube de media y
cada vez es más difícil que vuelva a bajar: se ha simulado más de vueltas, c ya pasa de
, y la probabilidad de que llegue a desde ahí es despreciable. Pero demostrar que no pasará
nunca es un problema del mismo tipo que Collatz, y nadie sabe hacerlo. Hasta que alguien lo
consiga, nadie conoce .
Un poco más lejos están las conjeturas famosas. Una máquina de 15 estados se para si y sólo si es falsa una conjetura de Erdős sobre las potencias de 2 escritas en base 3, así que conocer la resolvería. Se han publicado máquinas de 27 estados para la conjetura de Goldbach y de 744 para la hipótesis de Riemann, aunque sin una demostración formal de que sean correctas.
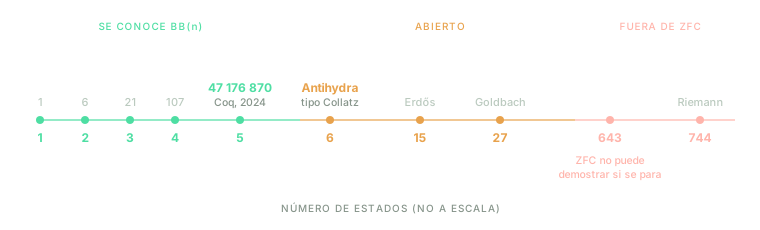
Hasta dónde llega lo que sabemos decidir. La frontera entre lo conocido y lo abierto está en seis estados; la de lo que ni siquiera se puede demostrar, como mucho en 643.
Lo que ni siquiera se puede demostrar
El último punto de la figura es de otra naturaleza. Que nadie sepa si Antihydra se para puede ser falta de ingenio: quizá alguien encuentre la demostración mañana. Pero hay máquinas para las que no es cuestión de ingenio.
La razón es la relación entre el teorema de Turing y el de Gödel. Las matemáticas actuales se apoyan en unos axiomas concretos, la teoría de conjuntos de Zermelo-Fraenkel con el axioma de elección (ZFC). Demostrar algo es encadenar pasos a partir de esos axiomas, y comprobar una demostración es mecánico. Si ZFC pudiera demostrar, para cada máquina que no se para, que no se para, habría un algoritmo para el problema de la parada: ejecutar la máquina y, en paralelo, buscar todas las demostraciones posibles de que no se para, hasta que pase una de las dos cosas. Como ese algoritmo no existe, ZFC tiene que dejar sin demostrar algunas afirmaciones de la forma «esta máquina no se para», aunque sean verdaderas. Ésa es una versión del teorema de incompletitud de Gödel.
En 2016, Adam Yedidia y Scott Aaronson construyeron una máquina concreta, de 7910 estados, que busca una contradicción en ZFC y se para si la encuentra. Si ZFC no tiene contradicciones, como casi todos los matemáticos creen, la máquina no se para nunca. Pero ZFC no puede demostrar que no tiene contradicciones (eso es el segundo teorema de Gödel), así que tampoco puede demostrar que esa máquina no se para. Desde entonces se ha reducido: 745 estados en 2023, 643 en 2024. Así que el valor de no se puede determinar con las matemáticas que usamos, y no por falta de tiempo o de ingenio. Ni una persona ni una máquina que razone dentro de ZFC puede hacerlo.
El argumento contrario
Existe una objeción famosa a todo esto. En 1961, el filósofo John Lucas, y en 1989 el físico Roger Penrose, en La nueva mente del emperador, argumentaron que la mente humana no puede ser un algoritmo, precisamente por Gödel: para cualquier sistema formal, una persona puede «ver» que su frase de Gödel es verdadera, aunque el sistema no pueda demostrarla.
La mayoría de lógicos y filósofos no lo aceptan, y la razón está en lo que hace falta para «ver» esa verdad. La frase de Gödel de un sistema es verdadera sólo si el sistema no tiene contradicciones. Para verla, una persona necesitaría saber que el sistema que la describe a ella misma no tiene contradicciones, y no hay ningún motivo para pensar que lo sabemos; de hecho, cometemos errores y nos contradecimos. Collatz, Antihydra y la máquina de ZFC son el argumento práctico: si las personas pudiéramos ver lo que ningún algoritmo ve, éstos serían buenos sitios para demostrarlo.
Esto corta en las dos direcciones. Si el teorema nos limita igual que a las máquinas, tampoco es un argumento de que las máquinas no puedan llegar a ser tan capaces como nosotros. El problema de la parada no separa a las personas de los ordenadores. Separa las preguntas que tienen un método general de las que no lo tienen, para cualquiera que intente contestarlas.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: el teorema no prohíbe saber si un programa termina, ni comprobar que un programa es correcto. Prohíbe un único procedimiento que funcione con cualquier programa, conteste siempre y no se equivoque nunca. Todo lo que funciona en la práctica renuncia a una de las tres cosas.
Y si te llevas tres más, que sean éstas:
Casi todo lo interesante sobre un programa es indecidible. El teorema de Rice extiende el problema de la parada a cualquier pregunta sobre lo que hace un programa: si tiene errores, si es seguro, si cumple su especificación. Lo que sí se puede decidir son preguntas sobre su texto.
La salida práctica es el certificado. Buscar una demostración puede no acabar nunca, pero comprobarla es mecánico. Una herramienta que encuentra certificados y otra pequeña y fiable que los comprueba dan respuestas seguras para muchos programas reales, y «no lo sé» para el resto.
Las personas no escapamos. Un programa de cuatro líneas, el de Collatz, lleva casi noventa años sin respuesta, y hay máquinas de unos cientos de estados de las que las matemáticas que usamos no pueden demostrar si se paran.
Ante cualquier afirmación de que algo, una herramienta, un método o una inteligencia artificial, «verifica programas», tres preguntas bastan para situarla: ¿con cualquier programa, o con los de una clase concreta? ¿Contesta siempre, o a veces dice «no lo sé»? Y cuando contesta, ¿hay un certificado que alguien pueda comprobar, o hay que fiarse?