Experiencias, reflexiones y lo que voy aprendiendo
Artículos sobre programación, matemáticas e IA con una mirada analítica.
18 artículos en todas las áreas
Página 1 de 3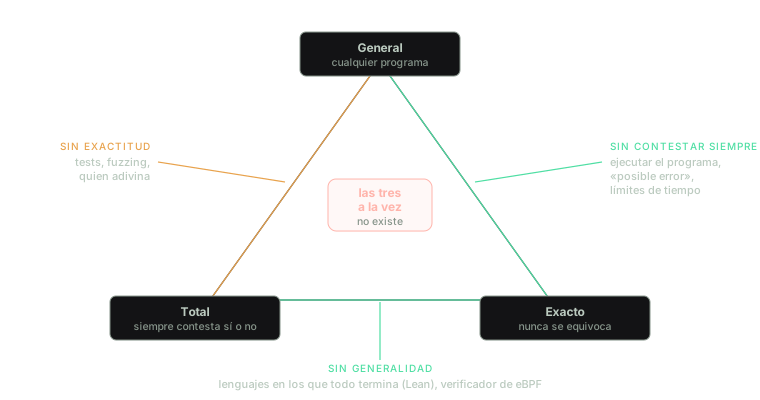
El problema de la parada: qué prohíbe exactamente y qué no
En 1936 Alan Turing demostró que ningún algoritmo puede decidir, para cualquier programa, si termina o se queda ejecutándose para siempre. Qué dice exactamente ese resultado, cómo se demuestra en diez líneas de Python, qué no dice, por qué de él se deduce que casi ninguna pregunta sobre lo que hace un programa tiene un algoritmo general, cómo lo esquivan a diario los compiladores, los verificadores y los tests, y por qué tampoco las personas escapamos de él.
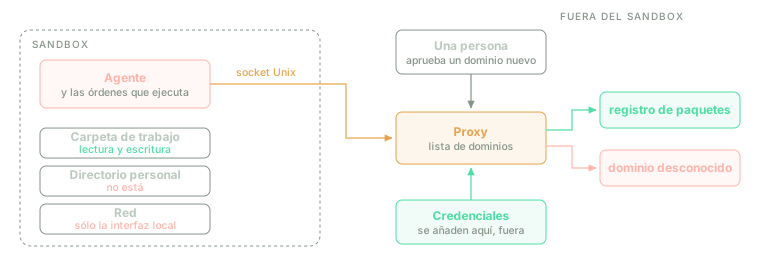
Sandboxes para agentes de IA: por qué el modelo no es la frontera
Un agente de programación lee un README con una línea escondida, ejecuta la orden que le pide y tu clave privada sale de la máquina. Por qué un agente es código que nadie ha revisado, qué es la tríada letal, cómo aíslan hoy los intérpretes de código, los agentes locales, los que usan el ordenador y los de la nube, cómo se diseña la política (ficheros, red, secretos, recursos y aprobaciones), un ejemplo con bubblewrap y lo que ningún sandbox resuelve.
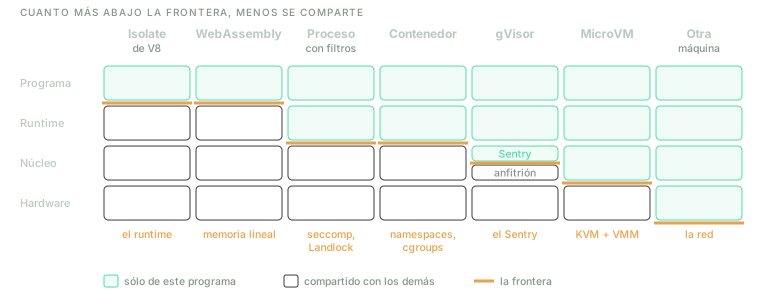
Qué es un sandbox, qué no lo es y cuándo hace falta
Cada página web que abres ejecuta código de un desconocido, y no pasa nada porque algo que ese código no puede tocar decide qué le está permitido. Qué es un sandbox, de dónde viene, dónde se puede poner la frontera (en el lenguaje, en el proceso, en el núcleo o en el hipervisor), cuánto cuesta cada opción y cuándo elegirla, qué cosas se llaman sandbox sin serlo y cuándo no hace falta ninguno.
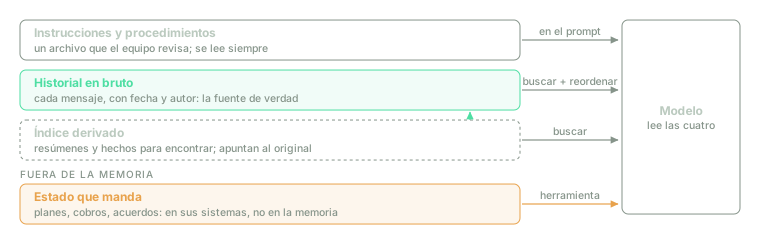
Memoria para agentes: qué guardar, cómo leerlo y si hace falta tanto
Un asistente con memoria responde que un cliente aún está en plazo de reembolso, citando lo que le contaron en marzo, y olvida lo que le contaron en junio. Para qué necesita memoria un agente, los cuatro tipos que distingue la ciencia cognitiva, cómo funciona por dentro un sistema de memoria, cómo ha evolucionado desde 2023, cómo se mide y por qué un artículo de octubre de 2026 encontró que buscar en las conversaciones tal cual, sin transformarlas, gana a doce sistemas mucho más complejos.
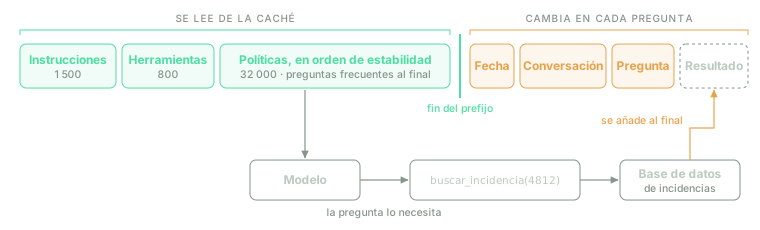
Generación aumentada por caché (CAG): cuándo no hace falta buscar
Un asistente con buscador cita la regla general de reembolsos y se equivoca, porque la regla de su plan estaba en un fragmento que no encontró. Qué es la generación aumentada por caché (CAG), cómo la caché KV hace barato darle al modelo todos los documentos, qué midió el artículo que le puso nombre, dónde se rompe y cuándo conviene en lugar de buscar.
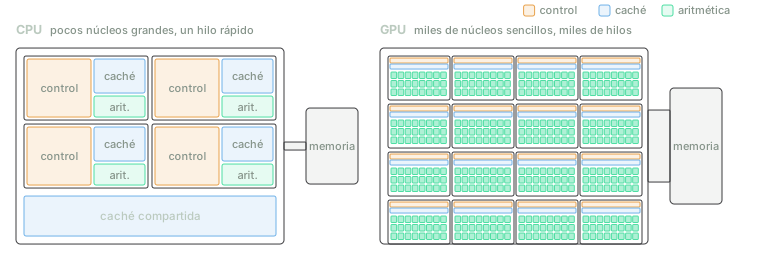
Por qué un chip pensado para videojuegos entrena los modelos de lenguaje
En 1999, la GPU nació para multiplicar cada vértice de un videojuego por una matriz de 4×4; hoy entrena modelos de lenguaje de 405 000 millones de parámetros. Por qué los videojuegos necesitaron un chip propio, por qué un modelo de lenguaje hace en el fondo la misma operación, por qué la CPU no basta para ninguno de los dos, en qué se diferencian entrenar y usar un modelo, y por qué la historia se repite con los chips hechos sólo para IA.
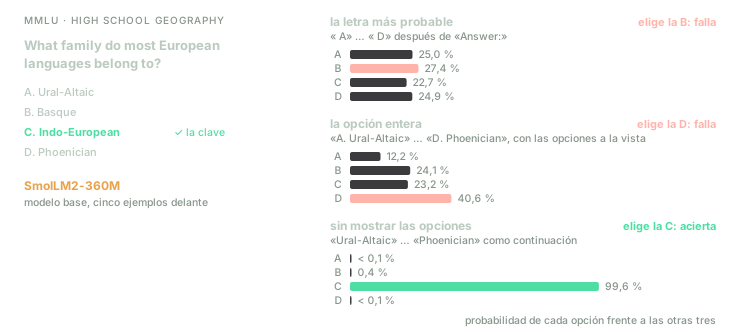
El mismo examen, tres notas: qué mide de verdad un banco de pruebas
El mismo modelo, con las mismas 14 042 preguntas de MMLU, saca un 63,6 % o un 48,8 % según cómo se lea su respuesta. Qué hay dentro de un banco de pruebas con respuesta fija, las tres formas de leer lo que contesta un modelo, lo que mueve la nota sin tocar el modelo (el orden de las opciones, el formato, haber visto el examen, el número de preguntas) y qué preguntar antes de fiarse de la cifra de la ficha de un modelo.
Artículos 1–7 de 18
Inicia sesión para recibir una notificación cuando publique un artículo nuevo