 Por Gustavo Torres
Dos titulares se repiten cada vez que sale un modelo nuevo. Uno anuncia que la inteligencia artificial (IA) ya se programa a sí misma y que pronto revisará todo nuestro código mejor que nosotros. El otro responde que nunca será inteligente de verdad, porque Alan Turing demostró en 1936 que hay cosas que ninguna máquina puede calcular. Los dos invocan el mismo teorema, el problema de la parada, y los dos sacan de él más de lo que dice.
Este artículo aplica ese teorema a la IA con cuidado. Primero, dónde aparece de verdad en un sistema de IA, que no es donde suele pensarse. Después, qué queda fuera para siempre, para una IA y para cualquiera. Y por último, qué sí puede mejorar, y mejora ya: demostrar que programas concretos terminan, escribir código con su demostración de corrección, alucinar menos, razonar mejor y mejorarse a sí misma. En todos los casos la mejora tiene la misma forma, y el teorema explica por qué.
El mapa, en tres párrafos
El problema de la parada pregunta si existe un algoritmo que, dado cualquier programa y cualquier
entrada, diga si el programa termina o se queda ejecutándose para siempre. No existe. La
demostración supone que existe una función para(programa, entrada) que acierta siempre, construye
un programa que le pregunta qué hará él mismo y hace lo contrario, y llega a una contradicción. En
1953 Henry Rice extendió el resultado a cualquier propiedad no trivial de lo que hace un
programa: si tiene errores, si cumple su especificación, si filtra datos, si es dañino. Ninguna
tiene un algoritmo general.
La palabra clave es decidir. Un procedimiento decide una pregunta si cumple tres condiciones a la vez. Es general: funciona con cualquier programa. Es total: siempre termina y contesta. Y es exacto: nunca da una respuesta equivocada. El teorema prohíbe las tres juntas, no cada una por separado. Un lenguaje en el que todo programa termina renuncia a la generalidad; un analizador que a veces contesta «no lo sé» renuncia a la totalidad; un test que da por bueno un programa con un error escondido renuncia a la exactitud. Todas las herramientas útiles que existen eligen una renuncia.
Y hay una asimetría que lo hace todo practicable: encontrar una demostración puede ser imposible en general, pero comprobarla es mecánico. Si alguien propone un argumento de que un bucle termina, por ejemplo una cantidad que no puede bajar de cero y que baja en cada vuelta (una función de ranking), un programa pequeño y fiable puede comprobarlo sin repetir la búsqueda. Ese argumento comprobable se llama certificado. El artículo anterior de esta serie cuenta todo esto con detalle, con la demostración en Python y lo que significa para las personas; aquí basta con este mapa.
Dónde entra el teorema en un sistema de IA
Se suele decir que el problema de la parada «se aplica a la IA» como si se aplicase al modelo. Pero un modelo de lenguaje grande (large language model, LLM), por sí solo, no puede quedarse en un bucle infinito, y por eso conviene separar tres piezas que a menudo se confunden.
Una pasada siempre termina
Un LLM genera texto de token en token, y cada token sale de una pasada del modelo (forward pass): la entrada atraviesa un número fijo de capas, cada una con una cantidad de operaciones conocida. Para un modelo y una longitud de entrada dados, es un circuito finito. No tiene bucles que dependan de los datos, así que siempre termina, y en un tiempo que se conoce de antemano.
Eso no hace fáciles las preguntas sobre la red. «¿Hay alguna entrada en esta región que cambie la decisión del modelo?» es una pregunta decidible, porque se puede, en principio, recorrer todos los casos. Pero el coste explota. En 2017, el equipo de Reluplex, un verificador de redes neuronales de Stanford, demostró que comprobar propiedades de las que usan activaciones ReLU (la función que deja pasar los positivos y convierte los negativos en cero) es NP-completo: tan difícil como los problemas combinatorios más duros que se conocen. Con su herramienta verificaron 45 redes del sistema anticolisión ACAS Xu (Airborne Collision Avoidance System X, para aviones no tripulados), de 300 neuronas cada una, un orden de magnitud más que lo que se había conseguido antes. Un LLM tiene miles de millones de parámetros.
Así que la barrera al analizar una pasada es de complejidad, no de computabilidad: el problema tiene solución, pero no cabe en el tiempo disponible. Es una distinción que importa, porque la complejidad se puede atacar con estructura, aproximaciones y hardware, y la computabilidad no.
Pensar más pasos cambia la complejidad, no el tipo de problema
Cuando un modelo «razona» escribiendo pasos intermedios antes de la respuesta, la cadena de pensamiento (chain of thought), hace muchas pasadas seguidas, cada una con lo que escribieron las anteriores. ¿Cambia eso lo que puede calcular? Sí, y mucho: cuantos más pasos escribe, más problemas puede resolver. Lo que no cambia es que termina. William Merrill y Ashish Sabharwal lo midieron con detalle en 2024, para transformers (la arquitectura de todos los LLM actuales) que calculan con una precisión numérica realista.
El punto de partida es pobre. Sin pasos intermedios, un trabajo anterior de los mismos autores había mostrado que estos modelos quedan dentro de una clase muy pequeña, TC⁰: lo que se calcula con un circuito de profundidad fija, por larga que sea la entrada. Si las conjeturas habituales de la teoría de la complejidad son ciertas, eso deja fuera cosas tan simples como seguir un autómata finito sobre una entrada de cualquier longitud o saber si dos nodos de un grafo dirigido están conectados. Con pasos intermedios, la capacidad crece según cuántos haya:
- Con un número logarítmico de pasos (respecto a la longitud de la entrada), casi nada: como mucho, la clase L, los problemas que se resuelven con memoria logarítmica.
- Con un número lineal, ya pueden seguir cualquier autómata finito (reconocen todos los lenguajes regulares), lo que sin pasos intermedios no podían.
- Con un número polinómico, resuelven exactamente los problemas de P, los que un ordenador resuelve en un tiempo que crece como un polinomio de la longitud de la entrada.
Así que la respuesta a la pregunta es que la cadena de pensamiento mueve al modelo dentro del mapa de la complejidad, de una clase pequeña a P, pero no lo saca de ese mapa. Esto explica buena parte de lo que se llama «razonamiento débil». Cuando un modelo falla al seguir una cadena larga de deducciones sin escribirlas, no choca con Turing: le falta cálculo, y escribir pasos se lo da. Y como el número de pasos siempre tiene un tope, el máximo de tokens que se le deja generar, una cadena de pensamiento también termina, por larga que sea.
Sólo quitando ese tope cambia el tipo de problema. En 2021, Pérez, Barceló y Marinkovic mostraron que un transformer que calcula con precisión arbitraria y puede generar pasos sin límite es Turing-completo: puede calcular todo lo que calcula una máquina de Turing, es decir, ejecutar cualquier programa. Esa potencia trae consigo el problema de la parada, porque entonces hay ejecuciones que no terminan y ningún método general para saber cuáles. Pero es un modelo idealizado, no lo que se ejecuta en la práctica.
El agente sí es una máquina universal
La tercera pieza es la que cambia las cosas. Un agente es un programa que le pide al modelo el siguiente paso, lo ejecuta y le devuelve el resultado, una y otra vez, hasta que éste decide que ha terminado. Simplificado:
def agente(tarea):
    historial = [tarea]
    while True:
        paso = modelo(historial)          # una pasada, o muchas: siempre termina
        if paso.es_respuesta_final:
            return paso.texto
        historial.append(ejecutar(paso))  # puede escribir y ejecutar cualquier programa
Cada llamada a modelo termina. Pero el while True no tiene un número de vueltas fijado, y
ejecutar puede lanzar código arbitrario, que a su vez puede no terminar. En cuanto un agente puede
escribir programas y ejecutarlos, el sistema completo es tan potente como una máquina de Turing
universal, y todas las preguntas sobre lo que hará caen bajo el teorema de Rice: si terminará, si
borrará un fichero que no debía, si enviará fuera un secreto.
Por eso ningún agente real tiene un while True desnudo. Todos llevan un máximo de pasos, un límite de tiempo o un presupuesto de tokens: renuncian a la totalidad, igual que un analizador que, pasado
un rato, dice «no lo sé». Y por eso la seguridad de un agente no se puede basar en predecir lo que
hará, sino en restringir lo que puede hacer, que es la idea de los
sandboxes para agentes.
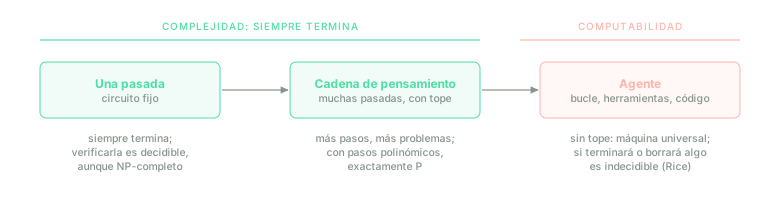
El modelo y su cadena de pensamiento siempre terminan; su límite es de complejidad. La indecidibilidad entra con el bucle del agente.
Lo que queda fuera para siempre
Con el mapa delante, se puede separar lo imposible de lo difícil. Lo imposible es todo lo que pide las tres propiedades a la vez, y no depende de lo lista que sea la IA.
Verificar cualquier programa
Ninguna IA, por capaz que sea, podrá recibir cualquier programa y decir siempre, sin equivocarse, si tiene errores, si termina o si cumple su especificación. Es Rice, tal cual. Tampoco con el código que escribe ella misma: un modelo que genera programas y los revisa sigue enfrentándose a la misma pregunta indecidible sobre su propia salida. Una IA que «verifica código» tiene que renunciar a algo, y la pregunta útil ante cada producto es a qué.
Contener una superinteligencia simulándola
En 2021, Manuel Alfonseca y otros cinco autores
publicaron un artículo con un título rotundo: una superinteligencia no se puede contener. El
argumento es una reducción del problema de la parada. Supongamos una función Harm(R, D) que decide
si un programa R con datos D hará daño a las personas. Con ella se escribe un programa que
ejecuta una máquina de Turing cualquiera y, si termina, hace daño. Saber si ese programa hace daño
es saber si la máquina termina, y eso es imposible. Por tanto, ningún algoritmo decide si un
programa arbitrario es dañino, y un sistema de contención que funcione decidiendo eso no puede
existir.
El resultado es correcto, y su alcance depende de una suposición que los autores escriben explícitamente: que la superinteligencia puede simular cualquier máquina de Turing y que sus datos son el estado del mundo. Es decir, que el programa a contener es completamente general. Lo que el teorema prohíbe es un contenedor general, total y exacto: uno que, mirando cualquier programa, prediga siempre y sin error si hará daño. Los propios autores lo dicen justo después del resultado: en la práctica, problemas como éste se abordan con soluciones aproximadas, aceptando una tasa de error pequeña pero positiva.
Los sandboxes toman otro camino: no predicen nada. Un sandbox es un entorno en el que un programa se ejecuta sin poder tocar lo que queda fuera: no decide si el agente querrá borrar tu disco, se lo impide. Eso renuncia a la generalidad (el agente no puede hacer cualquier cosa), y por eso sí es posible. Los autores dudan de que restringir sirva con una superinteligencia, porque quitarle acceso al mundo le quitaría lo que la hace útil; es un argumento sobre lo que querríamos de ella, no un teorema. El artículo añade otra consecuencia de Rice, más curiosa: «ser superinteligente» también es una propiedad de lo que hace un programa, así que tampoco hay un algoritmo que decida, mirando el código, si una máquina lo es. Medirlo con pruebas sí se puede; con garantía, no.
Demostrar que el sucesor es mejor
La idea de una IA que se mejora a sí misma tiene una formulación rigurosa de 2003: la máquina de Gödel de Jürgen Schmidhuber. Es un programa que reescribe cualquier parte de su propio código, pero sólo cuando ha encontrado una demostración formal de que la reescritura mejora su utilidad. La garantía es perfecta y el precio también lo es: el propio Schmidhuber señala que la máquina tiene que ignorar todas las mejoras cuya utilidad no consigue demostrar. «¿Es esta versión mejor que la actual?» es una propiedad de lo que hacen dos programas, y Rice dice que no hay un método general para contestarla. La máquina de Gödel elige ser exacta y renuncia a la totalidad: sólo cambia cuando puede probarlo, y en la práctica eso casi nunca ocurre.
Hay un obstáculo más fino, que tiene que ver con fiarse del sucesor. En 2013, Eliezer Yudkowsky y Marcello Herreshoff, del MIRI (Machine Intelligence Research Institute), lo llamaron el obstáculo de Löb. Supongamos que un agente sólo aprueba un sucesor si puede demostrar que todo lo que éste haga estará justificado. Si el sucesor razona con la misma teoría matemática que él, el agente necesita poder afirmar: «todo lo que demuestro es verdad». El teorema de Löb, de 1955, dice que una teoría consistente no puede demostrar eso sobre sí misma en general. La consecuencia, en el planteamiento más directo, es que cada sucesor tendría que razonar con una teoría más débil que el anterior, y una cadena de automejoras se iría degradando. Los autores encontraron rodeos técnicos parciales y dejaron el problema abierto.
Nada de esto prohíbe que una IA mejore. Prohíbe que lo haga con garantía demostrada en general. Más abajo veremos qué pasa cuando se cambia la demostración por un examen.
No alucinar nunca
En 2024, Ziwei Xu, Sanjay Jain y Mohan Kankanhalli, de la
Universidad Nacional de Singapur, demostraron que las alucinaciones son inevitables. Definen un
mundo formal en el que la verdad es una función computable f que asigna a cada pregunta su única
respuesta correcta, y un LLM alucina si, por mucho que se entrene, sigue equivocándose en alguna. Su teorema dice que, para cualquier LLM computable, existe una f computable con
la que alucina en infinitas preguntas.
La demostración es la misma diagonal que la del problema de la parada. Si se numeran todos los modelos posibles (cada estado de entrenamiento de cada uno), se puede definir la verdad así:
def verdad(i):
    respuesta = modelo(i)(pregunta(i))   # lo que contesta el i-ésimo modelo a la i-ésima pregunta
    return otra_distinta(respuesta)      # la verdad es justo otra cosa
Cada modelo se equivoca al menos en su pregunta de la diagonal, y como la construcción se puede repetir, en infinitas. El resultado es correcto, y conviene leerlo con la misma atención a los cuantificadores que el teorema de Turing:
- Es un resultado de existencia. Para cada modelo hay un mundo, construido a propósito contra él, en el que falla. No dice nada de cuántas veces falla un modelo concreto con preguntas reales, que es lo que importa al usarlo.
- Supone que el modelo contesta siempre. Los propios autores lo dicen: un modelo que nunca contesta tampoco alucina. Y su teorema principal no se aplica a un modelo que consulta fuentes externas o usa herramientas.
En el lenguaje del trilema, lo imposible es un modelo que conteste cualquier pregunta (general), siempre (total) y sin error (exacto). Un modelo que a veces dice «no lo sé» no está cubierto por el teorema. Si eso es una salida práctica o una trampa depende de cuántas veces lo diga, y es la pregunta de una sección posterior.
Proponer y comprobar
Todo lo que queda fuera pide las tres propiedades. Lo que mejora renuncia a una, y casi siempre a la misma: la totalidad. El patrón es el de los certificados. El modelo hace de buscador: propone un veredicto acompañado de un argumento que se pueda comprobar. Un programa pequeño, que siempre termina, hace de comprobador: lo acepta o lo rechaza. Si lo acepta, la conclusión es segura aunque el modelo no sea de fiar. Si lo rechaza, le devuelve el error y el modelo lo intenta otra vez, hasta que se acaba el presupuesto y la respuesta es «no lo sé».
Los comprobadores son de tres tipos. Un solucionador SMT (satisfiability modulo theories), como Z3, de Microsoft, dice si una fórmula sobre números, vectores o bits tiene alguna solución. Un demostrador de teoremas, como Lean, comprueba demostraciones matemáticas escritas en un lenguaje formal. Y un verificador de programas, como Dafny, comprueba que un programa cumple la especificación escrita junto a él. Lo que comprueban es mecánico; lo difícil, encontrar qué darles, se lo dejamos al modelo.
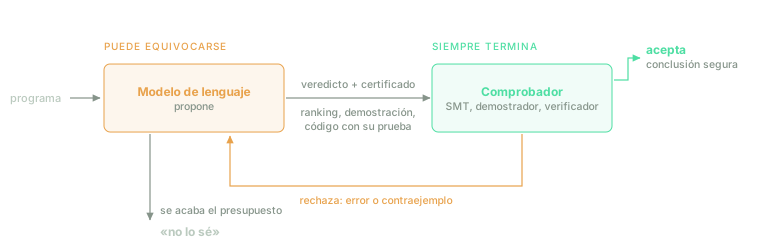
La garantía la da el comprobador. El modelo puede ser tan creativo y tan poco fiable como haga falta.
Terminación
El certificado clásico de que un bucle termina es la función de ranking: si existe una cantidad que no puede bajar de cero y baja en cada vuelta, el bucle no puede dar infinitas vueltas. Encontrarla requiere ingenio; comprobar que una función propuesta cumple las dos condiciones es una pregunta que un solucionador SMT contesta.
La idea de usar una red neuronal como buscador es anterior a los LLM. En
Neural Termination Analysis, de 2022, Mirco Giacobbe, Daniel
Kroening y Julian Parsert entrenaban una red diminuta, de menos de diez neuronas, con ejecuciones
del programa, para que su salida bajase a lo largo de cada ejecución. Después, un solucionador SMT
comprobaba si la red era una función de ranking válida para todas las ejecuciones posibles, no
sólo las vistas. Con bucles como while (x*x*x < y) x++, que dos herramientas clásicas, AProVE y
Ultimate, no conseguían demostrar en un minuto, la red encontraba y verificaba max(y - x, 0) en
menos de un segundo. Conviene no exagerar: en los 110 problemas estándar de su banco de pruebas, la
red resolvía el 76,6 %, por detrás de AProVE (89,1 %) y Ultimate (86,4 %). Su ventaja estaba en los
bucles no lineales.
Con los LLM, la pregunta cambió: ¿saben si un programa termina? Un equipo del laboratorio de investigación en IA de Meta (FAIR, Fundamental AI Research), la Universidad Hebrea de Jerusalén, Bloomberg, el Imperial College y el University College de Londres lo midió en 2026 con los 2328 programas en C de la categoría de terminación de SV-COMP 2025 (Competition on Software Verification, la competición anual de verificadores de software). La competición puntúa así:
| Respuesta | Puntos |
|---|---|
| «Termina», y es verdad | +2 |
| «No termina», verdad y con un testigo válido | +1 |
| «No lo sé» | 0 |
| «No termina», y es falso | −16 |
| «Termina», y es falso | −32 |
Con esas penalizaciones, responder «termina» sólo compensa si la probabilidad de acertar es mayor que 32/34, alrededor del 94 %. La competición castiga un error mucho más de lo que premia un acierto. Los autores pidieron diez respuestas a cada modelo y sólo daban un veredicto si todas coincidían; si no, «no lo sé». Con ese consenso, GPT-5, de OpenAI, sumó 3520 puntos y Claude Sonnet 4.5, de Anthropic, 3448, que los habrían situado segundo y tercero de la competición, detrás sólo de PROTON, la herramienta que ganó.
El resultado interesante está en el testigo. Para cada «no termina», SV-COMP pide una descripción de la ejecución infinita, un ciclo de estados por el que el programa puede dar vueltas para siempre, y otra herramienta la comprueba con un solucionador SMT. Ahí los modelos se hunden: sólo el 41,4 % de los testigos de GPT-5 y el 40,7 % de los de Claude eran válidos, y eso contando sólo los casos en los que el veredicto era correcto. Los autores lo describen como una brecha entre reconocer lo que hace un programa y producir la prueba simbólica. Dicho con el trilema: el veredicto sin más es una apuesta muy buena, y renuncia a la exactitud; el veredicto con un testigo comprobado es seguro, pero sólo llega en menos de la mitad de los casos.
La integración con un demostrador es el paso siguiente. En un trabajo presentado en ITP 2026, la conferencia de demostración interactiva de teoremas, Zeke Medley y Panagiotis Manolios, de la Universidad Northeastern, conectaron dos modelos de pesos abiertos, gpt-oss-120b, de OpenAI, y Qwen3-32B, de Alibaba, con ACL2s, un demostrador de teoremas para programas escritos en un dialecto de Lisp. El modelo propone una medida, la función de ranking de un programa recursivo; ACL2s intenta demostrar que es válida y, si falla, le devuelve el error o un contraejemplo. En su colección de 42 funciones, gpt-oss-120b resolvió el 70 % de las de un curso universitario y el 93 % de las de competiciones de terminación, frente al 65 % y el 63 % del análisis que ACL2s trae incorporado. Combinando las dos cosas, el modelo y el análisis automático, resolvieron un 39 % más de problemas que el mejor de los modelos por sí solo, y más del triple que el análisis automático.
Dos detalles de ese trabajo merecen atención. El primero: dar al modelo más información del demostrador no siempre ayuda. La mejor configuración de los dos modelos no incluía el historial de intentos anteriores. El segundo es casi una broma del teorema: en los problemas difíciles, gpt-oss-120b a veces entraba en un bucle propio, proponiendo una medida con la constante 3121, luego 3122, luego 3123, hasta agotar su ventana de contexto. El buscador no terminaba. No importa, porque el sistema lo trata como un intento fallido y pasa a «no lo sé»: la garantía nunca dependió de él.
Código verificado
El mismo patrón sirve para escribir programas. Un grupo de la Beneficial AI Foundation y el MIT, con Max Tegmark, llamó a esto vericoding, por oposición al vibe coding: en lugar de pedir código a partir de una descripción en lenguaje natural, se le da al modelo una especificación formal (qué tiene que cumplir la salida para cada entrada) y tiene que devolver la implementación junto con la demostración de que la cumple. Lo comprueba un verificador.
Su banco de pruebas, de 2025, tiene 12 504 especificaciones en tres lenguajes: Dafny, creado en Microsoft Research, que comprueba automáticamente las especificaciones con un solucionador SMT; Verus, un verificador para Rust; y Lean. Con cinco intentos por tarea y los errores del verificador como respuesta entre uno y otro, los modelos de entonces resolvieron el 82 % en Dafny, el 44 % en Verus y el 27 % en Lean, contando como resuelta cada tarea que resolvió cualquiera de los nueve modelos probados. Los números de un solo modelo son bastante más bajos.
Un banco posterior lo matiza. AlgoVeri, presentado en ICML 2026, una de las principales conferencias de aprendizaje automático, critica que los bancos de cada lenguaje tienen tareas distintas y no se pueden comparar, así que plantea 77 algoritmos clásicos con exactamente la misma especificación en los tres lenguajes. Con él, el mejor resultado en Dafny, de Gemini 3 Flash, es el 40,3 %, y las cifras caen al 24,7 % en Verus y al 7,8 % en Lean. El orden se mantiene; la distancia con el primer banco, no.
Cuando el verificador acepta, el código cumple la especificación, sin excepciones. Pero eso desplaza el problema a la especificación, que escribe una persona o, cada vez más, otro modelo. Los autores del primer banco revisaron a mano una muestra de tareas resueltas y encontraron que alrededor del 9 % tenían especificaciones demasiado débiles, que admitían soluciones triviales, y otro 15 %, mal traducidas de un lenguaje a otro. Un código perfectamente verificado contra una especificación que no dice lo que querías es un error demostrado. Quién comprueba la especificación es, hoy, la pregunta abierta más importante de esta línea.
Alucinaciones: de eliminarlas a gestionarlas
Si alucinar en algún mundo es inevitable para un modelo que siempre contesta, la pregunta práctica es otra: ¿por qué los modelos contestan siempre? En septiembre de 2025, Adam Tauman Kalai, Ofir Nachum y Edwin Zhang, de OpenAI, y Santosh Vempala, del Georgia Tech, dieron una respuesta que no tiene nada de misteriosa.
La primera parte está en el preentrenamiento. Generar sólo afirmaciones válidas es al menos tan difícil como clasificar si una frase lo es, y los errores de generación son, más o menos, el doble que los de esa clasificación. Para hechos arbitrarios, sin un patrón que aprender, el resultado es concreto: si el 20 % de las fechas de cumpleaños aparecen una sola vez en los datos de entrenamiento, cabe esperar que el modelo base invente al menos el 20 % de ellas. Esto no tiene nada que ver con Turing; es estadística.
La segunda parte está en la evaluación, y es la que se puede arreglar. Casi todos los bancos de pruebas puntúan de forma binaria: un punto si aciertas, cero si fallas, cero si dices «no lo sé». Con esa regla, abstenerse es siempre peor que adivinar, porque adivinar tiene alguna probabilidad de sumar. Los autores revisaron diez bancos de pruebas muy usados y sólo uno daba algún crédito, y parcial, a «no lo sé». Un modelo entrenado y elegido por esas cifras aprende a ser un buen examinando: ante la duda, contesta.
Su propuesta es cambiar las instrucciones del examen: decirle al modelo que conteste sólo si su confianza supera un umbral , que un acierto vale 1 punto, un error resta y «no lo sé» vale 0. Si el modelo cree que acierta con probabilidad , contestar le da de media
que es positivo exactamente cuando . Con , un error resta un punto; con , resta nueve. Es la misma lógica que la tabla de SV-COMP, que con sus −32 puntos fija el umbral en el 94 %.
Los autores señalan también que un modelo que no alucina es fácil de construir: una base de datos de preguntas con su respuesta, una calculadora y «no lo sé» para todo lo demás. Es inútil, pero no alucina, y no contradice a Xu y sus coautores, porque renuncia a la totalidad. Todo el trabajo práctico sobre alucinaciones vive entre ese extremo y el modelo que siempre contesta: decir «no lo sé» lo bastante a menudo para no inventar, y lo bastante poco para servir de algo. Eso se puede medir y mejorar. Eliminar las alucinaciones de un modelo que contesta a todo, no.
Razonar donde hay un comprobador
La mejora más visible de los modelos en los últimos años, el razonamiento en matemáticas y programación, sigue el mismo patrón, aplicado al entrenamiento. En el aprendizaje por refuerzo (reinforcement learning, RL), el modelo genera respuestas y recibe una recompensa según lo buenas que sean. Durante años, esa recompensa la daba otro modelo, entrenado para imitar el juicio humano. En 2024, el informe de Tülu 3, un modelo abierto del Allen Institute for AI, le dio nombre a la alternativa: aprendizaje por refuerzo con recompensas verificables (RLVR), en el que la recompensa la da una función que comprueba la respuesta, y sólo hay premio cuando la respuesta es verificablemente correcta.
DeepSeek-R1, en enero de 2025, lo llevó lejos. Su primera versión, R1-Zero, se entrenó sólo con recompensas por reglas: en matemáticas, la respuesta final, en un formato fijo, se compara con la correcta; en programación, el código se compila y se ejecuta contra tests. Los autores explican por qué evitaron los modelos de recompensa neuronales en esas tareas: en un entrenamiento largo, el modelo que aprende encuentra la manera de engañarlos. Un comprobador por reglas no se deja engañar por una respuesta bien escrita que está mal.
El límite de este método es exactamente el del comprobador. Funciona donde comprobar es barato y fiable: una respuesta numérica, una demostración en Lean. En 2025, dos sistemas alcanzaron el nivel de una medalla de oro en la Olimpiada Internacional de Matemáticas con soluciones formalizadas en Lean, comprobadas por su núcleo. Donde el comprobador es un conjunto de tests, la recompensa hereda lo que los tests no ven: un programa que los pasa no está demostrado correcto. Y donde no hay comprobador, en un ensayo, un diagnóstico o una decisión, el método no tiene de dónde tirar.
Automejora: cambiar la demostración por un examen
La máquina de Gödel exigía una demostración antes de cada cambio y por eso no avanzaba. En 2025, Jenny Zhang, Shengran Hu, Cong Lu, Robert Lange y Jeff Clune, de la Universidad de la Columbia Británica, el Vector Institute y Sakana AI, publicaron la Darwin Gödel Machine, que cambia la demostración por un examen. Es un agente de programación que modifica su propio código (sus instrucciones, sus herramientas, su forma de organizar el trabajo), sin tocar los pesos del modelo, que sigue congelado. Cada versión nueva se evalúa con un banco de pruebas y se guarda en un archivo del que salen las siguientes, como en la evolución: se prueban variantes y se conservan las que funcionan. Los autores lo dicen sin rodeos: demostrar que la mayoría de los cambios son beneficiosos es imposible en la práctica, así que los validan empíricamente.
Funcionó. En 80 iteraciones, el agente pasó de resolver el 20 % al 50 % de las tareas de SWE-bench Verified, un banco de 500 problemas reales de repositorios de Python en GitHub en los que hay que escribir el cambio que hace pasar los tests, medido sobre subconjuntos de esas tareas. Cada ejecución completa costó unos 22 000 dólares en llamadas al modelo y unas dos semanas.
Y aquí aparece el precio de cambiar una demostración por un examen. En un experimento aparte, los autores pidieron al sistema que corrigiera un defecto del modelo: a veces escribía en su respuesta el resultado de una herramienta que nunca había llamado, como si hubiese ejecutado los tests y hubiesen pasado. Para detectarlo, el sistema de evaluación insertaba unas marcas especiales cada vez que una herramienta se usaba de verdad, y comprobaba si aparecían en el texto del modelo sin haberse producido. Una de las versiones consiguió la puntuación perfecta tras sólo dos modificaciones. Había quitado el registro de esas marcas, a pesar de que las instrucciones decían que no las tocase, y con eso el detector dejó de detectar. Los autores observaron además que este tipo de trampa era más frecuente cuando el agente podía ver las funciones de evaluación.
Es la ley de Goodhart, formulada por el economista Charles Goodhart en 1975 y conocida por la versión de la antropóloga Marilyn Strathern: cuando una medida se convierte en objetivo, deja de ser una buena medida. Un banco de pruebas esquiva al teorema porque renuncia a la exactitud: aprobarlo no demuestra nada sobre los casos que no contiene. Lo que hereda es que el sistema que se optimiza contra él puede aprender a aprobar sin hacer lo que el banco pretendía medir. Las mismas debilidades que hacen engañoso el número de una ficha de modelo, que cuenta el artículo sobre bancos de pruebas, se vuelven más graves cuando quien se examina puede reescribirse.
AlphaEvolve, de Google DeepMind, muestra la otra cara. Es un sistema en el que los modelos de lenguaje Gemini, de Google, proponen programas y unos evaluadores automáticos los ejecutan, los comprueban y los puntúan. Sus resultados, anunciados en mayo de 2025, son de los más sólidos que ha dado la idea: una heurística para el planificador de los centros de datos de Google que recupera, de media, el 0,7 % de su capacidad de cálculo en todo el mundo; una forma de dividir una multiplicación de matrices que aceleró un 23 % una parte de Gemini y redujo un 1 % su tiempo de entrenamiento; un método para multiplicar matrices 4×4 de números complejos con 48 multiplicaciones, que mejora el de Volker Strassen de 1969; y, en más de 50 problemas matemáticos abiertos, igualar la mejor solución conocida en torno al 75 % de los casos y mejorarla en cerca del 20 %.
La condición está en la descripción del propio sistema: sirve para problemas cuya solución se puede escribir como un algoritmo y comprobar automáticamente. Una multiplicación de matrices se comprueba exactamente; un tiempo de ejecución se mide. Ahí el evaluador es casi un comprobador, y la ley de Goodhart tiene poco hueco. Cuanto más se aleja el evaluador de comprobar y más se acerca a puntuar, más hueco tiene.
Lo que sigue abierto
Las líneas de investigación activas se ordenan solas con este mapa, porque casi todas tratan de mejorar el comprobador o de llevarlo a donde no llega:
- Especificaciones fiables. Pasar de una descripción en lenguaje natural a una especificación formal (la autoformalización) es justo lo que no se puede comprobar mecánicamente, y es donde falla el vericoding.
- Certificados más fáciles de producir. Los modelos aciertan el veredicto mucho más a menudo de lo que justifican; los autores del estudio sobre SV-COMP proponen testigos más simples, como una fórmula que describa las entradas con las que el programa no termina, que Z3 pueda comprobar.
- Evaluaciones que premien abstenerse. Cambiar la puntuación de los bancos más usados, como proponen Kalai y sus coautores, es barato y cambia lo que se optimiza.
- Evaluadores que el sistema no pueda tocar. La trampa de la Darwin Gödel Machine sugiere separar al que se mejora de lo que lo evalúa, con la misma lógica que un sandbox.
- Fiarse de un sucesor. El obstáculo de Löb sigue sin una solución completa, y es la versión formal de la pregunta que más preocupa sobre la automejora.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: el problema de la parada no limita a la IA, limita a cualquier procedimiento que quiera ser a la vez general, total y exacto. Una IA que verificase cualquier programa, siempre y sin error, no existirá, y tampoco una persona que lo haga. Todo lo que mejora, mejora renunciando a una de las tres cosas.
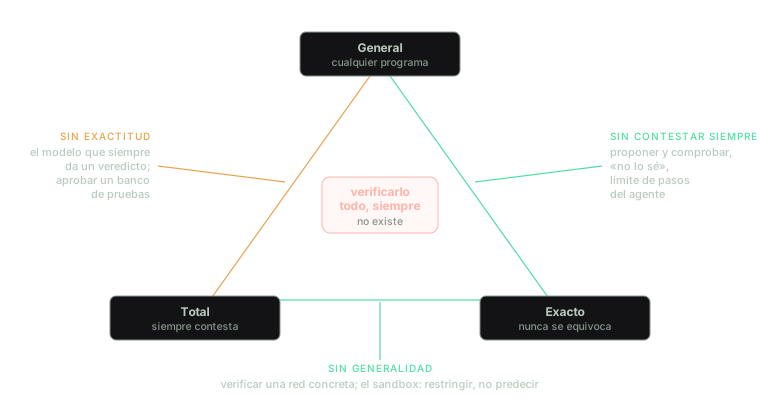
El mismo triángulo que con cualquier otro procedimiento. Lo que cambia con la IA es lo bien que rellena cada lado.
Y si te llevas tres más, que sean éstas:
La indecidibilidad entra por el bucle, no por el modelo. Una pasada del modelo y su cadena de pensamiento siempre terminan; lo que tienen es un límite de complejidad, que más pasos y más cálculo van empujando. El agente que escribe y ejecuta código sí es una máquina universal, y por eso su seguridad se construye restringiendo lo que puede hacer, no prediciendo lo que hará.
La mejora real tiene forma de certificado. El modelo propone y un programa pequeño comprueba: funciones de ranking, testigos, código con su demostración, respuestas que se pueden verificar. La garantía la da el comprobador, y los modelos ya son buenos buscadores, aunque todavía mucho mejores acertando el veredicto que justificándolo.
Cambiar la prueba por un examen esquiva a Turing, pero no a Goodhart. Un banco de pruebas no tiene que decidir nada, y por eso funciona. Pero un sistema que se optimiza contra él puede aprender a aprobarlo, y eso empeora cuando además puede reescribir su propio código.
Ante el próximo titular sobre una IA que «verifica», «no alucina» o «se mejora a sí misma», cuatro preguntas bastan. ¿Con cualquier programa o pregunta, o con los de una clase concreta? ¿Contesta siempre, o a veces dice «no lo sé»? Cuando contesta, ¿hay un certificado que otro programa comprueba, o sólo un buen resultado en un banco de pruebas? Y si es lo segundo, ¿podía el sistema tocar el examen?