Varias cabezas, varios repartos
35 min read
La lección anterior dejó dos cosas abiertas. Una capa de auto-atención le da a cada posición una sola fila de , fabricada por un único par de matrices, y ; y entra en la fórmula sin que nada diga cuánto debería valer.
Mira la frase el ratón pequeño que persiguen los gatos duerme. duerme tiene que encontrar a su sujeto, ratón, y no le basta un criterio: «¿es un sustantivo?» no distingue ratón de gatos, y «¿concuerda conmigo en número?» no distingue un sujeto de un determinante. Llamaré regla a cada criterio de ésos. La fila de duerme necesita las dos a la vez, y las combina sumándolas: cada regla le da a cada palabra una puntuación, el producto escalar las suma y el softmax reparte la fila según el total. Gana la palabra que cumple las dos.
Sumar sirve cuando se busca una sola palabra que cumpla todas las reglas, pero una posición puede necesitar dos palabras distintas. persiguen necesita a quien persigue, gatos, y a quien es perseguido, ratón, y su fila es un único reparto que suma : o se queda con una y pierde la otra, o mezcla las dos. Además, una vez sumadas, las reglas ya no se pueden separar: la fila no dice cuánto puso cada una.
La alternativa es no sumar antes de repartir: separar las reglas en grupos, cada uno con su propia atención y su propio softmax, y juntar después lo que lee cada uno. Cada una de esas atenciones es una cabeza, y la capa que monta varias es la atención multi-head, de la que trata esta lección.
El explorable de abajo pone una sola regla en cada cabeza: la 1 es la del sustantivo, la 2 la concordancia, y la 3 y la 4 relacionan sustantivos con sus determinantes y modificadores. El quinto botón no junta las cabezas: es la capa de la lección sobre la auto-atención, con las cuatro reglas sumadas antes de un único softmax. La fila es quien pregunta y la columna quien contesta, y el panel de debajo resume, para la fila que elijas, a qué palabra tira cada mapa.
En la fila de duerme, la cabeza 1 empata ratón con gatos, a cada uno; la 2 prefiere tres singulares que no son el sujeto, a ; y la 3 y la 4 no dicen nada. Ninguna cabeza encuentra el sujeto, porque las dos reglas que hacían falta han ido a cabezas distintas. La suma sí lo encuentra, ratón con , pero a cambio borra lo que dijo cada regla.
En la fila de persiguen, que necesitaba a gatos y a ratón, la suma se queda con gatos, con , y a ratón le deja . La cabeza 1, en cambio, le sigue dando , así que con varias cabezas lo que se lee de ratón llega a la salida. Esa cabeza no sabe que ratón es el perseguido, porque ninguna de estas reglas busca objetos y ella lee los dos sustantivos por igual; lo que la separación evita es que la suma lo borre. Por eso una cabeza de verdad lleva varias reglas: dentro de ella se suman las que tienen que cumplirse a la vez, y en cabezas distintas pueden acabar las que buscan cosas distintas.
La misma matriz leída por varias atenciones a la vez
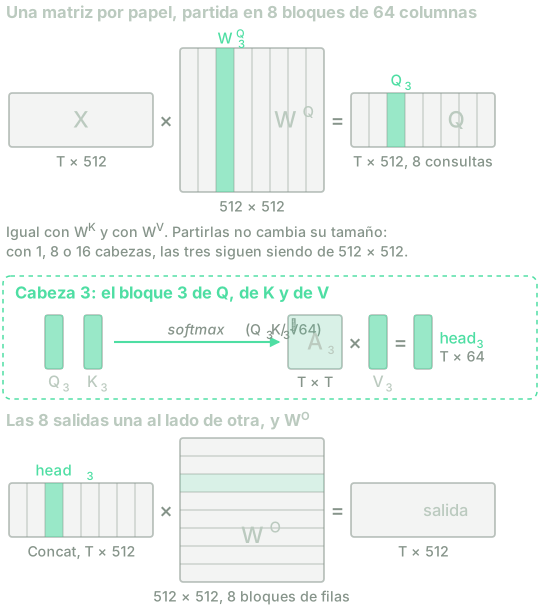
Cada cabeza es la capa de la lección sobre la auto-atención, entera: sus tres proyecciones sobre la misma matriz y su propio mapa. Lo único que hay que añadir es el subíndice que allí no hizo falta escribir porque sólo había una.
con , y con y . Fíjate en que las leen la misma : no se reparten la frase, ni se reparten las coordenadas de entrada. Cada una saca de ella sus propias consultas (queries), claves (keys) y valores (values), y con ellas su propio mapa , cuadrado y con las filas sumando igual que el de la lección sobre la auto-atención.
Quedan entonces salidas de y la capa tiene que devolver una. Se ponen una al lado de otra y se proyectan:
donde pega las matrices por columnas (una fila por posición, con los trozos seguidos dentro de ella, de modo que el resultado es ), y es la única matriz de la capa que no pertenece a ninguna cabeza. Su superíndice es una etiqueta de papel, como los de las otras tres.
Sumar antes o después del softmax
La puntuación de una cabeza ya era una suma, y la lección anterior la escribió así precisamente para poder contarla:
donde es la coordenada de la consulta de la posición . Cada coordenada de la comparación aporta su término, y el softmax no ve los términos: ve el total.
Las reglas de la introducción son esos términos. El explorable de arriba está hecho así a propósito: cada regla es una columna de y otra de , de modo que la coordenada de la consulta por la coordenada de la clave es la puntuación de la regla . La capa de una sola cabeza lleva las cuatro columnas, así que compara en coordenadas (y divide su suma entre ); cada una de las cuatro cabezas se queda con una sola columna, , y su puntuación es una regla y nada más. En una capa entrenada nadie escribe las reglas y una coordenada no tiene por qué significar nada por sí sola, pero la cuenta es la misma: términos que llegan sumados al softmax.
Sumar dentro del softmax tiene una consecuencia que cabe en una línea. Si y son lo que dos reglas le dan a la palabra , la exponencial convierte su suma en un producto:
Repartir el total es multiplicar, palabra a palabra, lo que pondría cada regla por su cuenta, y reescalar para que la fila vuelva a sumar . Un producto funciona como un «y»: si una regla puntúa bajo a una palabra, ésta se queda sin peso, diga lo que diga la otra. Es lo que le pasa a ratón en la fila de persiguen: la concordancia lo hunde, porque no coincide en número, y la regla del sustantivo, que lo puntuaba igual que a gatos, no puede sacarlo de ahí. Y como lo que sale es un solo reparto, ya no se puede saber cuánto puso cada regla.
Ahí está la operación entera. Separar las coordenadas en grupos y darle a cada grupo su propio softmax es repartir antes de combinar, en vez de combinar antes de repartir. Salen distribuciones en lugar de una, cada una con su denominador, y llegan hasta la salida sin tocarse; lo que las combina es , que es una matriz que se aprende y que las recibe ya repartidas. La suma que la capa de una cabeza hacía dentro del softmax era irreversible; hecha fuera, todavía se puede decidir cuánto pesa cada parte.
El reparto de la anchura
Queda elegir , que era la otra pregunta abierta, y se elige contando. Cada cabeza cuesta lo que costaba la capa entera de la lección sobre la auto-atención:
hay de ellas, y encima está con más, de modo que la capa completa pide
Asigna ahora a y a el valor (repartir la anchura del modelo entre las cabezas, en vez de darle a cada una la anchura entera) y mira lo que ocurre:
La se ha ido. Ocho cabezas cuestan lo mismo que una, y dieciséis lo mismo que ocho. Las multiplicaciones se comportan igual: la lección sobre el adiós a la recurrencia midió una atención en , y de ellas dan , que es exactamente lo que costaba una sola de anchura .
De modo que se elige por lo que hace y no por lo que cuesta, y deja de ser un número suelto: es lo que queda de al partirlo. Con las cifras del artículo, y , sale (el número con el que la lección anterior hizo sus cuentas) y la capa entera pesa parámetros.
Lo que se paga conviene decirlo, porque no es cero. Cada cabeza compara en coordenadas donde una sola habría comparado en : no son ocho comparaciones tan finas como la que había, son ocho comparaciones ocho veces más estrechas. El trato es ése, y es una apuesta sobre el lenguaje (que compensan varias relaciones gruesas frente a una sola muy fina) y no un teorema.
Concatenar y proyectar, no promediar
La alternativa evidente a concatenar es promediar: dale a cada cabeza la anchura entera, , y devuelve , que ya tiene la forma correcta sin necesidad de ninguna matriz más. Merece la pena verla como lo que es, un caso particular de lo que la capa ya hace. Toma la que apila copias de :
Concatenar con una que se aprende puede, entonces, dar el promedio y cualquier otra cosa; promediar es fijar de antemano un punto de todo eso. Y fijarlo cuesta algo muy concreto: obliga a las cabezas a escribir en las mismas coordenadas, de manera que dos cabezas que han encontrado dos cosas distintas pueden cancelarse antes de que nadie las lea. Concatenadas, cada una tiene sus coordenadas para ella sola, y decide después, coordenada de salida por coordenada de salida, a cuál hace caso.
Esa matriz hace además una segunda cosa que aquí sólo queda señalada: devuelve la salida a , la anchura con la que entró. Eso es lo que permite apilar estas capas una sobre otra, y quien lo necesita de verdad es una lección más adelante, sobre el bloque completo con residuales y layer norm.
Falta decir lo que esta construcción no hace, porque los dibujos de los artículos invitan a creer lo contrario. Nada en la pérdida le asigna un papel a una cabeza: no existe ningún término que diga «la cabeza 2 se ocupa de la concordancia». Las cabezas hacen cosas distintas porque empiezan distintas, y por nada más. Los nombres del explorable de arriba se los he puesto yo, escribiendo las cuatro reglas a mano; en una capa entrenada no los pone nadie y hay que salir a buscarlos después, cuando están. Ni siquiera el orden significa nada: intercambia dos cabezas junto con sus dos bloques de filas de y no cambia un número de la salida, así que «la cabeza 3» no nombra lo mismo en dos entrenamientos del mismo modelo.
Las cabezas en NumPy
La primera celda monta la capa con las proyecciones enteras y un bloque de columnas por cabeza, que es como se implementa de verdad, y después pasa la cuenta de parámetros por cinco valores de .
T, d_model, h = 6, 8, 4
d_k = d_v = d_model // h
rng = np.random.default_rng(5)
X = rng.normal(size=(T, d_model))
Wq = rng.normal(size=(d_model, d_model)) * 0.6 # las h cabezas, una al lado de otra
Wk = rng.normal(size=(d_model, d_model)) * 0.6
Wv = rng.normal(size=(d_model, d_model)) * 0.6
Wo = rng.normal(size=(h * d_v, d_model)) * 0.6
def softmax_filas(E):
Z = np.exp(E - E.max(axis=1, keepdims=True))
return Z / Z.sum(axis=1, keepdims=True)
salidas, mapas = [], []
for i in range(h):
col = slice(i * d_k, (i + 1) * d_k) # el bloque de columnas de la cabeza i
Q, K, V = X @ Wq[:, col], X @ Wk[:, col], X @ Wv[:, col]
A = softmax_filas(Q @ K.T / np.sqrt(d_k))
salidas.append(A @ V)
mapas.append(A)
concat = np.concatenate(salidas, axis=1) # (T, h*d_v): los h trozos seguidos
Y = concat @ Wo
print("una cabeza", salidas[0].shape, " concatenadas", concat.shape, " salida", Y.shape)
print("mapas:", len(mapas), "de", mapas[0].shape,
" cada fila suma 1:", bool(np.allclose([A.sum(axis=1) for A in mapas], 1.0)))
print("fila 0 de la cabeza 1:", np.round(mapas[0][0], 3))
print("fila 0 de la cabeza 2:", np.round(mapas[1][0], 3))
d = 512 # la anchura del articulo
print("\n h d_k proyecciones W^O total")
for hh in (1, 2, 4, 8, 16):
dk = d // hh
proy, sal = hh * d * 3 * dk, hh * dk * d
print(f"{hh:3d} {dk:4d} {proy:12d} {sal:8d} {proy + sal:9d}")
The first run downloads the Python interpreter (~15 MB). After that it stays in the browser cache and is reused across every lesson.
Las dos filas impresas son la misma posición vista por dos cabezas, y no se parecen en nada: la
primera pone sobre la posición y la segunda sobre la , con la que la primera
gastaba . Aquí las cabezas se han separado sólo porque rng les dio matrices distintas, que
es todo lo que las separa también en un modelo entrenado. Y la tabla es la cancelación de arriba
comprobada: las tres columnas de la derecha no se mueven de , y
mientras baja de a .
La segunda celda mide la concesión. Si las cabezas empiezan con los mismos parámetros, no hay cabezas.
T, d_model, h = 6, 8, 4
d_k = d_model // h
rng = np.random.default_rng(5)
X = rng.normal(size=(T, d_model))
def softmax_filas(E):
Z = np.exp(E - E.max(axis=1, keepdims=True))
return Z / Z.sum(axis=1, keepdims=True)
def mapas(Wq, Wk):
salida = []
for i in range(h):
col = slice(i * d_k, (i + 1) * d_k)
Q, K = X @ Wq[:, col], X @ Wk[:, col]
salida.append(softmax_filas(Q @ K.T / np.sqrt(d_k)))
return np.stack(salida) # (h, T, T)
bloque = rng.normal(size=(d_model, d_k)) * 0.6
iguales = np.tile(bloque, (1, h)) # las h cabezas, con las mismas matrices
A = mapas(iguales, iguales)
print("h mapas identicos:", bool(np.allclose(A, A[0])))
print("mayor diferencia con la cabeza 1:", np.abs(A - A[0]).max(axis=(1, 2)))
distintas = iguales.copy()
distintas[:, :d_k] += 0.4 * rng.normal(size=(d_model, d_k)) # solo la cabeza 1
B = mapas(distintas, distintas)
print("tras mover solo la cabeza 1:")
print(" lo que dista cada una de la cabeza 1:", np.round(np.abs(B - B[0]).max(axis=(1, 2)), 3))
print(" y lo que dista cada una de la cabeza 2:", np.round(np.abs(B - B[1]).max(axis=(1, 2)), 3))
print("fila 0, cabeza 1:", np.round(B[0][0], 3))
print("fila 0, cabeza 2:", np.round(B[1][0], 3))
The first run downloads the Python interpreter (~15 MB). After that it stays in the browser cache and is reused across every lesson.
Con los cuatro bloques de columnas iguales las cuatro distancias salen exactamente : los cuatro mapas son el mismo, y recibe cuatro copias de un mismo vector por posición. Mover un solo bloque separa a esa cabeza de las otras tres ( en las tres casillas de la primera línea) y deja a esas tres idénticas entre ellas, que es lo que dicen los tres ceros de la segunda. La asimetría no aparece sola: entra por la inicialización, y en un entrenamiento se mantiene porque las cabezas y los bloques de filas de empiezan todos distintos. Con todo simétrico, el gradiente no tendría por dónde romperlo.
Comprueba tu intuición
Cinco preguntas: qué separa a cabezas de una sola, cuánto pesa la capa, de dónde sale , qué calcula la capa con las cabezas iguales, y si promediar era una opción.
Una capa tiene una cabeza con . Otra tiene cuatro cabezas de , y sus columnas son exactamente las cuatro de la primera. ¿En qué se diferencian?
Una capa multi-head con y , repartiendo la anchura como manda el artículo (). ¿Cuántos parámetros tiene en total, contando ?
A margin of ±0 is accepted.
¿Por qué y no cualquier otra anchura?
Inicializas las cabezas con exactamente las mismas , y . Marca lo que es cierto de la capa en ese momento.
Select every correct option. This is graded all-or-nothing: there is no partial credit.
Promediar las cabezas es algo que la concatenación seguida de no puede hacer.
Escribe multi_head(X, Wq, Wk, Wv, Wo, h). Recibe la frase ya vectorizada, X de forma
; las tres proyecciones enteras, Wq, Wk y Wv, las tres de
forma ; la proyección de salida Wo, de la misma
forma; y el número de cabezas h, que divide a .
La cabeza se queda con el bloque de columnas -ésimo de cada proyección (de
i * d_k a (i + 1) * d_k, con d_k = d_v = d_model // h) y hace con él la atención de
siempre, dividiendo entre .
Devuelve la pareja (salida, A), en ese orden: la salida de forma
, con las cabezas concatenadas por columnas y proyectadas por
Wo; y los mapas apilados, A de forma , cada fila de cada uno sumando .
No escribas en los arrays que recibes.
The first run downloads the Python interpreter (~15 MB); after that it stays in the browser cache. This challenge is much easier to solve on a physical keyboard: on a phone, read it and come back later.
Con cabezas, una posición tiene respuestas donde tenía una, y decide qué hacer con ellas. Pero mira de dónde salen las : de la misma , con la misma fórmula, y en siguen sin aparecer ni por ningún sitio. Multiplicar las cabezas multiplica qué se compara, y no añade ni una coordenada de dónde. Ninguna de las puede aprender «el sustantivo que tengo a la izquierda», por muchas que pongas, porque en lo que la capa lee no hay izquierda.
La pieza que falta no está en la capa: está en la entrada, y consiste en que dos posiciones distintas le lleguen a como dos filas distintas aunque el token sea el mismo. Eso es la lección siguiente, sobre la codificación posicional, y lo que la hace interesante no es que haga falta (eso ya se sabía desde la primera lección de este bloque), sino la forma concreta que elige el artículo: unos senos y unos cosenos con los que la distancia entre dos posiciones se puede escribir como una operación lineal sobre lo que se ha añadido. Esa propiedad se enseña, no se afirma, y ocupa la lección entera.
Further reading1 source · 1 paper
Where this lesson comes from, and where to go next. None of it is needed to carry on with the course.
- Attention Is All You Need
Su §3.2.2 trae la concatenación con W^O y el reparto d_k = d_model/h, y afirma en una línea que h cabezas cuestan como una. Esa cancelación la desarrollas tú, y el marco «sumar antes o después del softmax» no está en el artículo.