La raíz que faltaba en la atención
28 min de lectura
La auto-atención quedó montada del todo salvo por un símbolo. Las tres proyecciones , y tienen su argumento, la matriz de pesos es cuadrada () porque la frase se mira a sí misma, y el softmax por filas reparte una unidad entre las posiciones de cada fila. Pero la del denominador se escribió en la fórmula sin explicar por qué está ahí, y sigue sin explicación. Es el único préstamo que sigue abierto, y esta lección lo salda.
La pregunta tiene más filo del que parece. ¿Por qué una raíz, y no el propio ? ¿Y por qué de , y no de o de la longitud de la frase? Las dos se contestan de una vez, porque las dos dependen de averiguar cuánto se aleja del cero una suma cuando se le van añadiendo sumandos. Para hacerlo no hace falta teoría de la probabilidad compleja, sólo promediar, y la cuenta empieza promediando sobre una lista finita que se puede recorrer entera.
Toma la versión más cruda posible de una consulta (query) y una clave (key), es decir, de una fila de y una fila de : todas sus coordenadas valen o . La puntuación es entonces una cuenta de coincidencias, porque cada término aporta si las dos coordenadas comparten signo y si no. Con cuatro coordenadas, tres coincidencias y una discrepancia dan . Con cuatrocientas, la misma proporción (trescientas contra cien) da .
Y ahí está lo que hay que ver, que no es que los términos se hayan hecho mayores: siguen valiendo . Es que hay cien veces más. Una desviación pequeña respecto de la mitad exacta, repetida sobre más sumandos, se convierte en un número grande, y ese número se lo va a comer una exponencial.
Con signos al azar la proporción no se queda fija en tres contra uno, y la puntuación crece menos: su tamaño típico va con , como deduce la sección siguiente. La figura pone una misma fila de seis puntuaciones a ese tamaño en tres anchuras y prueba tres divisores antes del softmax: (es decir, no dividir), y el propio . Cada grupo de barras es el reparto de la fila, un peso por posición, y el número de encima es lo que se lleva la posición que gana. Busca la fila que no cambia de una columna a otra.
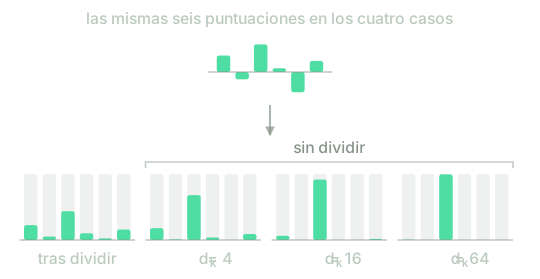
Una puntuación crece con la raíz de la anchura
Cada casilla de es el producto escalar de una fila de (la consulta de una posición) con una fila de (la clave de otra). Las dos viven en , y las escribo y sin índice de posición porque la cuenta es la misma para cualquier pareja. La puntuación es:
una suma de términos. De qué tamaño sale depende de qué tamaño entra, así que fijemos primero el caso exacto: las coordenadas valen o , como en la cuenta de coincidencias de arriba. Llamemos al término -ésimo, que vale entonces o , y .
Elevar al cuadrado separa la diagonal del resto:
porque sea cual sea el signo. El primer sumando ya no depende de nada. El segundo es el que hay que promediar, y promediar aquí quiere decir algo perfectamente finito: recorrer las combinaciones de signos que puede tomar , con fija, y hacer la media. La escribiremos , la media de una cantidad sobre el azar que se le supone. Los términos cruzados se van todos.
Ver por qué cada término cruzado promedia cero
Fija dos índices distintos y mira el término . Empareja cada combinación de signos con la que resulta de cambiarle el signo a y dejar las otras coordenadas donde están. Es un emparejamiento perfecto de las combinaciones en parejas: cada combinación tiene exactamente una compañera, y no es ella misma.
Dentro de una pareja, , y no se han movido y ha cambiado de signo, de modo que los dos valores de son opuestos y suman cero. Sumar cero veces y dividir entre deja
El mismo emparejamiento da : en cada sumando cambia de signo junto con su propia coordenada, así que cada uno promedia cero por separado.
De modo que del cuadrado sobrevive el primer sumando y nada más:
Con , eso es cuanto hace falta. La puntuación se reparte alrededor del cero, y lo que mide su alejamiento típico (la desviación típica) es la raíz de ese promedio:
que es la respuesta a la mitad de la pregunta. Dividir entre deja , y en ese no aparece : la misma escala con consultas de ocho coordenadas y con consultas de mil.
Con el divisor puesto, la operación entera (producto, división, softmax y mezcla) pasa a tener nombre propio: es el producto interno escalado, que es como el artículo escribe scaled dot-product. El producto interno es el producto escalar de siempre, el de la línea de arriba; lo escalado es esta división y nada más.
Los signos estaban ahí para que la cuenta fuese exacta, pero fíjate en qué propiedades le hicieron
falta de verdad. Dos: que y que
. Cualquier inicialización centrada cuyas coordenadas sean independientes y de tamaño típico las
cumple, y con ellas la misma cancelación deja el mismo . Las
gaussianas de rng.normal que el curso lleva usando desde la lección
sobre implementar el MLP (multilayer perceptron) son una de esas inicializaciones, y la
primera celda lo mide con ellas.
Conviene decir en voz alta de qué habla esa hipótesis, porque no habla del modelo que te encontrarás. Habla de una red recién inicializada: nada garantiza que después de miles de pasos las coordenadas de sigan siendo independientes ni midiendo . Por eso el divisor se fija al diseñar la capa y no se mide sobre la marcha: arregla el arranque, que es donde el problema detiene el entrenamiento antes de que llegue a empezar.
Queda la parte que suele darse por sabida: por qué la raíz y no . El divisor tiene que quitarle a la puntuación exactamente lo que la anchura le puso, y lo que le puso es un factor . Dividir entre dejaría las puntuaciones en un tamaño típico de , cada vez más cerca del cero cuanto más ancho el modelo; y unas puntuaciones que tienden a cero dan un softmax que tiende al reparto uniforme, en cada casilla, con lo que la fila deja de elegir nada. Son dos fallos, uno a cada lado, y la raíz es el único exponente que no cae en ninguno.
Una fila cerrada no devuelve gradiente
Si las puntuaciones miden , las diferencias entre las de una misma fila miden eso también, y lo que el softmax mira son las diferencias:
con recorriendo las posiciones de la fila . Dos puntuaciones separadas por (una distancia corriente cuando el tamaño típico es , que es lo que da ) quedan a un factor la una de la otra, y con eso el reparto se ha terminado: una posición se lleva casi la unidad entera.
Que una fila elija fuerte no suena a defecto. El defecto está en la derivada.
Deriva respecto de las puntuaciones de su propia fila. Es la misma cuenta que la lección sobre las funciones de pérdida hizo con el softmax de la capa de salida, y salen los mismos dos casos según el índice coincida o no:
Pon ahora la fila cerrada, con un peso en casi y el resto en casi . El caso de la diagonal da por ; el cruzado, en cualquier casilla, arrastra al menos un factor casi nulo. Las dos derivadas se apagan a la vez, y con ellas la fila entera.
Lo que eso cuesta se ve mirando qué hay antes de las puntuaciones. Sólo y : las puntuaciones salen de y no entra nada más. Si el gradiente no atraviesa el softmax, esas dos matrices no reciben nada por esa fila, y son precisamente las que tendrían que aprender a quién debe mirar cada posición. La capa sigue calculando (una salida saturada es una salida perfectamente definida); lo que ha dejado de poder es cambiar de opinión.
Merece la pena pararse en por qué el bloque 2 no se topó con esto, porque la diferencia es de una línea. Allí el softmax iba seguido de la entropía cruzada, y el de la pérdida aporta el factor inverso exacto: las dos juntas dieron , que vale en la clase correcta y no se anula por muy segura que esté la red. Aquí detrás del softmax no hay ningún logaritmo, sólo la multiplicación por , la matriz de valores (values). La jacobiana no se cancela contra nada: se queda entera, ceros incluidos.
Y así reaparecen dos cosas que el curso dio por cerradas en bloques distintos. La curva es la misma que la derivada de la sigmoide, con su máximo de en la mitad y sus dos colas planas: la saturación de la lección sobre las funciones de activación, en una capa donde no hay ninguna sigmoide. Y un gradiente que llega apagado a las matrices que tenían que aprender es el bloque 3 entero, en una arquitectura sin una sola recurrencia. Lo que las une no era la sigmoide ni el estado recurrente: era que en las dos había una función aplanándose.
Una fila entera se resume en un número, y sale de sumar el caso de la diagonal sobre las posiciones:
donde la última igualdad usa que la fila suma . Con la fila repartida por igual vale ; con la fila entera en una posición vale . Es la suma de la diagonal de la jacobiana, y mide lo mismo por los dos lados: cuánto reparte esa fila, y cuánto le queda por aprender.
El divisor, medido en NumPy
La primera celda saca la cuenta del caso de los signos y la comprueba donde de verdad se aplica: coordenadas gaussianas, cinco anchuras, la columna del promedio medido contra la columna de .
rng = np.random.default_rng(7)
N = 8000 # parejas de vectores por cada anchura
print(" d_k media tamano tipico raiz(d_k) tras dividir")
for d_k in (4, 16, 64, 256, 1024):
Q = rng.normal(size=(N, d_k)) # coordenadas centradas, de tamano tipico 1
K = rng.normal(size=(N, d_k))
e = np.sum(Q * K, axis=1) # una puntuacion por pareja
tipico = np.sqrt(np.mean(e ** 2))
print(f"{d_k:5d} {e.mean():7.3f} {tipico:13.2f} {np.sqrt(d_k):9.2f} {tipico / np.sqrt(d_k):12.2f}")
La primera ejecución descarga el intérprete de Python (~15 MB). Después queda en la caché del navegador y se reutiliza en todas las lecciones.
Las dos columnas centrales coinciden hasta donde llega la precisión de medir con ocho mil parejas, y la de la derecha se queda clavada en : dividir deja el tamaño donde estaba, sea cual sea la anchura. La columna de la media es pequeña frente al tamaño típico de su fila (a , contra ), que es lo que dice cuando se mide en vez de demostrarse.
La segunda celda pasa de las puntuaciones a lo que sale de ellas. Mira sobre todo la última columna, que es la que decide si la capa puede aprender.
rng = np.random.default_rng(11)
T, N = 8, 4000 # 8 posiciones por fila, 4000 filas medidas
def softmax_filas(E):
Z = np.exp(E - E.max(axis=1, keepdims=True))
return Z / Z.sum(axis=1, keepdims=True)
print(f"{'':<11} {'d_k':>5} {'peso mayor':>10} {'reparto':>7} {'mayor a(1-a)':>12}")
for d_k in (8, 64, 512):
Q = rng.normal(size=(N, d_k)) # N consultas contra las mismas T claves
K = rng.normal(size=(T, d_k))
E = Q @ K.T
for nombre, Esc in (("sin dividir", E), ("dividiendo", E / np.sqrt(d_k))):
A = softmax_filas(Esc)
print(f"{nombre:<11} {d_k:5d} {A.max(axis=1).mean():10.3f} "
f"{(1 - (A ** 2).sum(axis=1)).mean():7.3f} {(A * (1 - A)).max(axis=1).mean():12.4f}")
La primera ejecución descarga el intérprete de Python (~15 MB). Después queda en la caché del navegador y se reutiliza en todas las lecciones.
Léela por parejas de líneas. Sin dividir, el peso mayor sube de a y el reparto se hunde de a (el máximo posible con ocho posiciones es ), mientras la mayor casilla de la diagonal de la jacobiana cae de a : más de cinco veces menos gradiente por el mero hecho de haber ensanchado el modelo. Dividiendo, las tres columnas dejan de moverse: de peso mayor, de reparto y de derivada en las tres anchuras, incluida la de . Ésa es la propiedad que se compra con el divisor, y no es que los números sean mejores, es que dejan de depender de .
Comprueba tu intuición
Cinco preguntas: cuánto mide una puntuación, por qué la raíz y no otra cosa, qué pierde una fila cerrada, por qué el bloque 2 se libró de esto y qué es lo que dividir no toca.
Las filas de y de de una capa tienen coordenadas, centradas e independientes, de tamaño típico . Sin dividir, ¿cuánto mide típicamente una puntuación ?
Se acepta un margen de ±0.
¿Por qué el divisor es y no ?
Una fila del mapa se ha ido casi entera a una posición: y las demás . Marca lo que es cierto.
Marca todas las opciones correctas. Se corrige todo o nada: no hay puntuación parcial.
El bloque 2 también puso un softmax en la red y nunca habló de que saturase. ¿Por qué no le pasaba esto?
Dividir las puntuaciones de una fila entre puede cambiar cuál de las posiciones se lleva el peso mayor.
Escribe gradiente_puntuaciones(A, G), la vuelta del softmax por filas. Recibe el mapa de
pesos ya normalizado, A de forma con cada fila sumando , y el gradiente que
baja desde arriba, G de la misma forma, con .
Devuelve , de forma .
Los dos casos de la derivada están desarrollados arriba; encadenados dan, casilla a casilla, , donde recorre la fila .
Escríbelo con operaciones sobre arrays (sin recorrer las casillas una a una y sin construir ninguna jacobiana) y no escribas en los arrays que recibes.
La primera comprobación descarga el intérprete de Python (~15 MB); después queda en la caché del navegador. Este desafío se resuelve mejor con un teclado físico: en el móvil puedes leerlo y volver luego.
Con el divisor puesto, la escala de las puntuaciones deja de depender de la anchura, y el reparto y el gradiente dejan de depender de ella con la misma cuenta. Pero mira lo que el divisor da por hecho: recibe ya decidido. Nada de lo que hemos contado dice cuánto debería medir una consulta (sólo cómo compensar lo que mida), y hasta aquí es un número que apareció porque las proyecciones de la lección anterior tenían que salir a alguna anchura.
Hay una segunda cosa que esta capa no sabe hacer, y apunta al mismo sitio. Una fila de es un reparto y sólo uno: en las llaves del coche están ahí, la posición de están tiene que decidir con un único juego de pesos si mira a llaves, que es con quien concuerda, o a del coche, que es lo que la separa de ella; y con una fila no puede hacer las dos cosas. La respuesta a las dos preguntas es la misma y ocupa la lección siguiente, sobre la atención multi-head: varias parejas de proyecciones trabajando en paralelo, cada una con su propio reparto y su propia anchura, repartida entre todas a partir de . Ahí deja de ser un número dado y pasa a ser una decisión con un motivo.
Para profundizar1 fuente · 1 paper
De dónde sale lo de esta lección, y dónde seguir si quieres más. Nada de aquí hace falta para continuar el curso.
- Attention Is All You Need
Su §3.2.1 y su nota al pie 4 son esta lección en dos frases: con q y k de media 0 y varianza 1, q·k tiene varianza d_k, y de ahí √d_k. No llega a la saturación del softmax ni al gradiente que se apaga; eso es tuyo.